Amazon Bedrockを使い始めたら、早い段階で検討したい設定がModel invocation loggingです。モデルへ渡された入力、返された出力、使用トークン数を記録できるため、障害調査とコスト分析の手掛かりになります。
Bedrockをアプリケーションやバッチ処理から利用すると、複数の利用者や処理が異なるモデルを呼び出します。想定外の回答や料金増加が発生したとき、合計使用量だけでは原因となった呼び出しを特定できません。Model invocation loggingを有効にしておけば、どの入力に対して何が返り、何トークン使われたかを呼び出し単位で調べられます。
Model invocation loggingは、Amazon Bedrock Runtimeを経由したモデル呼び出しの内容を記録する機能です。公式ドキュメントでは、Converse、ConverseStream、InvokeModel、InvokeModelWithResponseStreamが記録対象として挙げられています。
ログには、次の情報が含まれます。
| フィールド | 確認できる内容 |
|---|---|
| timestamp | モデルが呼び出された時刻 |
| operation | ConverseやInvokeModelなどのAPI操作 |
| modelId | 呼び出されたモデルまたは推論プロファイル |
| identity.arn | 呼び出しに使用されたIAMまたはSTSのARN |
| input.inputBodyJson | モデルへ送信された入力 |
| input.inputTokenCount | 入力トークン数 |
| output.outputBodyJson | モデルが返した出力 |
| output.outputTokenCount | 出力トークン数 |
Model invocation loggingの仕様では、入力と出力のJSON本文は100KBまでログイベントへ格納されます。100KBを超える本文や画像などのバイナリデータは、S3を設定している場合に別オブジェクトとして保存されます。そのため、短いテキストの確認にはCloudWatch Logs、容量の大きな入出力を含む調査にはS3が向いています。
ログの保存先は、CloudWatch LogsとS3のどちらか一方に限定されません。CloudWatch Logsだけ、S3だけに加え、両方を同時に設定できます。CloudWatch Logsを使う場合は、100KBを超える入出力を切り捨てるか、大容量データの配信先としてS3を設定するかも選べます。
CloudWatch Logsでは、モデルID、呼び出し元、トークン数などをCloudWatch Logs Insightsで絞り込めます。同期直後の調査や特定のIAMロールによる使用量の集計に適しています。
S3にはgzip圧縮されたJSONが配信されます。長期間保存してAmazon Athenaで集計する場合や、100KBを超える入出力を調べる場合は、S3が適しています。
両方を設定すれば、CloudWatch Logsで直近の呼び出しを検索しながら、S3へログを保存して長期的に分析できます。調査のしやすさと保存期間の要件に応じて組み合わせます。
Amazon Bedrockコンソールの「設定」を開き、「モデル呼び出しのログ記録」を有効にします。続いて、ログに含めるデータタイプと保存先を選びます。
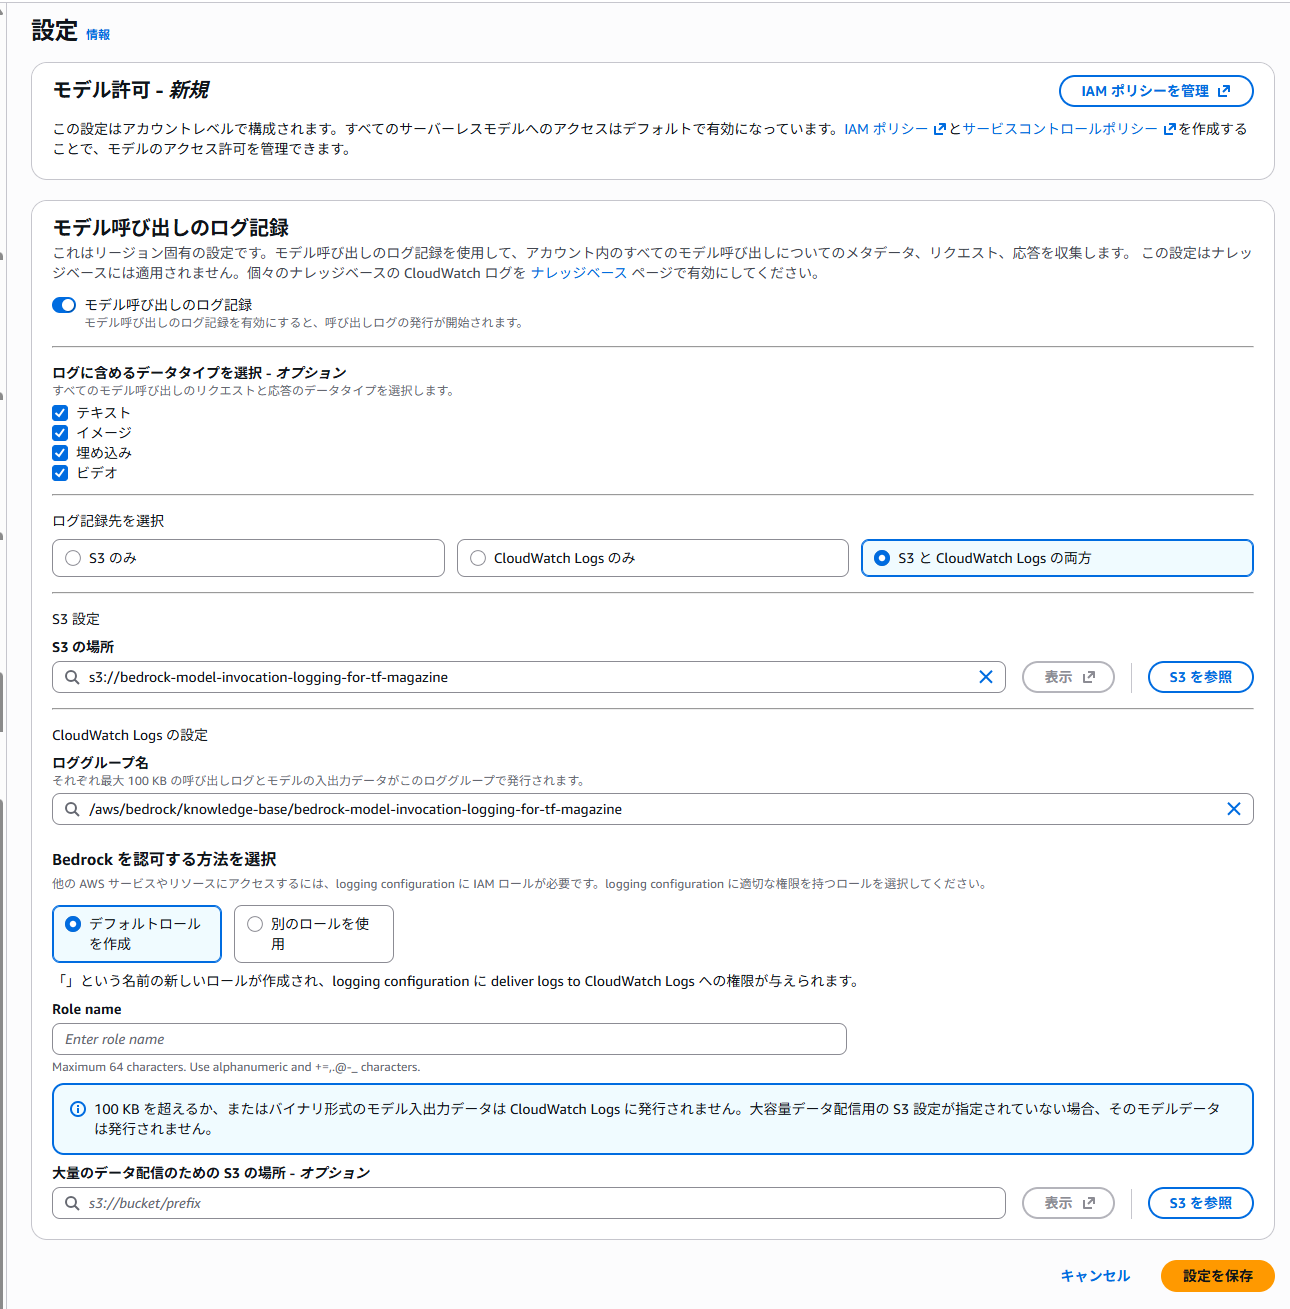
設定はリージョン単位です。保存先には、Amazon Bedrockと同じAWSアカウントおよびリージョンにあるS3バケットとCloudWatch Logsのロググループを指定します。
テキストだけでなく埋め込みモデルの呼び出しも調べる場合は、記録対象のモダリティでEmbeddingを有効にします。画像を含む文書を扱う場合はImageも記録対象に加え、大容量データの配信先としてS3を設定します。
ログを調べるときは、呼び出し時刻に加えてmodelIdとidentity.arnを確認します。これにより、どのモデルを、どのIAMプリンシパルが呼び出したかを絞り込めます。複数のアプリケーションで同じAWSアカウントを使う場合も、実行ロールを分けておくと呼び出し元を特定しやすくなります。
CloudWatch Logsへ出力する場合、呼び出しログは指定したロググループ内のaws/bedrock/modelinvocationsログストリームに保存されます。設定直後には、Amazon Bedrockがログを書き込めることを確認する権限確認メッセージが記録される場合があります。その後に並ぶJSON形式のログイベントは、1件が1回のモデル呼び出しに対応します。
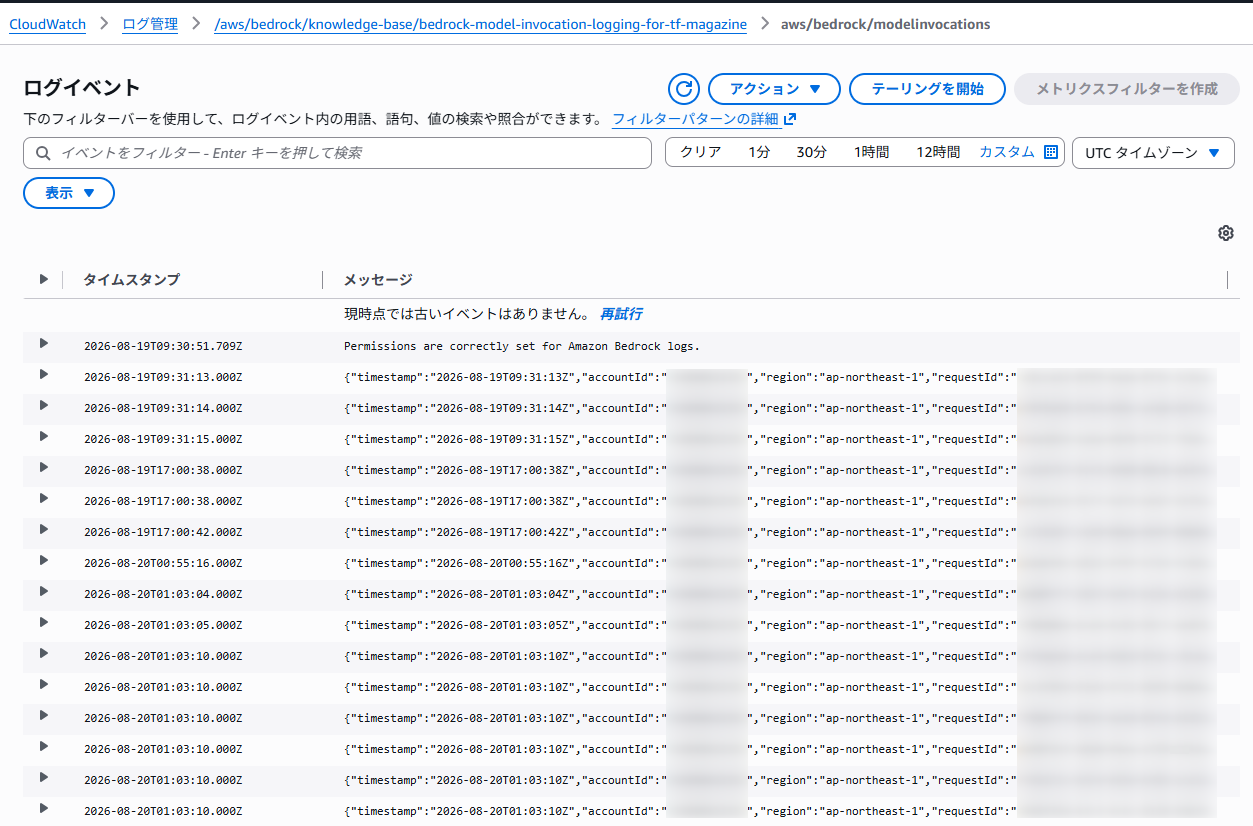
対象のログを見つけたら、API操作、リクエスト、レスポンス、入出力トークン数を確認します。回答が想定と異なる場合は、実際に送信された入力と返された出力を確認します。料金を概算する場合は、モデルID、リージョン、入出力トークン数を現在の単価と照合します。プロンプトキャッシュを使っている場合は、キャッシュの読み書きに使われたトークン数も区別します。
Converse APIのログは、たとえば次のようなJSON構造です。呼び出し単位の集計には、共通フィールドのinput.inputTokenCountとoutput.outputTokenCountを使います。この例では、output.outputBodyJson.usageから合計トークン数とキャッシュの内訳も確認できます。ただし、usage.inputTokensとusage.outputTokensは上位のトークン数と重複するため、両方を加算しません。outputBodyJsonの構造はAPI操作やモデルによって異なります。
{
    "timestamp": "2026-08-19T09:31:15Z",
    "accountId": "123456789012",
    "region": "ap-northeast-1",
    "requestId": "00000000-0000-4000-8000-000000000000",
    "operation": "Converse",
    "modelId": "jp.anthropic.claude-sonnet-4-6",
    "input": {
        "inputContentType": "application/json",
        "inputBodyJson": {
            "messages": [
                {
                    "role": "user",
                    "content": [
                        {
                            "text": "生成AIについて簡単に教えてください"
                        }
                    ]
                }
            ]
        },
        "inputTokenCount": 6251,
        "cacheReadInputTokenCount": 0,
        "cacheWriteInputTokenCount": 0
    },
    "output": {
        "outputContentType": "application/json",
        "outputBodyJson": {
            "output": {
                "message": {
                    "role": "assistant",
                    "content": [
                        {
                            "text": "...略..."
                        }
                    ]
                }
            },
            "stopReason": "end_turn",
            "metrics": {
                "latencyMs": 10257
            },
            "usage": {
                "inputTokens": 6251,
                "cacheReadInputTokens": 0,
                "cacheWriteInputTokens": 0,
                "outputTokens": 528,
                "totalTokens": 6779
            }
        },
        "outputTokenCount": 528
    },
    "identity": {
        "arn": "arn:aws:sts::123456789012:assumed-role/..."
    },
    "inferenceRegion": "ap-northeast-1",
    "schemaType": "ModelInvocationLog",
    "schemaVersion": "1.0"
}
S3側では、配信された呼び出しログに加え、CloudWatch Logsへ発行されなかった100KB超またはバイナリ形式の入出力を確認できます。ログイベントの参照情報とS3オブジェクトを対応付けると、どの呼び出しで大容量データが使われたかを追跡できます。
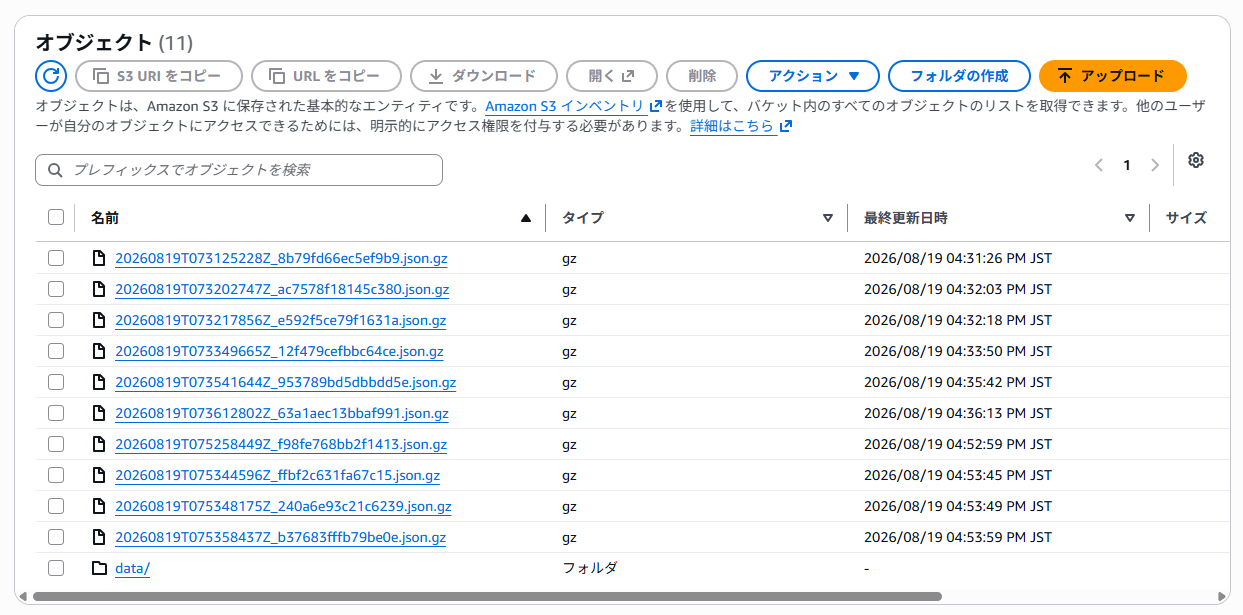
今回の検証では、呼び出しログが次のプレフィックスへ時間単位で保存されました。S3の設定時にプレフィックスを指定していない場合は、バケット直下のAWSLogsから始まります。
s3://<バケット名>/<指定プレフィックス>/AWSLogs/<AWSアカウントID>/BedrockModelInvocationLogs/<リージョン>/YYYY/MM/DD/HH/
このプレフィックスには、複数の呼び出しログをまとめたgzip圧縮済みのJSONファイルが配置されます。Converse APIへ画像や文書を渡した場合や、入出力がバイナリ形式または100KBを超える場合は、対象データがdata/配下の別オブジェクトとして保存され、呼び出しログにはその参照先が記録されます。
Knowledge Basesの同期では、文書の解析、チャンク分割、埋め込み生成、ベクトルストアへの保存が進みます。今回の検証では、埋め込み生成時にAmazon Titan Text Embeddings V2を呼び出したログが記録されました。ログから、507トークンのチャンクが入力され、1,024次元のベクトルが生成されたことを確認できます。
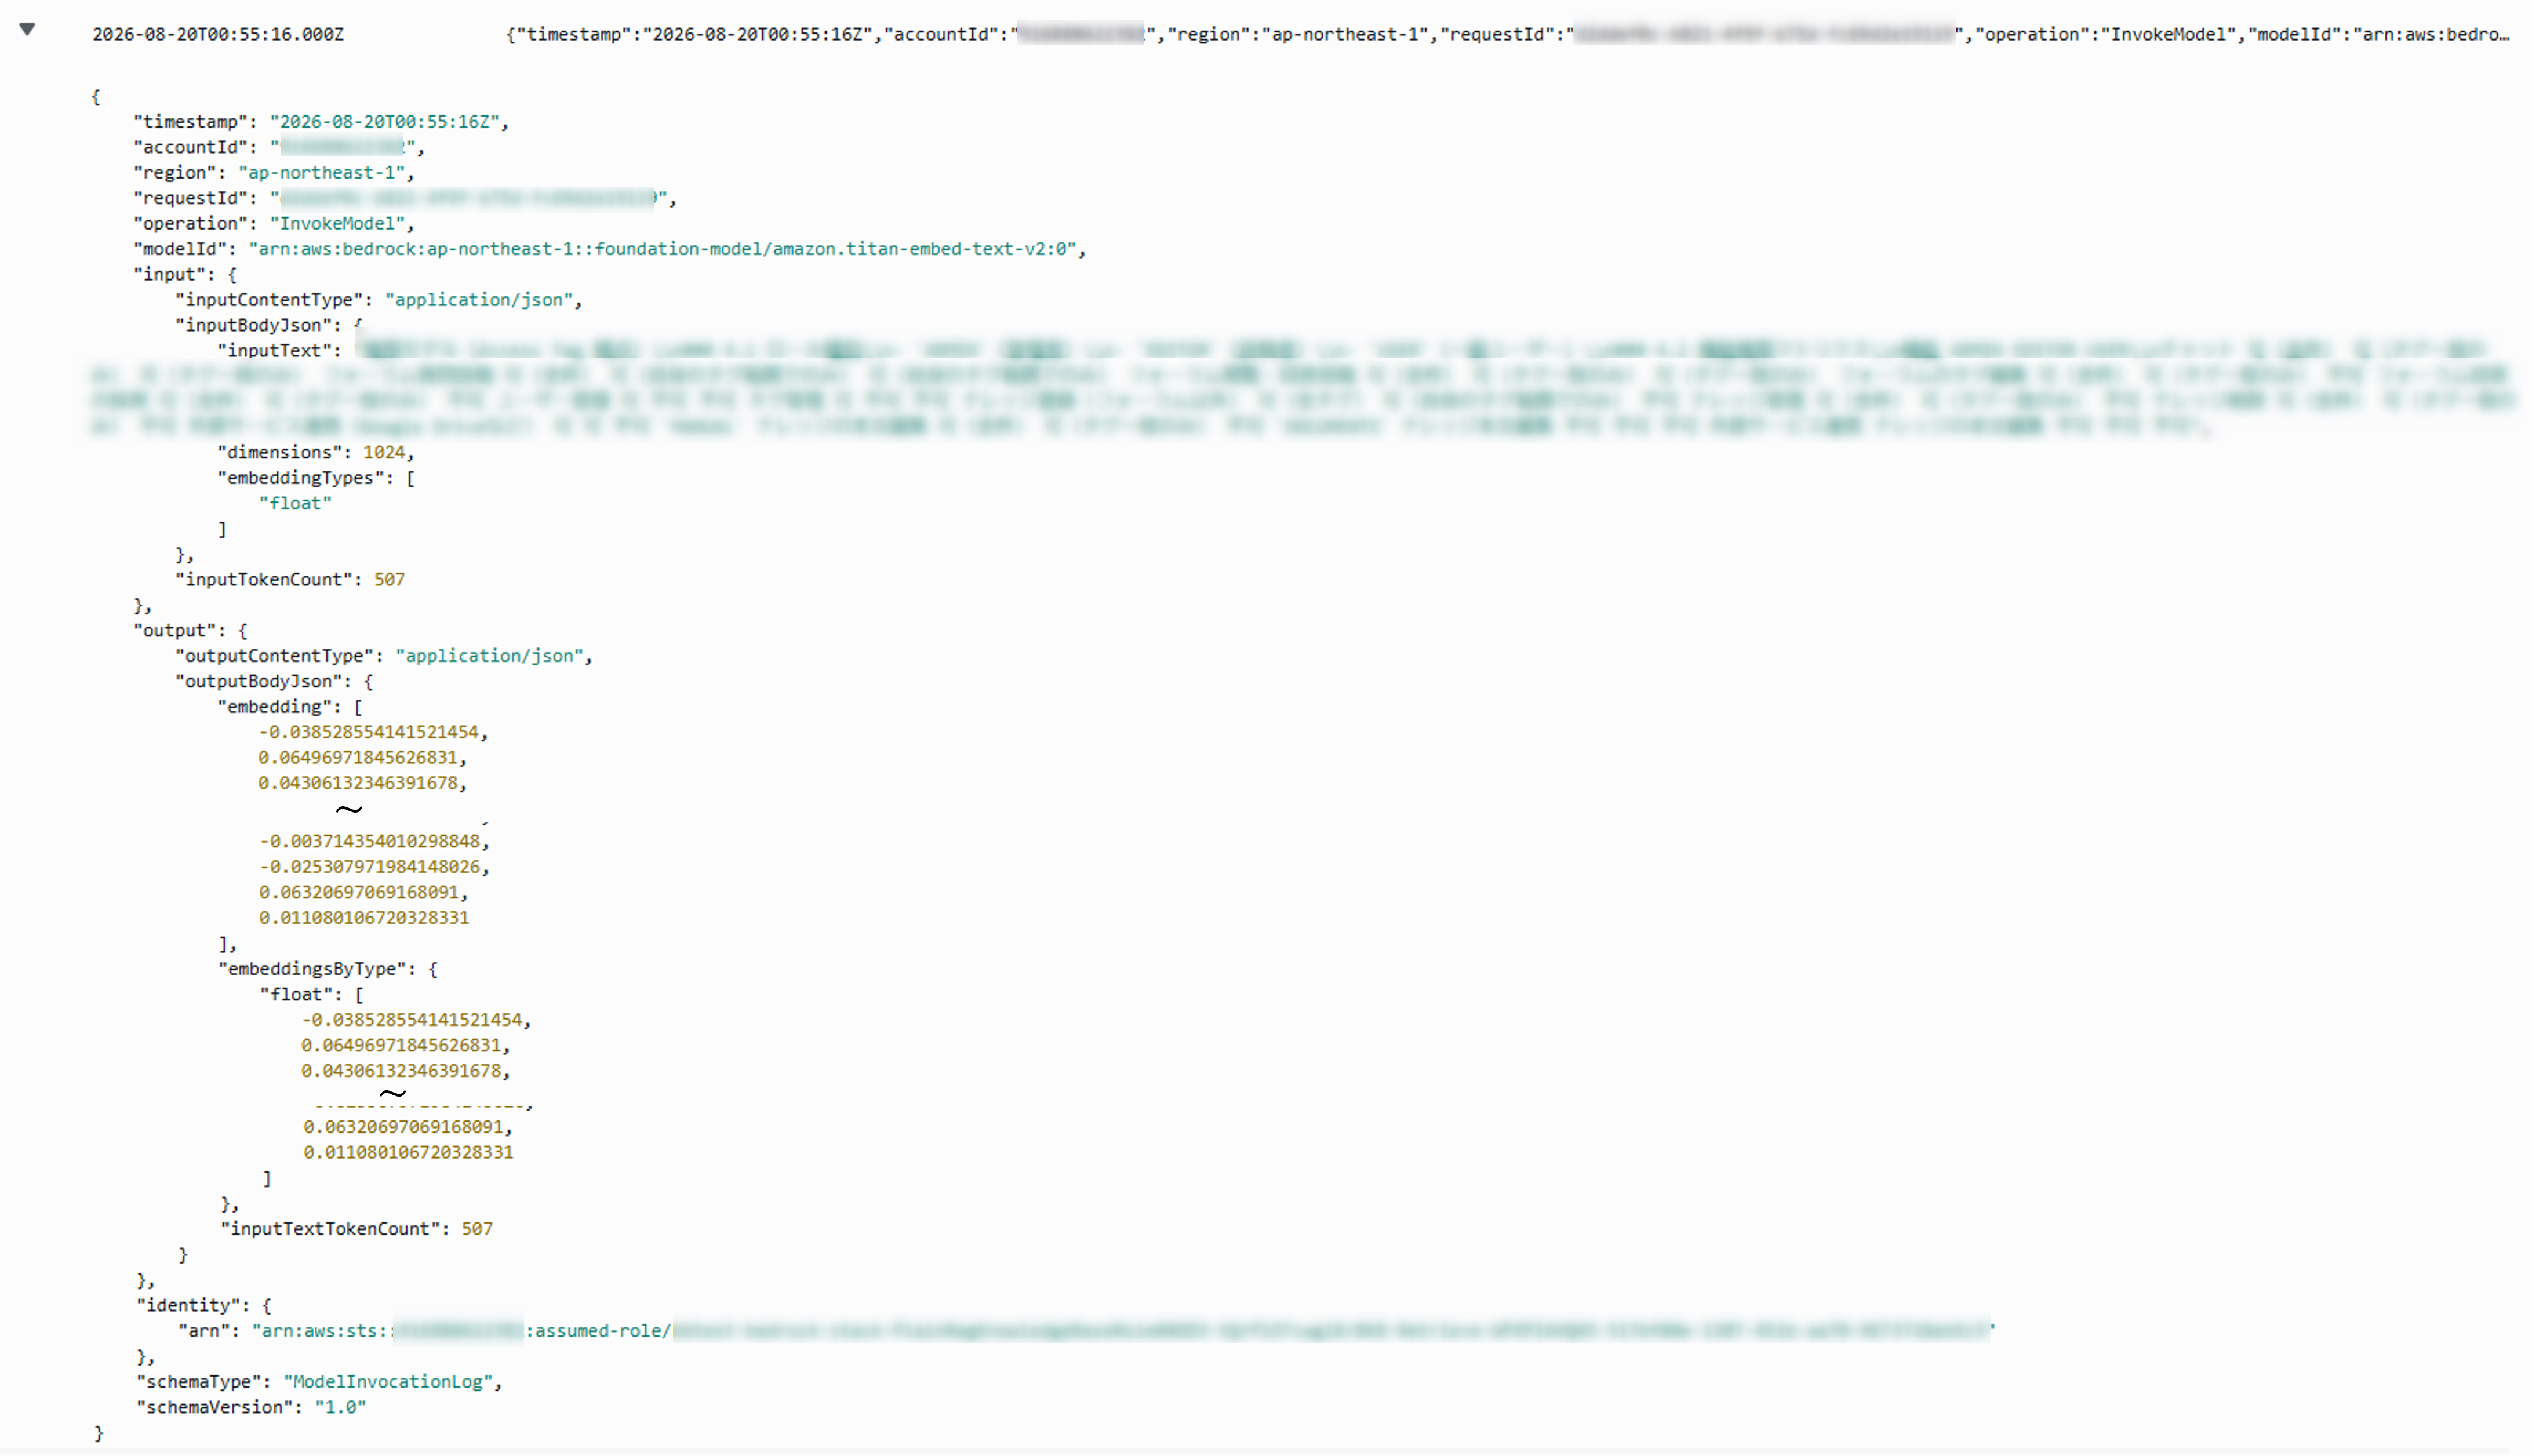
AWS公式ブログでも、Knowledge Basesの作成時と検索時に埋め込みモデルが使用したトークン数をCloudWatchで可視化する例が紹介されています。
Model invocation loggingを有効にしても、モデル推論そのものの料金体系は変わりません。ただし、記録したデータの取り込みと保存には、CloudWatch LogsやS3など保存先サービスの料金が発生します。
コストは、次の3層に分けると把握しやすくなります。
| コスト | 主な料金単位 | 確認先 |
|---|---|---|
| モデル推論 | 入力・出力トークンなど | Amazon Bedrockのモデル別料金 |
| 埋め込みなどの処理 | モデルごとの入力単位 | Amazon Bedrockのモデル別料金 |
| ログの保存・分析 | 取り込み量、保存量、クエリ量 | CloudWatch Logs、S3、Athenaの料金 |
トークン単価を固定値で掲載すると、料金改定によって記事の内容が古くなります。そのため、公開時点のAmazon Bedrock料金ページを参照し、ログのinputTokenCountとoutputTokenCountから計算する方法を示します。ログ保存についても、Amazon CloudWatch料金とAmazon S3料金を参照してください。
ログは継続的に増えるため、保存先を作成する時点で保管期間も決めておきます。CloudWatch Logsではロググループの保持期間を設定し、S3ではライフサイクルルールを使って、一定期間後のストレージクラス移行や削除を設定します。障害調査や監査に必要な期間を基準にすれば、不要なログを無期限に保存せずに済みます。
モデル呼び出しログには、利用者が入力した文章やモデルの回答が含まれます。Knowledge Basesなどサービス側がモデルを呼び出す処理では、登録した文書の内容が記録される場合もあります。障害調査に有用である一方、保存する情報の機密性は上がります。
本番環境で有効にする前に、ログへアクセスできるIAMプリンシパルを限定します。併せて、CloudWatch LogsとS3の暗号化、監査方法を決め、前節で設定した保管期間が機密性や監査の要件を満たすか確認します。ログへ残せるデータの基準が定まっていなければ、まず検証環境で記録内容を確認します。
Model invocation loggingは初期状態で無効です。有効化するかどうかは、調査で得られる情報と、保存によって増える管理負荷の両面から判断します。
Model invocation loggingを有効にすると、Amazon Bedrockのモデル入出力、呼び出し元、トークン使用量を呼び出し単位で確認できます。通常のモデル推論だけでなく、Knowledge Basesなどサービス側が行うモデル呼び出しも、ログへ記録された範囲で調査できます。
ただし、ログには文書本文やモデルの出力が含まれます。有効化する際は、保存先の料金、アクセス制御、暗号化、保持期間まで含めて設計することが重要です。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。