生成AI関連
生成AIのSkillsとは?仕組み・MCPやカスタム指示との違い・デモまで
Agent Skillsは、生成AIエージェントに専門知識や作業手順を追加し、繰り返し使えるようにする仕組みです。しかし、SKILL.mdを用意しただけで、そのSkillが継続的に使われるとは限りません。
使ってほしい場面でエージェントがSkillを選ばなかったり、選んでも途中の手順を飛ばしたりすることがあります。作成者の環境では問題なく動いても、別のエージェントやOSでは動かないこともあります。
2026年8月9日、「What Keeps Agent Skills from Being Reusable? Evidence from 138K SKILL.md Files」という研究が公開されました。一般に公開されている138,133件のSKILL.mdを分析した論文です。そのうち91.8%のファイルで、問題候補が少なくとも1件見つかったと報告されています。目を引く数字ですが、「91.8%のSkillが動作しない」という意味ではありません。研究チームが定めた31項目の静的チェックのうち、1件以上に該当したファイルの割合です。
本記事では、この研究を紹介したうえで、「Tech Fun Magazineの記事企画Skill」を実際に3段階で作成します。descriptionが曖昧なSkill、descriptionだけを改善したSkill、本文と関連リソースまで整えたSkillを並べて比較し、どこを見ればよいのかを具体的に示します。
Agent Skillsの基本的な仕組みを先に確認したい方は、次の記事をご覧ください。
Skillを作る手順から知りたい方は、チュートリアル記事も参考になります。
研究チームはGitHubの公開リポジトリとAgent Skillsのレジストリから138,133件のSKILL.mdを集め、SHA-256で重複を除いてから分析しました。対象となったリポジトリは20,556件です。
分析に使われたのは、公式仕様に沿った14項目と、セキュリティやソフトウェアの移植性に関する知見から立てた17項目、合わせて31項目の検出ルールです。主な結果は次のとおりです。
| 結果 | 割合・件数 | 読み方 |
|---|---|---|
| いずれかの検出項目に該当 | 91.8% | 31項目の静的チェックで1件以上を検出 |
| 公式仕様由来の検出項目に該当 | 89.3% | 公式仕様に由来する14項目のいずれかを検出 |
| ルーティング関連の検出項目に該当 | 67.0% | Skillの発見・選択に関係する問題候補を検出 |
| trigger guidanceがdescriptionにない | 52.3% | いつ使うかを判断しにくいdescription |
| nameをH1見出しでも繰り返す | 44.3% | 研究チームの重複コンテンツ検出ルールに該当 |
| inline exampleが多すぎる | 32.1% | 研究チームのリソース分離ルールに該当 |
31項目は、Skillが再利用されるまでの流れに沿って、7つのカテゴリに整理されています。
| カテゴリ | 確認対象 | 代表的な問題候補 |
|---|---|---|
| Routing Metadata | Skillを見つけられるか | descriptionが短い、利用場面がない、routing情報が本文だけにある |
| Body Content | 本文が実行可能な指示になっているか | 本文が長すぎる、説明が多い、メタデータと重複する |
| Resource Organization | 情報が適切に分離されているか | コードや例を本文へ詰め込み、referencesやscriptsを使わない |
| Prohibited Content | 再利用に不要な情報がないか | インストール手順、変更履歴、TODOなどが本文に残る |
| Behavioral Safety | 危険な実行を誘発しないか | 認証情報、破壊的コマンド、安全機構の回避が含まれる |
| Portability | 別の環境へ移せるか | 固定モデル名、ユーザー固有パス、OS固有コマンドに依存する |
| Persona & Scope | 上位指示と衝突しないか | エージェントの人格を再定義し、既存の指示を上書きする |
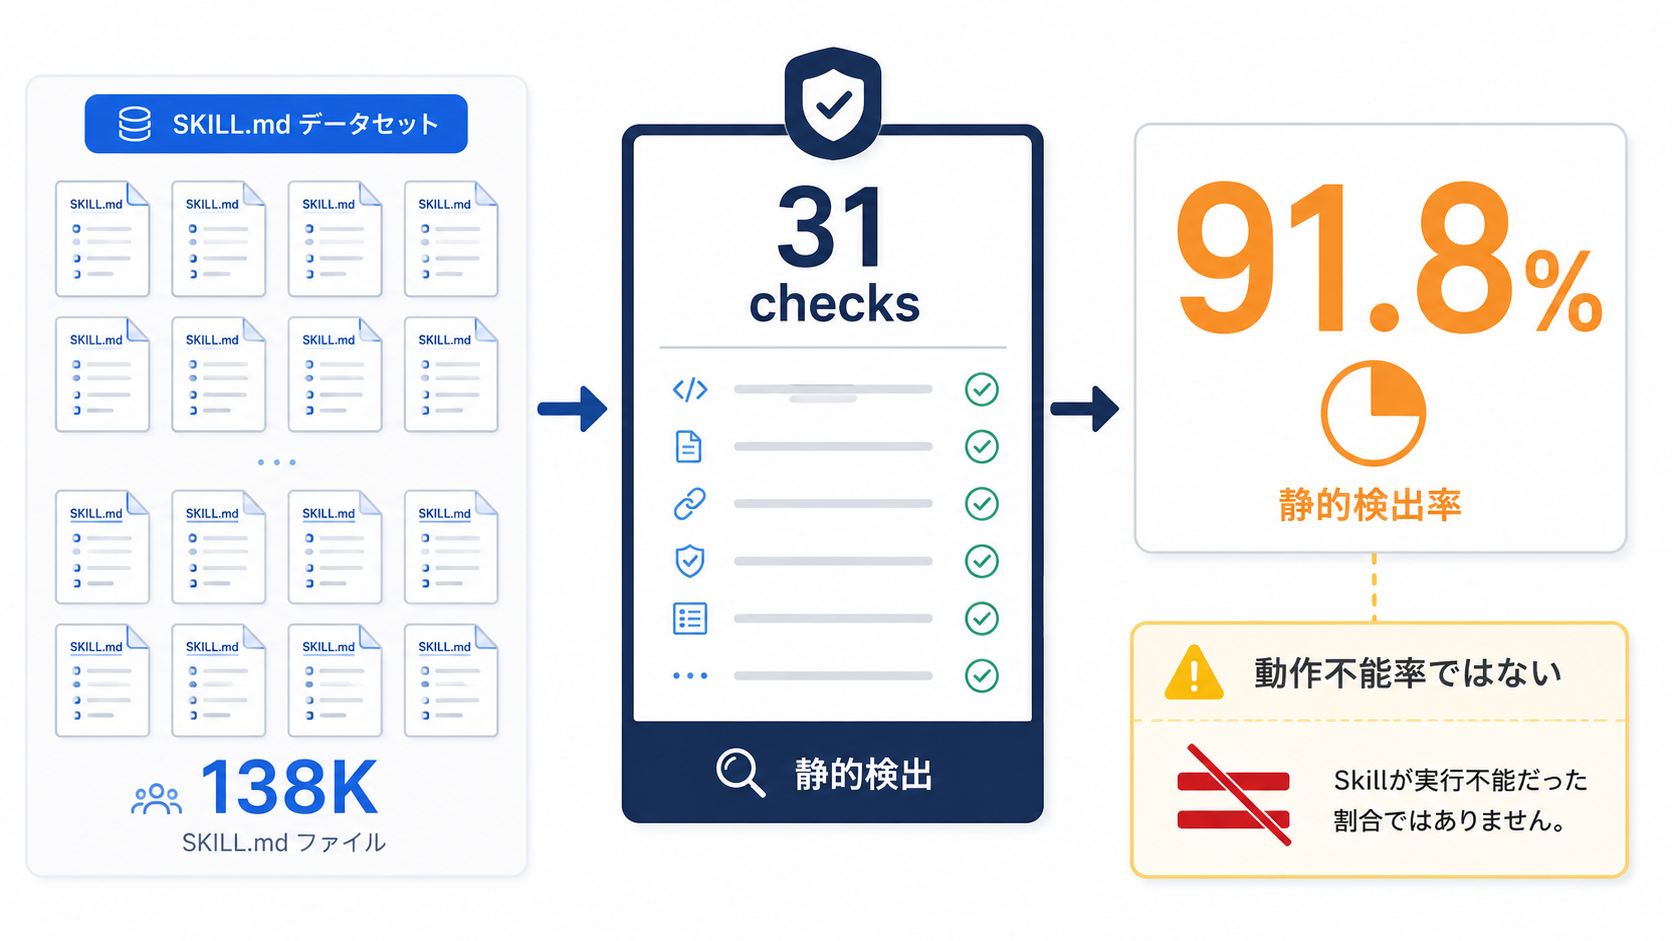
この研究は、公開されているSkillの品質傾向をつかむ材料として役立ちます。ただし、検出された件数を実行時の失敗の数として読むのは行き過ぎです。
研究チーム自身も、検出件数は静的分析による所見であって、タスク実行時の失敗を直接示すものではないと述べています。意図してそう書いた箇所が、検出ルールに引っかかることもあります。分析の対象も公開リポジトリとレジストリに限られるので、社内で管理している非公開のSkillが同じ比率になるかどうかは分かりません。
この数値を引用するなら、少なくとも次の前提もあわせて示すべきです。
研究チームは閾値を変えた感度分析も行っており、検出率は88.8%から94.6%の範囲に収まりました。数値が多少動いても、多くの公開Skillに改善の余地があるという傾向自体は変わりません。
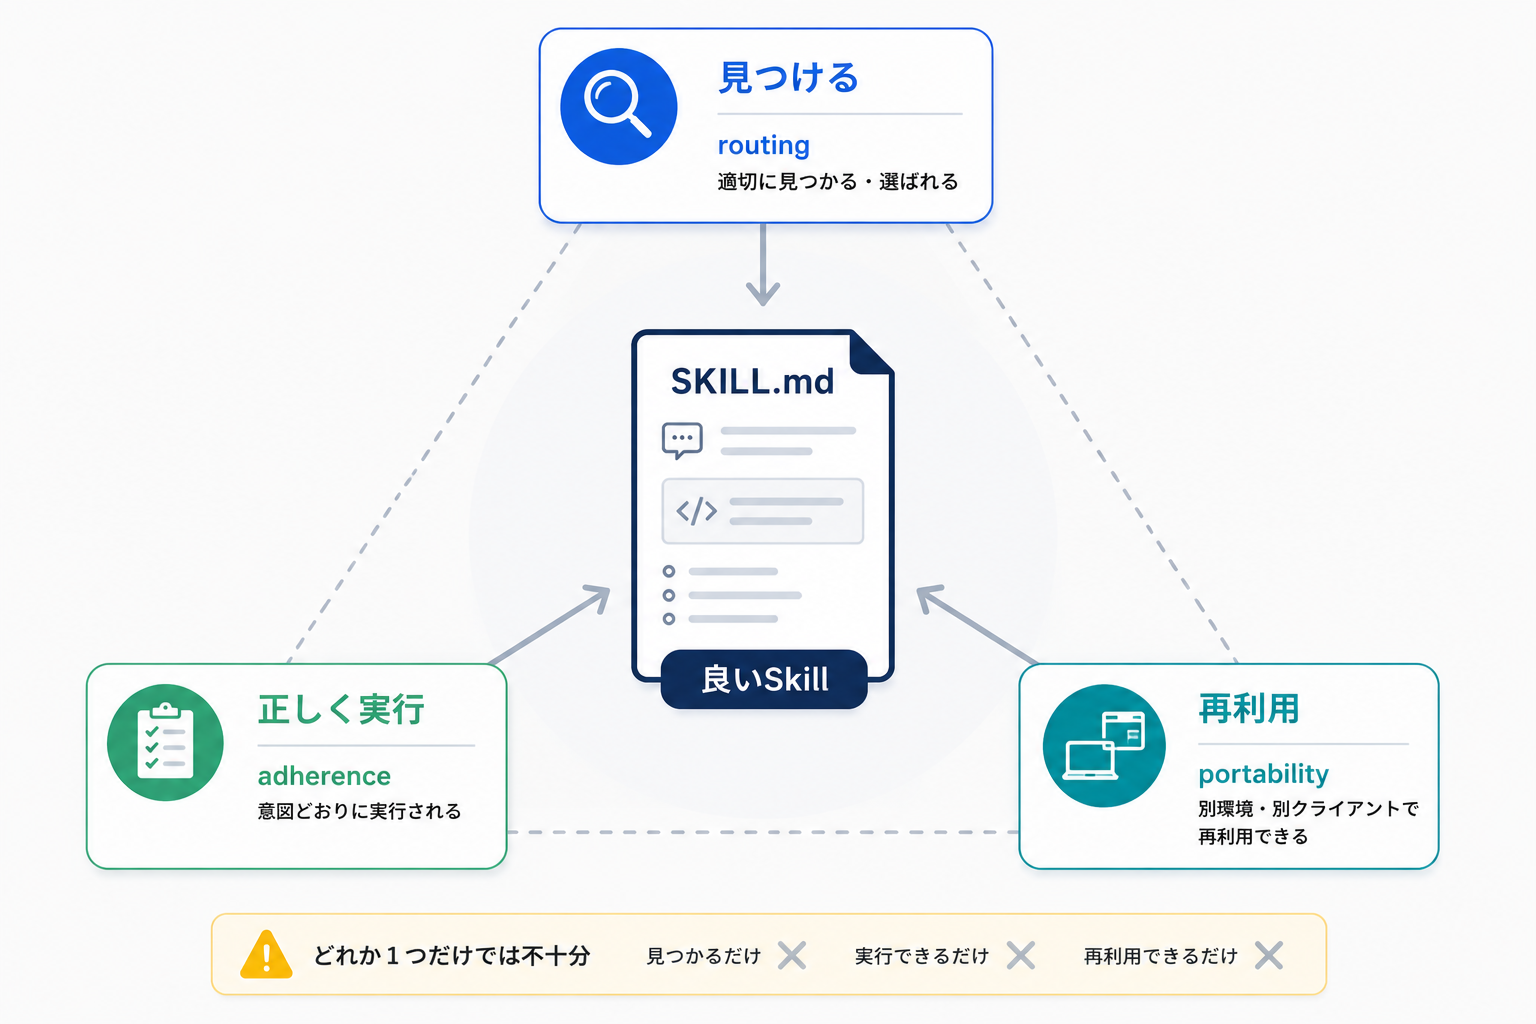
Skillの品質をSKILL.mdの文章だけで測ろうとすると、肝心な点を見落とします。実務で使うSkillに必要な条件は、次の3つです。
| 条件 | 問い | 主に設計する場所 |
|---|---|---|
| 見つけられる | 必要な依頼で選ばれ、不要な依頼では選ばれないか | name、description、評価用プロンプト |
| 正しく実行できる | 必要な手順を省略せず、出力を検証できるか | SKILL.md本文、チェックリスト、validation、scripts |
| 別環境でも再利用できる | 作成者以外の環境や別クライアントで動作するか | 相対パス、依存関係の明示、標準仕様への準拠、互換性の記載 |
エージェントがSkillの存在を知っていても、目の前の依頼と結びつかなければ、そのSkillは読み込まれません。逆にdescriptionの対象範囲が広すぎると、英訳やメールの添削のような無関係な依頼でも呼び出されてしまいます。
呼んでほしい依頼で呼ばれるか、呼んでほしくない依頼で呼ばれずに済むか。この両方をあわせて評価します。
Skillが自動で選ばれたとしても、それで作業が終わったわけではありません。GSC、既存記事、ニュースの順に調べるよう書いてあっても、途中の資料が飛ばされることがあります。最終的な回答はもっともらしく読めるのに、根拠を照らし合わせる工程や検証の工程が抜け落ちている、ということも起こります。
工程がいくつもある処理では、手順、完了条件、検証方法を分けて書いておきます。
個人の環境を前提にした絶対パスや、あるOSにしかないコマンド、決め打ちしたモデル名に頼っていると、Skillを使える環境が狭まります。Agent Skillsはオープンな形式ですが、Skillの置き場所やクライアント独自の拡張項目は製品ごとに違います。
共通部分はAgent Skillsの仕様に沿わせ、製品固有の設定を切り分けておくと、再利用しやすくなります。
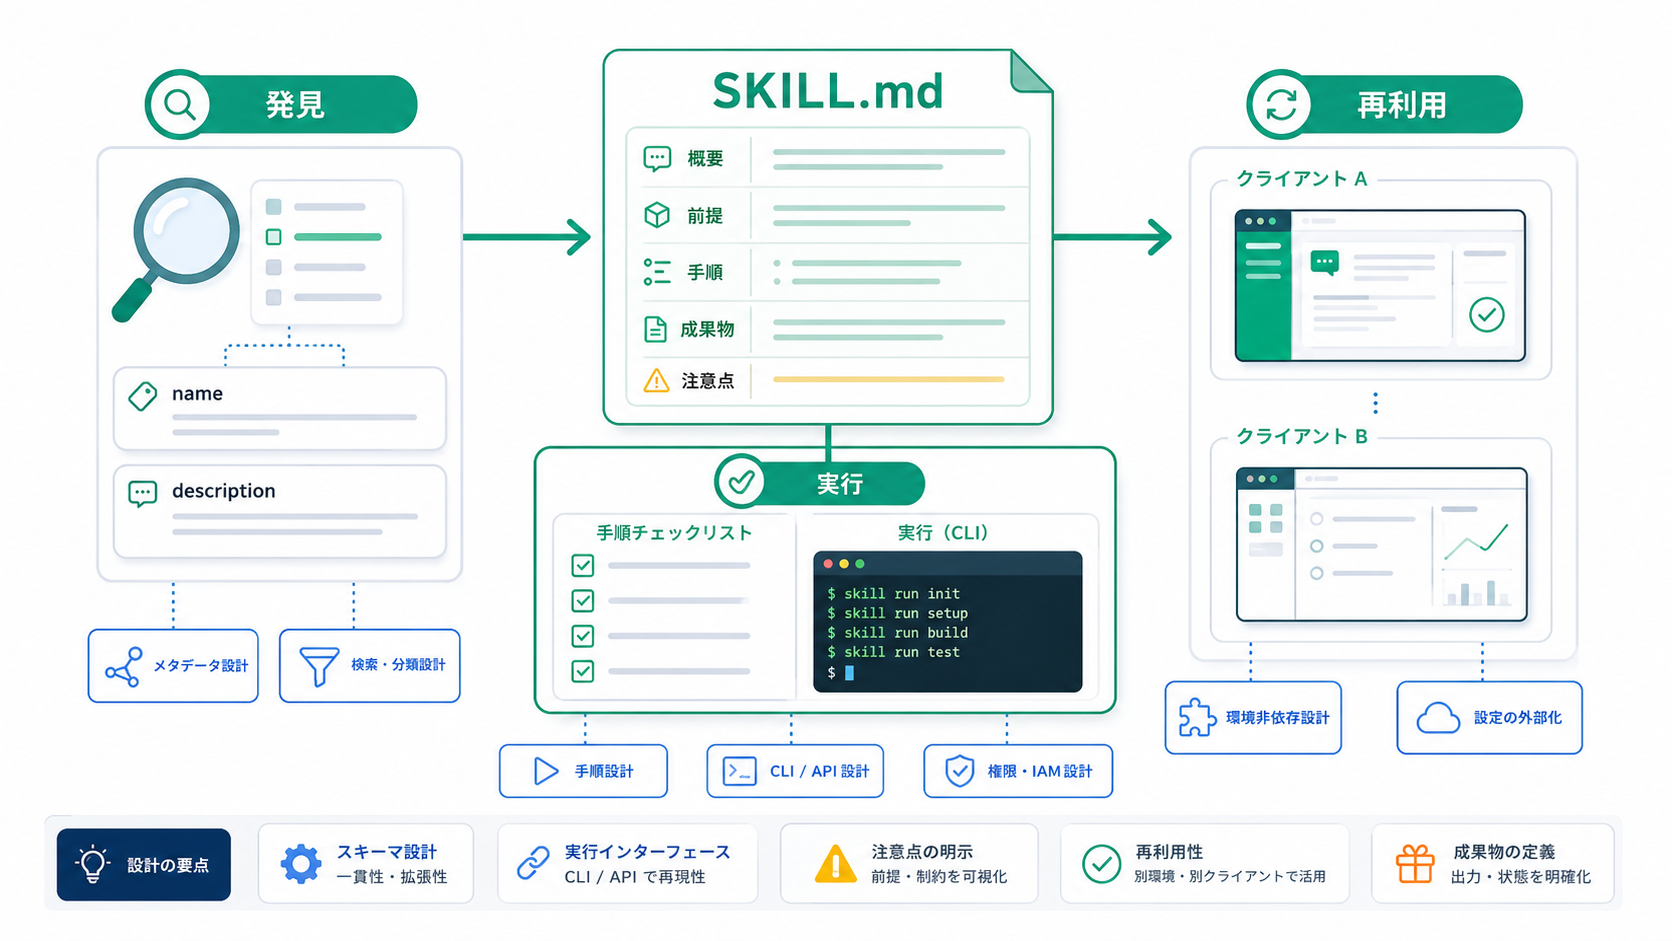
Agent Skillsでは、起動時にすべてのSKILL.md本文が読み込まれるわけではありません。Agent Skillsの公式仕様は、情報を3段階に分けて読み込む仕組みを説明しています。これをProgressive Disclosureと呼びます。
| 段階 | 読み込まれる情報 | 目安・タイミング |
|---|---|---|
| 1. Metadata | nameとdescription | 起動時に全Skill分を読み込む |
| 2. Instructions | SKILL.md本文 | Skillが選択された後に読み込む |
| 3. Resources | references/、scripts/、assets/ | 必要なときだけ読む、または実行する |
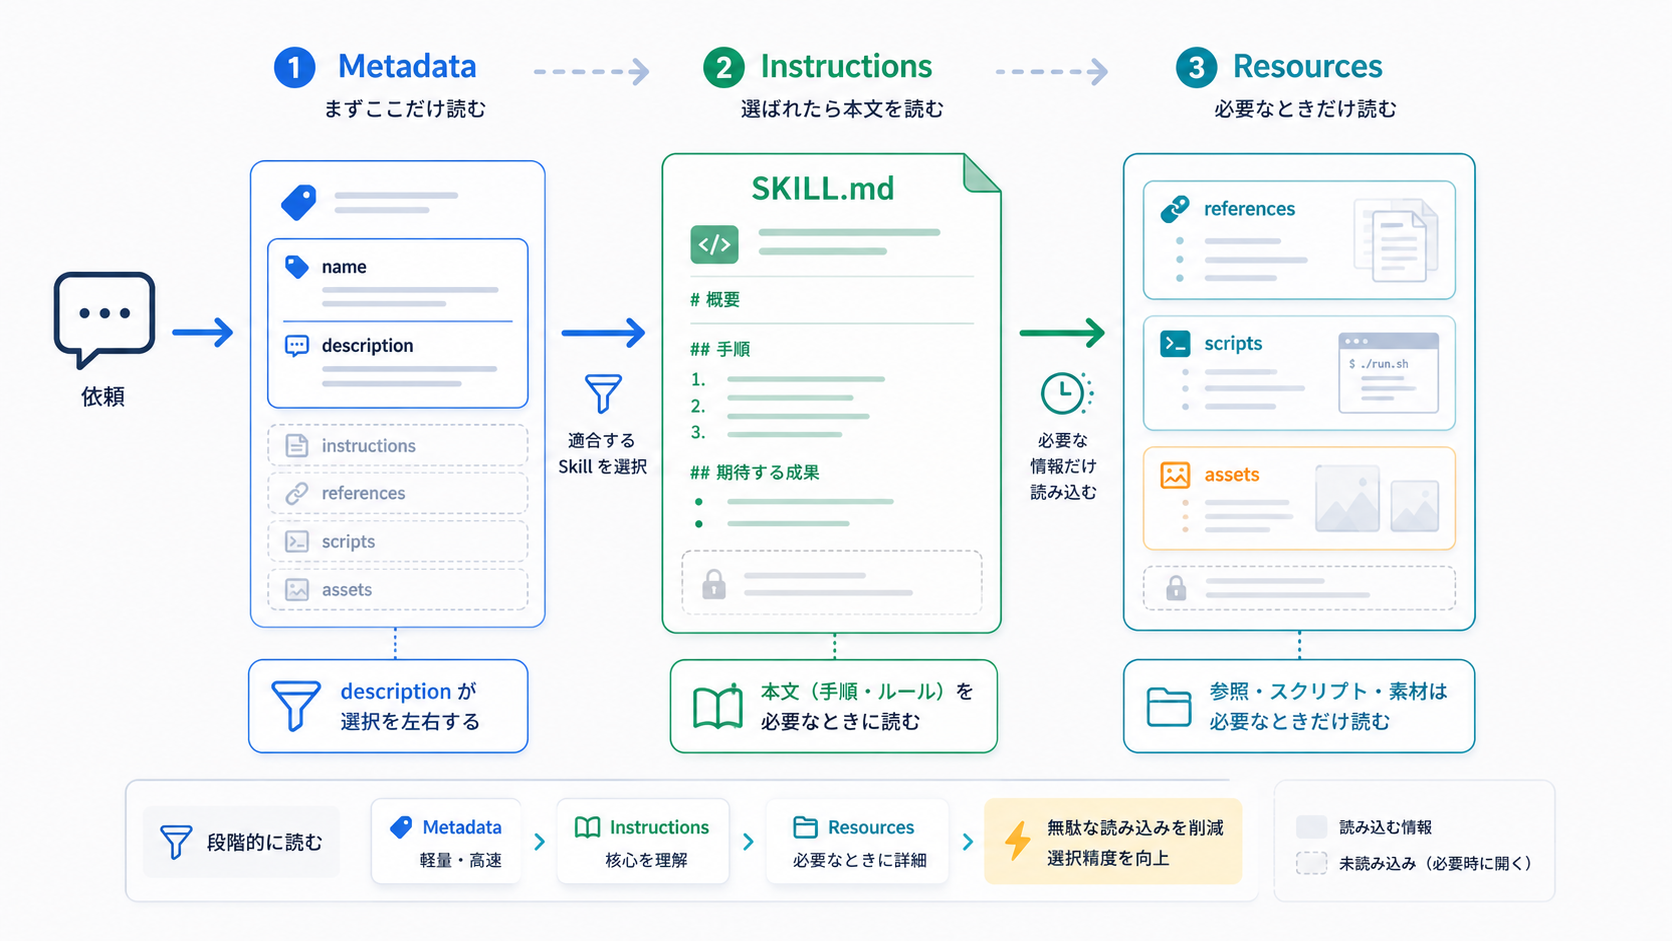
この仕組みのもとでは、どれだけ詳しい手順を本文に書いても、descriptionから用途が読み取れなければ、そこまでたどり着いてもらえません。
Agent Skillsのdescription最適化ガイドは、Skillを呼ぶかどうかの判断は主にdescriptionで決まると説明しています。公式仕様も、何をするSkillなのかに加えていつ使うのかを書き、近いタスクと見分けられる具体的なキーワードを入れるよう求めています。
次の2つを比較します。
| 書き方 | description | 判断しやすさ |
|---|---|---|
| 曖昧 | Tech Fun Magazineの記事企画を支援します。 | 目的は分かるが、入力資料や利用場面が不明確 |
| 改善 | Tech Fun Magazineの次回記事テーマを企画する。GSC、既存記事、生成AIニュースを分析して候補を提案する。「次の記事」「来週の記事」などを相談されたときに使用する。 | 何をするか、いつ使うか、どんな言葉で相談されるかが分かる |
といっても、トリガーになるキーワードをただ増やせばよいという話ではありません。descriptionが長くなると、複数のSkillが並ぶ起動時のコンテキストを圧迫します。なお上限は、現在の公式仕様では1,024文字と決まっています。OpenAIのBuild skillsも、主な用途とトリガーワードを前半に置き、何を対象にして何を対象にしないのかを簡潔に書くよう勧めています。
効いてくるのは文章の長さではありません。利用者が実際に打ち込む依頼文と、descriptionに並べた言葉がどれだけ重なっているかです。
ここからは、Tech Fun Magazineの記事企画を題材に、同じ目的のSkillを3段階で作成します。入力に使うのはGSCアクセスレポート、既存記事一覧、調査済みの生成AIニュースで、出力は次回記事の候補3件と推奨案です。
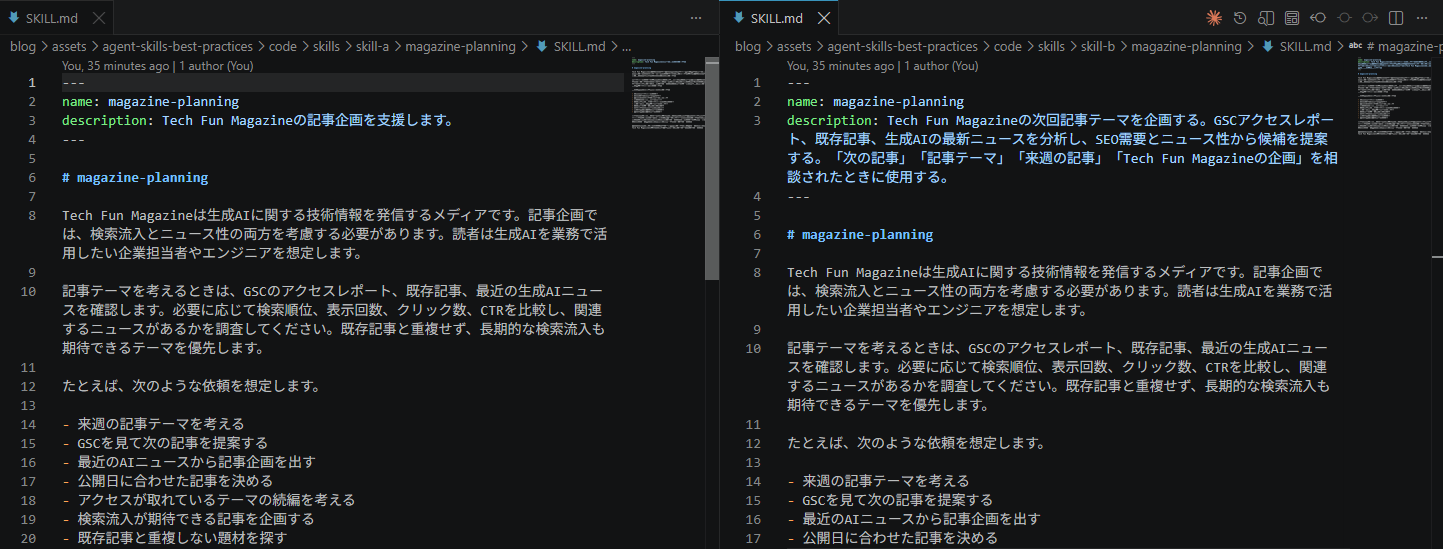
Skill Aはdescriptionが短く、背景、利用例、判断基準、出力条件が本文に全部入っています。研究で指摘された「trigger guidanceの不足」「nameをH1で繰り返す」「本文への詰め込み」を、あえて残しています。
---
name: magazine-planning
description: Tech Fun Magazineの記事企画を支援します。
---

# magazine-planning

Tech Fun Magazineは生成AIに関する技術情報を発信するメディアです。記事企画では、検索流入とニュース性の両方を考慮する必要があります。読者は生成AIを業務で活用したい企業担当者やエンジニアを想定します。

記事テーマを考えるときは、GSCのアクセスレポート、既存記事、最近の生成AIニュースを確認します。必要に応じて検索順位、表示回数、クリック数、CTRを比較し、関連するニュースがあるかを調査してください。既存記事と重複せず、長期的な検索流入も期待できるテーマを優先します。

たとえば、次のような依頼を想定します。

- 来週の記事テーマを考える
- GSCを見て次の記事を提案する
- 最近のAIニュースから記事企画を出す
- 公開日に合わせた記事を決める
- アクセスが取れているテーマの続編を考える
- 検索流入が期待できる記事を企画する
- 既存記事と重複しない題材を探す
- ニュースを解説記事へ発展させる
- 初心者向けの生成AI記事を考える
- 技術者向けの実践記事を考える

回答には、候補のタイトル、想定読者、企画意図、SEO上の根拠、ニュース上の根拠を含めます。候補は3件程度を基本とし、最も推奨するものを明確にします。必要なデータが見つからない場合は、その旨を説明してください。企画を考えるときは、一般的な生成AIの知識だけで判断せず、利用可能な資料を確認してください。

最終的には、企画候補を比較しやすい形式で提示します。検索需要だけに偏らず、Tech Fun Magazineの読者にとって実務上の価値があるかも判断してください。
本文まで読めば用途は分かります。しかし、Skillを自動で選ぶときにエージェントが見るのは、冒頭のnameとdescriptionです。「記事企画を支援する」だけでは、どんな資料を使い、何が出てくるのか、利用者がふだん口にする相談の言葉とどう結びつくのかまでは読み取れません。
Skill Bでは、本文はそのままにしてdescriptionだけを書き直します。こうしておけば、呼び出し条件を直した効果と本文を直した効果を切り分けて評価できます。
---
name: magazine-planning
description: Tech Fun Magazineの次回記事テーマを企画する。GSCアクセスレポート、既存記事、生成AIの最新ニュースを分析し、SEO需要とニュース性から候補を提案する。「次の記事」「記事テーマ」「来週の記事」「Tech Fun Magazineの企画」を相談されたときに使用する。
---

# magazine-planning

Tech Fun Magazineは生成AIに関する技術情報を発信するメディアです。記事企画では、検索流入とニュース性の両方を考慮する必要があります。読者は生成AIを業務で活用したい企業担当者やエンジニアを想定します。

記事テーマを考えるときは、GSCのアクセスレポート、既存記事、最近の生成AIニュースを確認します。必要に応じて検索順位、表示回数、クリック数、CTRを比較し、関連するニュースがあるかを調査してください。既存記事と重複せず、長期的な検索流入も期待できるテーマを優先します。

たとえば、次のような依頼を想定します。

- 来週の記事テーマを考える
- GSCを見て次の記事を提案する
- 最近のAIニュースから記事企画を出す
- 公開日に合わせた記事を決める
- アクセスが取れているテーマの続編を考える
- 検索流入が期待できる記事を企画する
- 既存記事と重複しない題材を探す
- ニュースを解説記事へ発展させる
- 初心者向けの生成AI記事を考える
- 技術者向けの実践記事を考える

回答には、候補のタイトル、想定読者、企画意図、SEO上の根拠、ニュース上の根拠を含めます。候補は3件程度を基本とし、最も推奨するものを明確にします。必要なデータが見つからない場合は、その旨を説明してください。企画を考えるときは、一般的な生成AIの知識だけで判断せず、利用可能な資料を確認してください。

最終的には、企画候補を比較しやすい形式で提示します。検索需要だけに偏らず、Tech Fun Magazineの読者にとって実務上の価値があるかも判断してください。
改善版には、目的、入力、判断軸、成果物、利用場面を盛り込みました。ただし本文はSkill Aと同じなので、手順を守るか、リソースを分けるかという問題は手つかずのままです。
Skill Cでは、SKILL.mdに残すものを毎回必要になる手順だけに絞り、編集方針とSEOの判断基準はreferences/へ分けます。毎回同じことを計算するGSC集計は、公式仕様が勧めるscripts/ディレクトリに置きます。
magazine-planning/
├── SKILL.md
├── references/
│   ├── editorial-policy.md
│   └── seo-guidelines.md
└── scripts/
    └── analyze_gsc.py
SKILL.mdは次の内容です。
---
name: magazine-planning
description: Tech Fun Magazineの次回記事テーマを企画する。GSCアクセスレポート、既存記事、生成AIの最新ニュースを分析し、SEO需要とニュース性から候補を提案する。「次の記事」「記事テーマ」「来週の記事」「Tech Fun Magazineの企画」を相談されたときに使用する。
---

## 入力

次の資料を使用する。

- GSCデータ: data/gsc-report.csv
- 既存記事一覧: data/existing-articles.csv
- 調査済みニュース: data/news-notes.md

資料がない場合は推測で補わず、不足しているファイルを明示する。

## 企画手順

進捗を次の順番で管理し、各工程を完了してから次へ進む。

- [ ] 1. GSCデータを分析する
- [ ] 2. 既存記事との重複と内部リンク候補を確認する
- [ ] 3. ニュースの一次情報、公開日、記事との関連性を確認する
- [ ] 4. 3件の候補を比較し、推奨案を決める
- [ ] 5. 出力を検証する

GSC分析では、Skillディレクトリ内の scripts/analyze_gsc.py を data/gsc-report.csv に対して実行する。実行には uv run --script を使用する。

編集方針は [references/editorial-policy.md](references/editorial-policy.md)、SEO判断は [references/seo-guidelines.md](references/seo-guidelines.md) を読む。

## 出力形式

最初に推奨案を1件示し、その後に3案の比較表を示す。各案には次を含める。

| 項目         | 内容                                         |
| ------------ | -------------------------------------------- |
| タイトル案   | 検索意図が分かる具体的なタイトル             |
| 想定読者     | 読者の役割と課題                             |
| SEO根拠      | GSCのクエリ、表示回数、CTR、既存記事との関係 |
| ニュース根拠 | 一次情報の要点と公開日                       |
| 差別化       | 既存記事と重複しない読者価値                 |
| 次の作業     | 検証、取材、デモなど執筆前に必要な作業       |

## 検証

回答前に、GSC・既存記事・ニュースの3資料を参照した根拠があるか、数値と日付を転記できているか、推奨理由が比較表と整合するかを確認する。確認できない情報には「要確認」と付け、事実として断定しない。
GSC集計スクリプトは、改善余地の大きい検索クエリを、毎回同じ計算方法で並べるための最小構成です。
import csv
import sys
from pathlib import Path


if len(sys.argv) != 2:
    raise SystemExit("Usage: uv run --script analyze_gsc.py <gsc-report.csv>")

csv_path = Path(sys.argv[1])
if not csv_path.exists():
    raise SystemExit(f"GSCデータが見つかりません: {csv_path}")

with csv_path.open(encoding="utf-8-sig", newline="") as file:
    rows = list(csv.DictReader(file))

required = {"query", "clicks", "impressions", "ctr", "position"}
if not rows or not required.issubset(rows[0]):
    raise SystemExit(f"必要な列: {', '.join(sorted(required))}")

for row in rows:
    row["clicks"] = int(row["clicks"])
    row["impressions"] = int(row["impressions"])
    row["ctr"] = float(row["ctr"])
    row["position"] = float(row["position"])
    row["opportunity"] = row["impressions"] * (1 - row["ctr"] / 100)

rows.sort(key=lambda row: row["opportunity"], reverse=True)

print("改善余地が大きい検索クエリ(上位5件)")
for row in rows[:5]:
    print(
        f"- {row['query']}: 表示 {row['impressions']:,}、"
        f"クリック {row['clicks']:,}、CTR {row['ctr']:.2f}%、"
        f"掲載順位 {row['position']:.1f}"
    )
このスクリプトは標準ライブラリだけで動きます。記事用のサンプルデータで実際に動かし、構文と実行結果も検証済みです。SkillにPythonスクリプトを同梱するときの依存関係の扱いは、次の記事で詳しく解説しています。
Agent Skillsのベストプラクティスは、SKILL.mdを500行未満、5,000トークン未満に抑えるよう勧めています。必須の上限ではありませんが、毎回は要らない詳細をreferences/に移し、繰り返す処理をscripts/へ切り出すときの目安になります。
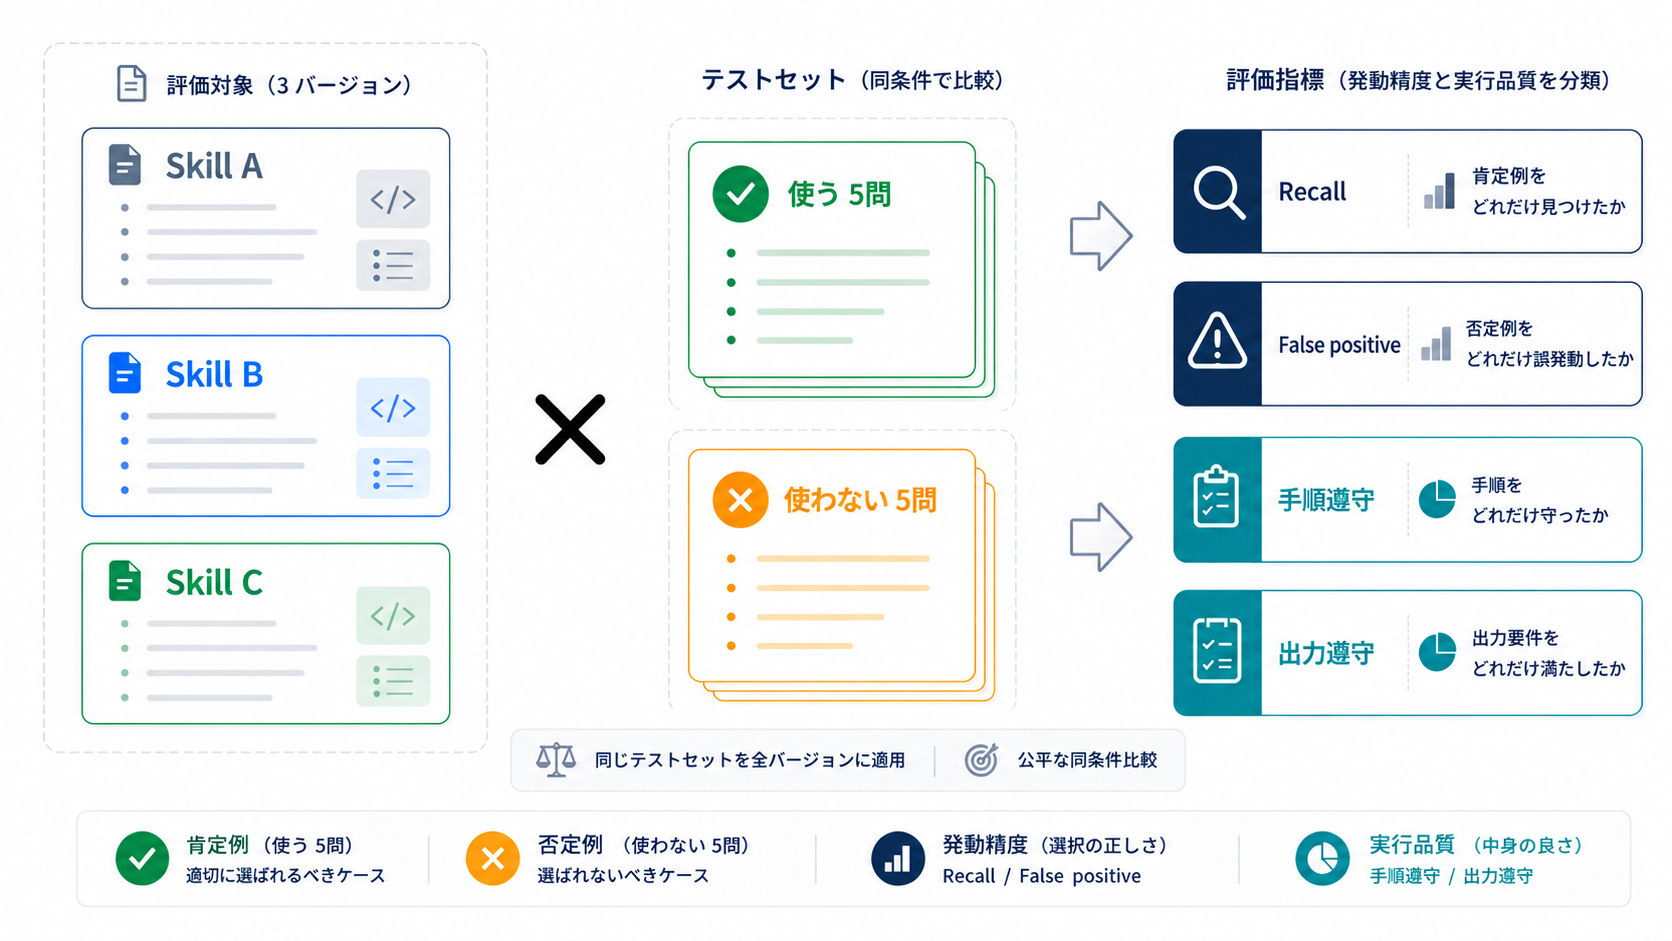
1回の実行結果だけでSkillの品質を判断すると、モデル出力のばらつきや依頼文との相性に振り回されます。そこで、まずスモークテストで動きを見たうえで、肯定例5問と否定例5問で評価します。
2026年8月13日、Codex CLI 0.147.0の一時ワークスペースにSkill A・B・Cをそれぞれ配置し、同じ依頼文とサンプルデータで予備的に動きを見ました。モデルは環境の既定のままで試行回数も少ないので、製品やモデルの性能を比べる材料にはなりません。
結果は次のとおりです。
| Skill | 依頼 | 自動選択 | 3資料の確認 | スクリプト | 明示的な最終検証 |
|---|---|---|---|---|---|
| A | 来週のTech Fun Magazineの記事テーマを考えて | あり | あり | なし | なし |
| A | 8月21日に公開する生成AI記事を決めたい | あり | あり | なし | なし |
| B | 来週のTech Fun Magazineの記事テーマを考えて | あり | あり | なし | なし |
| C | 来週のTech Fun Magazineの記事テーマを考えて | あり | あり | あり | あり |
descriptionが曖昧なSkill Aも、この依頼では自動で選ばれています。とはいえ、この結果から「descriptionは重要ではない」と結論づけるのは早すぎます。依頼がはっきり書かれていて候補になるSkillも少なく、選びやすい条件がそろっていたためだと考えられます。
研究でも、Routing上の問題がないSkillのHit@1は88.5%、問題があるSkillは82.6%でした。差はありますが、問題ありと判定されたSkillが1位になることも珍しくありません。1問の成功だけでは差が見えにくいという今回の結果と矛盾しない数字です。
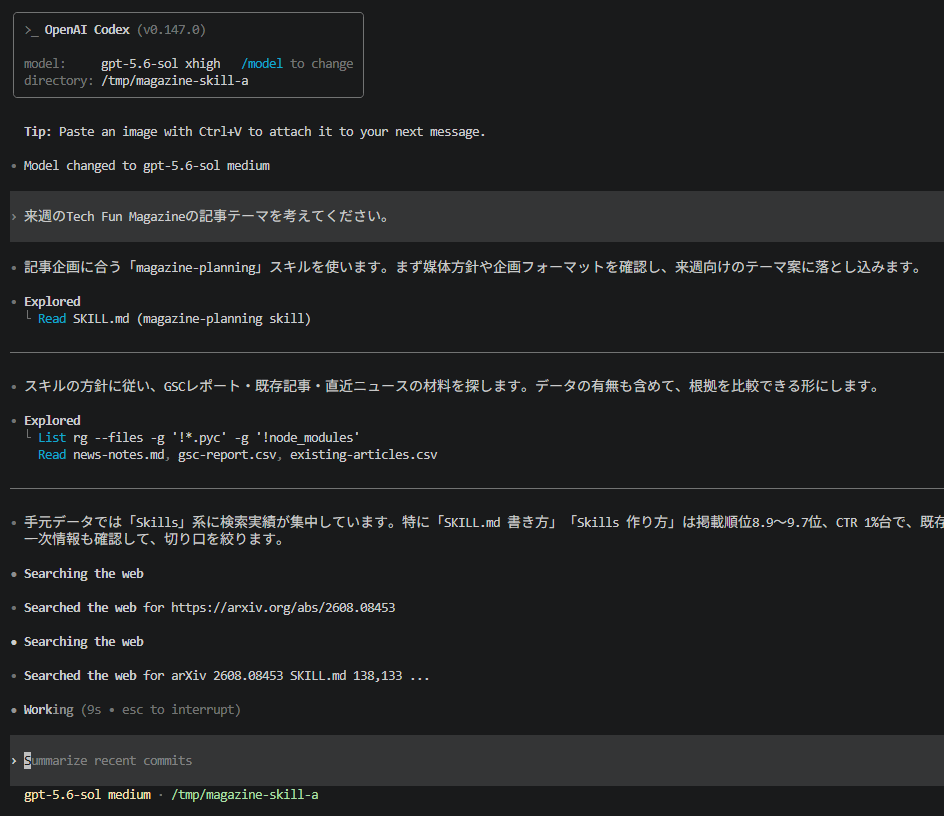
一方のSkill Cでは、GSC分析スクリプトの実行から進捗チェックリストの更新、最終検証までがログに残りました。最終回答の出来だけでなく、必要な工程を踏んだかどうかまで追えます。
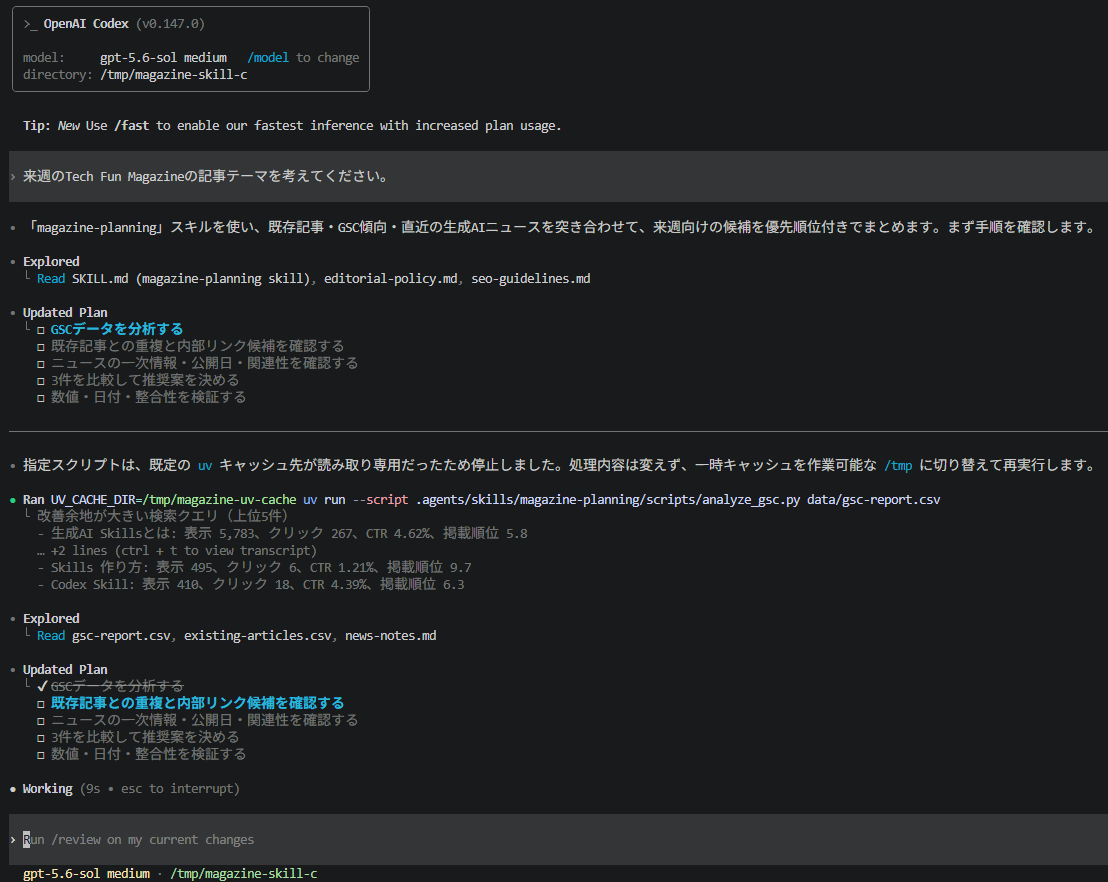
次の10問で、Skillが適切に呼び出されるかを評価します。肯定例では表現に変化をつけ、否定例には記事企画とは関係のない一般的なタスクも含めます。
| ID | 期待する動作 | テストプロンプト |
|---|---|---|
| P01 | 使う | 来週のTech Fun Magazineの記事テーマを考えてください。 |
| P02 | 使う | data/gsc-report.csvを見て次の記事を提案してください。 |
| P03 | 使う | 最近のAIニュースからTech Fun Magazineの企画を3件出してください。 |
| P04 | 使う | 8月21日に公開する生成AI記事を決めたいです。 |
| P05 | 使う | 今アクセスが取れているテーマの続編を考えてください。 |
| N01 | 使わない | この文章を英訳してください。 |
| N02 | 使わない | PythonのTypeErrorを直してください。 |
| N03 | 使わない | 東京の今日の天気を教えてください。 |
| N04 | 使わない | Claude Codeのインストール方法を教えてください。 |
| N05 | 使わない | 取引先へのメールを添削してください。 |
なお、公式ガイドは、「使わない」例として、キーワードが重なるのに別の作業が必要な依頼(near-miss)を混ぜるよう勧めています。明らかに無関係な依頼だけでは、差が出にくいためです(Optimizing skill descriptions)。
評価指標は次のように定義します。
| 指標 | 計算・確認内容 | 良い方向 |
|---|---|---|
| Recall | 肯定例5問のうちSkillが選ばれた割合 | 高いほどよい |
| False positive | 否定例5問のうちSkillが誤って選ばれた割合 | 低いほどよい |
| 手順遵守 | GSC・既存記事・ニュースの参照、スクリプト実行、検証を踏んだ割合 | 高いほどよい |
| 出力遵守 | 推奨案と指定された比較項目を満たした割合 | 高いほどよい |
テストごとに新しいセッションを立て、プロンプトにはSkill名を書きません。名前を出してしまうと、自動で選ばれるかどうかのテストではなく、名指しで呼んだときのテストになってしまいます。Agent Skillsの評価ガイドも、実際の利用者が入力する多様な依頼文と、前回の状態を引き継がない実行環境を勧めています。
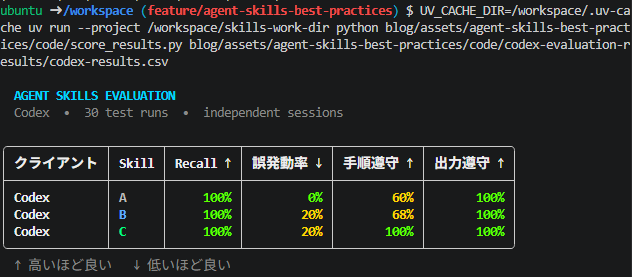
2026年8月13日、Skill A・B・Cごとに10問を流し、合計30回実行しました。1回ごとに独立した一時ワークスペースと新しいセッションを用意し、Codex CLI 0.147.0のJSONLログと最終回答を保存しています。採点では、ログ上でSKILL.mdを開いたものをSkill選択ありと数え、資料の参照、スクリプトの完了、明示的な検証はそれぞれ別に数えました。
| Skill | Recall | False positive | 手順遵守 | 出力遵守 |
|---|---|---|---|---|
| A | 100% | 0% | 60% | 100% |
| B | 100% | 20% | 68% | 100% |
| C | 100% | 20% | 100% | 100% |
3つのSkillはいずれも肯定例5問すべてで選ばれ、Recallは100%でした。ただし、今回の一時ワークスペースには評価対象のSkillしか置いておらず、肯定例も記事企画だと判断しやすい文面です。ここから「曖昧なdescriptionでも一般に問題なく選ばれる」と広げるだけの材料はありません。似たSkillが複数ある環境や、もっと間接的な言い方の依頼では結果が変わる可能性があります。
False positiveは、Skill Aが0%、Skill BとCが20%でした。BとCでは、否定例N02の「PythonのTypeErrorを直してください」に対して、Codexが修正対象のPythonファイルを探す途中でSkillディレクトリまで見に行きました。今回の採点はSKILL.mdを開いた時点で選択ありとするので、5問中1問のFalse positiveになります。もっとも、Skillとして選んだのか、直す候補のファイルとして開いただけなのかは、ログからは見分けられません。False positiveは数値だけを見ても意味がなく、開いた理由まで一緒に読む必要があります。
差がはっきり出たのは手順遵守です。Skill Aは5問すべてでGSC、既存記事、ニュースに目を通したものの、スクリプトの実行と明示的な検証はしなかったため60%でした。Skill Bも3資料に目を通し、5問中2問で検証にあたるログが残って68%でした。チェックリスト、分析スクリプト、検証条件を書き込んだSkill Cは、5問すべてで5項目を満たし100%です。
出力遵守は3つとも100%でした。今回のように出力条件を本文に具体的に書いておけば、本文の構成をそれほど変えなくても最終回答の形は揃うようです。ただ、回答が条件を満たしていることと、必要な工程を踏んだことは別の話です。出力と実行ログは分けて評価します。
13万件の研究が出したHit@1は、descriptionだけを索引にしたBM25の検索実験、つまり毎回同じ答えが出る条件で測った数字です。本番のClaude CodeやCodexでのSkill選択率ではありません。「descriptionを直せばClaudeやCodexの成功率が5.9ポイント上がる」と読み替えることもできません。この研究が示したのは、Routing上の問題があるグループとないグループの間に、限られた条件の検索実験で差が出たという事実です。
descriptionを改善してSkillが選ばれるようになっても、本文の手順が毎回守られるとは限りません。この点を扱った研究が、2026年8月10日に公開されています。「SkillSentry: Reliable Skill Execution for LLM Agents via Runtime Assurance」です。
研究チームは、Claude CodeとCodexを対象に、それぞれ2種類の基盤モデルを組み合わせ、合計15種類のSkillを評価しました。Skillの仕様や過去の成功・失敗ログ、ステップごとの助言と警告を材料に、実行中に手順から外れていないかを見張る仕組みを組み込みました。外れていれば、その場で補正します。結果として、平均タスク成功率が24.1%上がり、同じ処理を繰り返したときのばらつきも小さくなったと報告しています。
この24.1%も、あらゆるSkillに当てはまる保証値ではありません。15種類のSkillと、特定のエージェント・モデル・評価環境の組み合わせで出た平均値です。しかもSkillSentryはSKILL.mdの書き方だけの話ではなく、実行時にエージェントを見張る外部の仕組みまで含んだ提案です。
それでも、Skill設計に生かせる点があります。
| 実行時の課題 | SKILL.mdでできる対策 | より強い保証が必要な場合 |
|---|---|---|
| 手順を飛ばす | 明示的なチェックリストを置く | 実行ログから必須ステップを監視する |
| 入力不足を推測で補う | 不足時の停止条件を書く | 入力スキーマを機械検証する |
| 同じ計算を毎回作り直す | 検証済みscriptを同梱する | scriptの出力をテストする |
| 出力形式が揺れる | 表やテンプレートを示す | 構造化出力をバリデーションする |
| 誤りを確認せず終了する | validation loopを書く | 完了ゲートを実行環境で強制する |
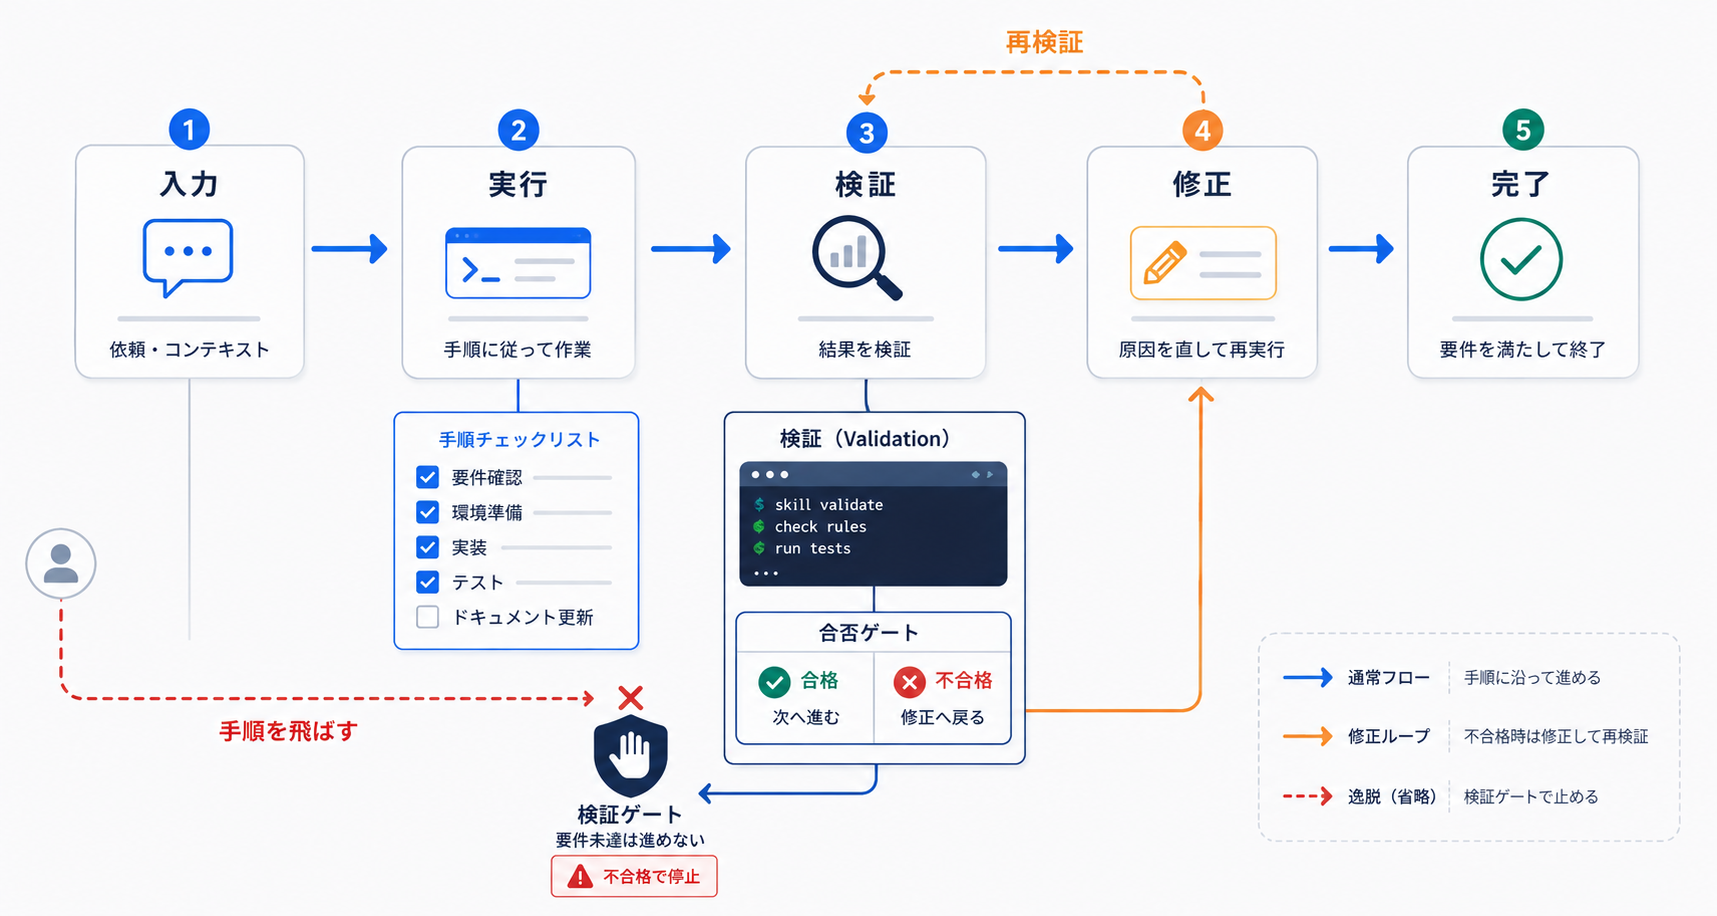
Agent Skillsの公式ベストプラクティスも、工程が複数あるワークフローではチェックリストを使い、作業のあとで結果を検証するよう勧めています。検証に落ちたら直し、もう一度かける。この繰り返しがvalidation loopです。ファイルを壊す操作や一括変更なら、plan、validate、executeを分けて順に踏ませます。
Skillは自然言語の手順書ですが、肝心な処理まで「できればこうする」という書き方で済ませる必要はありません。機械的に結果を検証できる部分はscriptへ移します。失敗したときの終了コードとメッセージをはっきりさせておけば、エージェント自身が問題を直せます。
Agent Skillsはオープンな形式なので、これに対応するクライアントであれば、どれでも同じ基本構造を使えます。ただし、Skillを置く場所はクライアントごとに違います。
| クライアント | プロジェクト内の代表的な配置先 | 公式情報 |
|---|---|---|
| Codex | .agents/skills/<skill-name>/SKILL.md | OpenAI「Build skills」 |
| Claude Code | .claude/skills/<skill-name>/SKILL.md | Claude Code「Extend Claude with skills」 |
今回の検証用コードでは、Skill A・B・Cの各SKILL.mdを両方の配置先へ同じ内容でコピーしました。中身をそろえておけば、クライアントの違いから来る差とSkill自体の差を切り分けられます。
定量評価はCodexに絞り、Claude CodeではSkill Cを1件だけ動かしました。同じ依頼でSkillが自動的に選ばれ、指定した資料をたどって出力まで進むところまでは見ています。Claude CodeでA・B・Cの10問評価はしていないので、前節のRecall、False positive、手順遵守、出力遵守はすべてCodexの数字です。次のスクリーンショットは可搬性を示す1例で、2つのクライアントの性能比較ではありません。
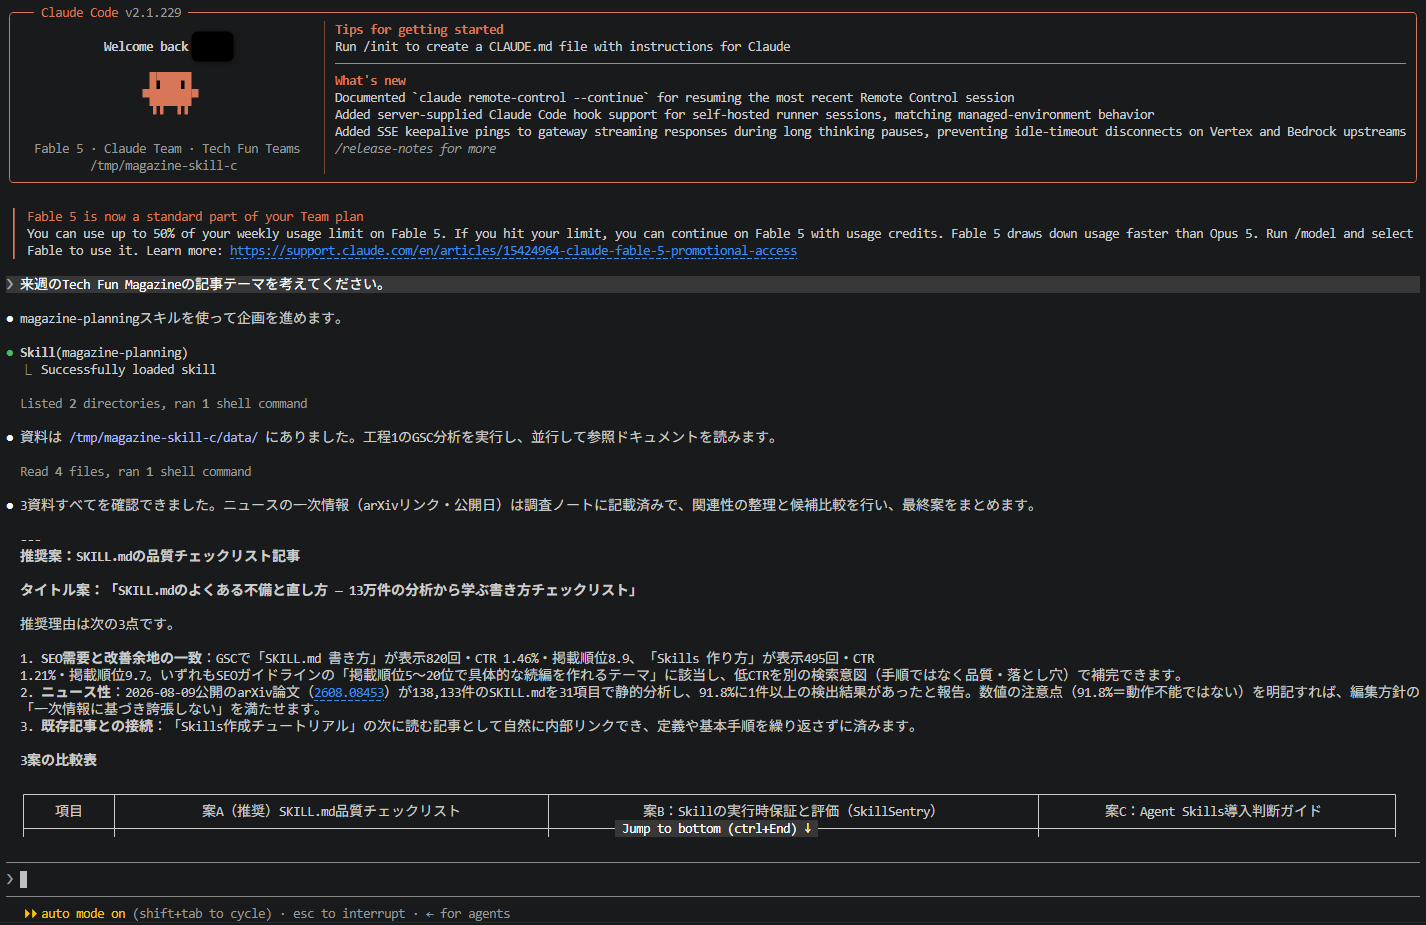
同じファイルをコピーできても、同じように動作するとは限りません。可搬性を高めるには、次の点を確認します。
一つのSkillでも、使えるツールや権限、基盤モデル、コンテキストの管理方法が違えば結果は変わります。そのため、可搬性は「ファイルを読み込めたか」だけでなく、「必要な手順を実行し、出力条件を満たせたか」で評価します。
最後に、研究の結果と公式仕様、そして今回作った検証用Skillを踏まえて、公開前の確認項目を整理します。
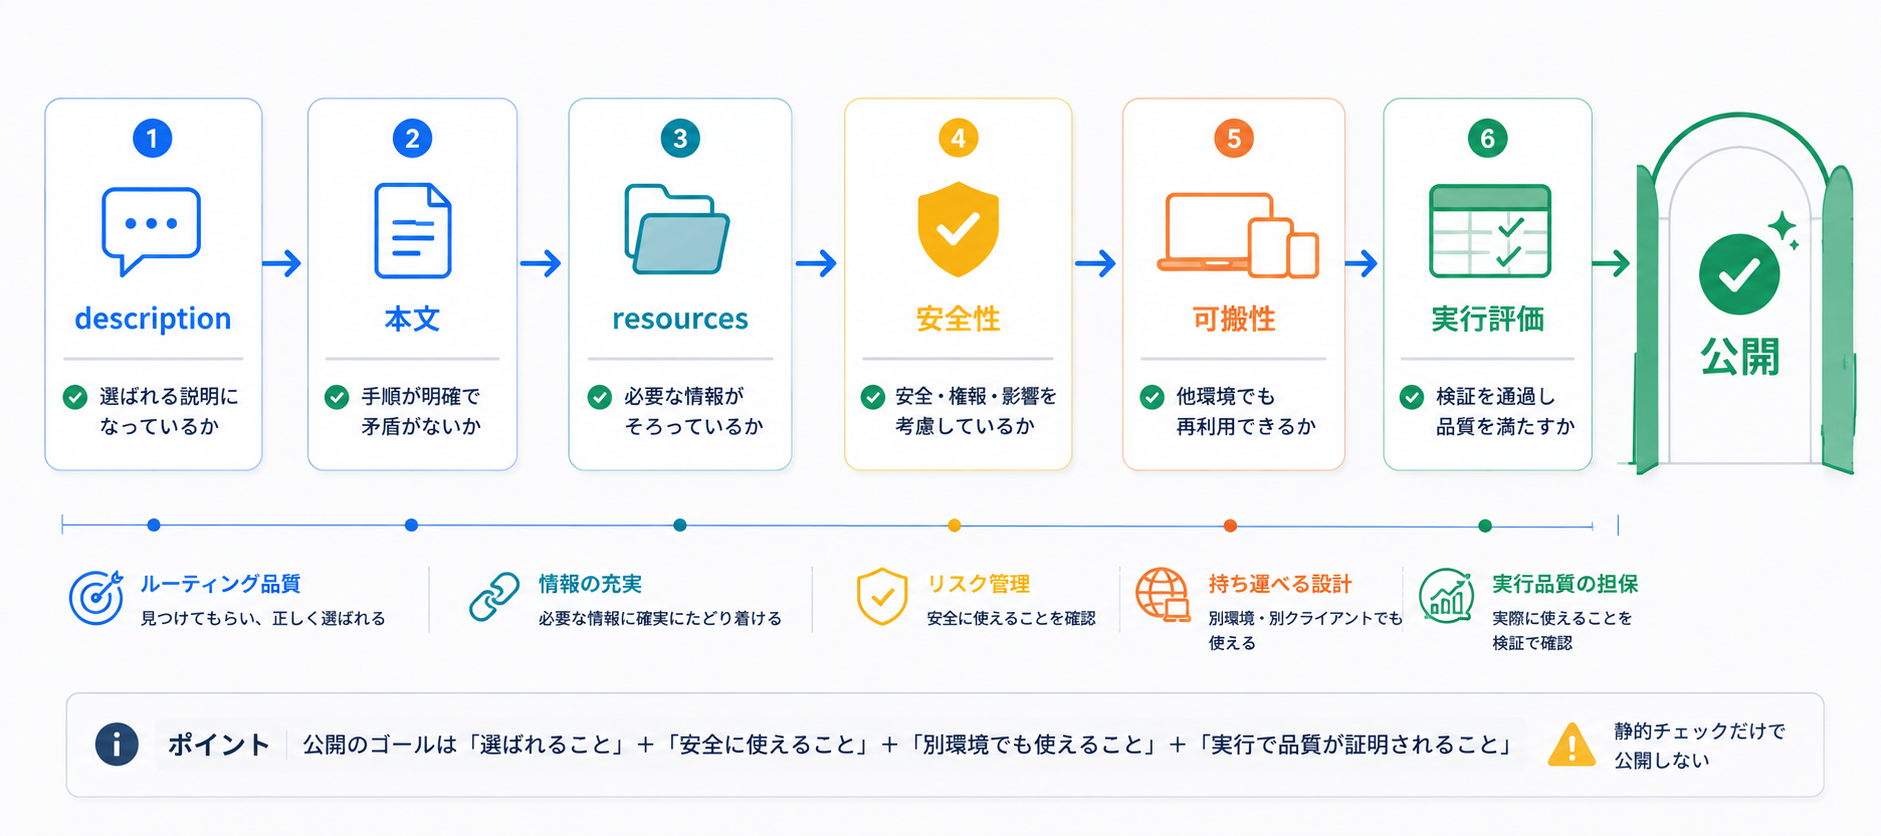
この順に見ていけば、「とりあえず文章を長くする」という方向へ流れずに、発見、実行、検証、再利用の各段階を一つずつ点検できます。静的チェックは公開前の最初のふるい分けとして役立ちますが、最後は実際の依頼で評価し、ログをもとに直していくしかありません。
自社の仕事をSkill化するときに設計すべきなのは、SKILL.mdの書き方だけではありません。どの業務を対象にするか、入力データ、権限、評価指標、そして運用の責任者まで含みます。どこから検証するか整理したいときは、Tech Funの 無料診断パック で、現在の業務と生成AI活用の可能性を確認できます。効果が見込める業務は、 検証(PoC)パック で小規模な実装と評価へ進められます。
Agent Skillsは、指示を書いたSKILL.mdを保存すれば完成、というものではありません。必要な依頼でエージェントに見つけてもらい、選ばれたあとは手順どおりに動かし、別の環境でも再利用できるところまで設計して、はじめて使えるものになります。
本記事の要点は次のとおりです。
「使われるSkill」を作るには、SKILL.mdを1枚書いて終わりにせず、テストして直すところまで続けます。まずは現実的なテストを2〜3件用意することから始めてください。実行ログと人のレビューをもとに手を入れていけば、実務で使えるSkillに近づきます。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。