生成AI関連
Structured Outputsの基本と実践
生成AIを業務システムやAIエージェントに組み込むと、文章を書かせる処理より「判断させる」処理のほうが多くなります。問い合わせをどの窓口へ回すか、この入力は規約に違反していないか、エージェントは次に検索するのか回答するのか。いずれも、答えの候補はあらかじめ決まっています。
こうした判断を汎用のLLMに任せる場合、モデルは答えを文章として生成し、アプリケーション側でそれを読み取ります。構造化出力を使えば形式は守れますが、生成である以上、応答には数秒かかり、出力トークンにも料金がかかります。さらに、返ってくるのは「billing」のような答えだけで、モデルがどの程度確信しているかは分かりません。確信が低いものだけ人に回す、といった設計を組みにくいのが実情です。
2026年9月以降、この「判断」だけを担うモデルが相次いで登場しました。TypeSafe AIのJev、OpenAIのDecisions API、MicrosoftのMicrosoft-Decision-1です。いずれも文章を生成せず、決められた選択肢それぞれの確率を返します。
本記事では、判断特化APIの概要、使用場面、料金を整理したうえで、OpenAI Decisions APIを使って社内ヘルプデスクへの問い合わせを振り分けるデモを実装します。最後に、実際に使って分かったメリットとデメリットをまとめます。なお、本記事の内容は2026年10月27日時点の情報に基づいています。
構造化出力の基本は、以前の記事で解説しています。
判断特化APIは、入力と「問い」と「答えの候補」を受け取り、候補ごとの確率を返すAPIです。答えの候補は呼び出し側が事前に定義するため、候補以外の値が返ることはありません。
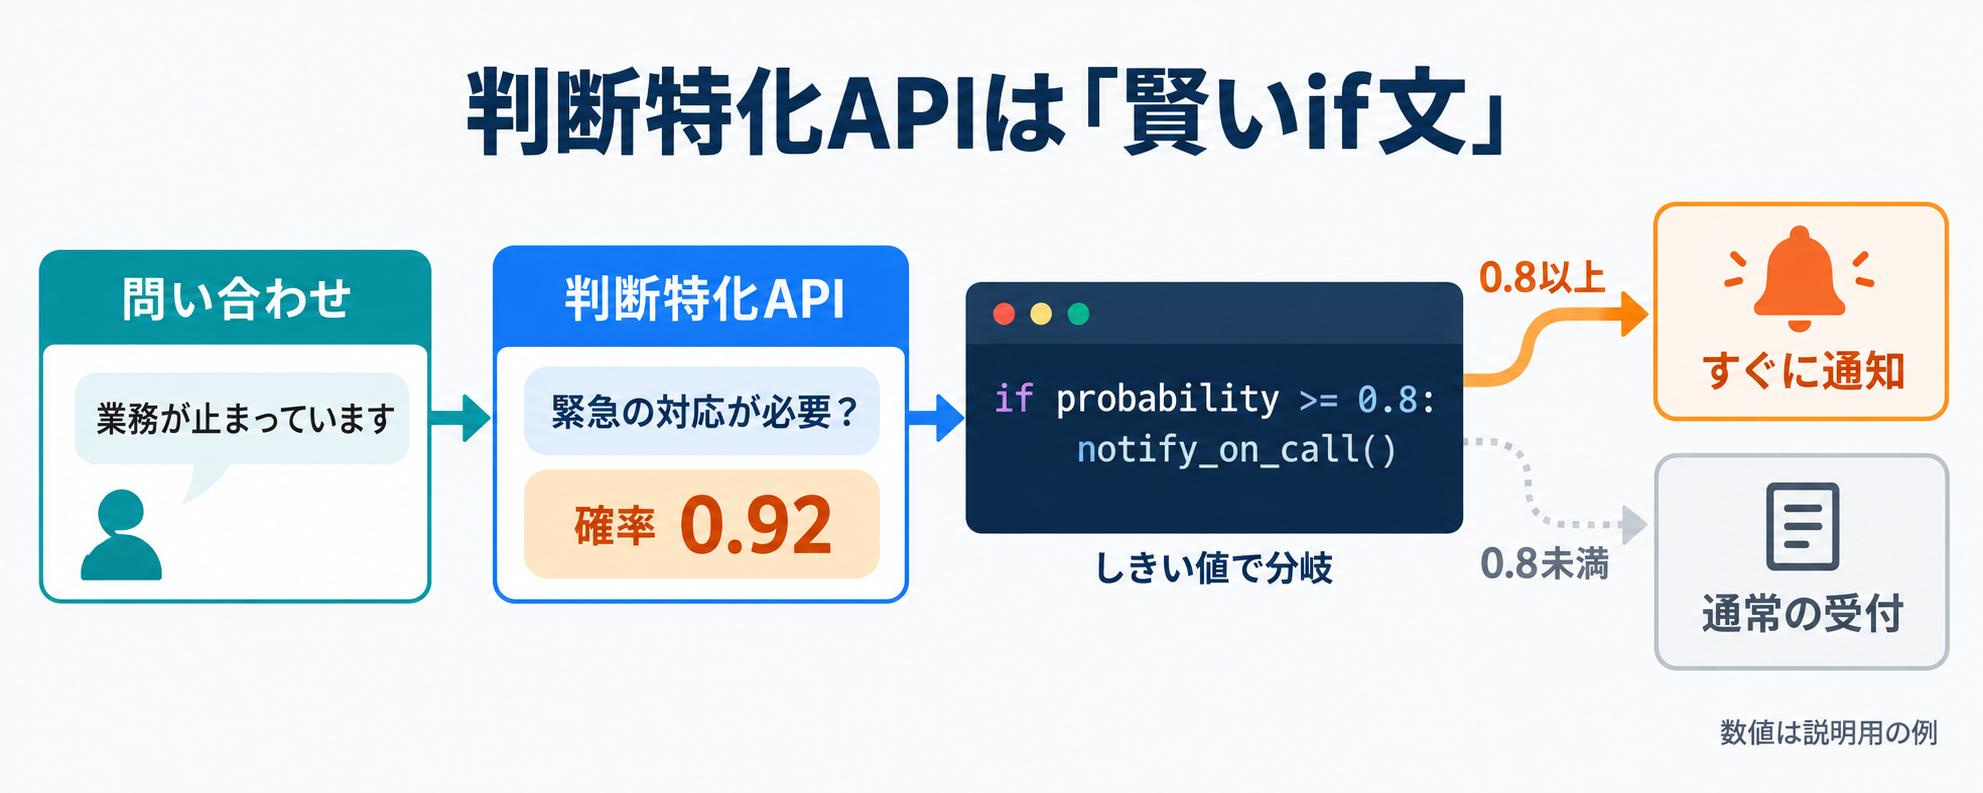
判断特化APIは、「賢いif文」と考えると用途をイメージしやすくなります。TypeSafe AIも、Jevの用途を「smart if-statements」と表現しています。「この問い合わせは緊急か」のように、単純な条件式では書きにくい判断をAIに任せ、その結果や確率を使って処理を分岐させます(TypeSafe AI公式ブログ)。
同じ「問い合わせを窓口に振り分ける」処理を、生成型LLMの構造化出力と判断特化APIで実装した場合の違いは次のとおりです。
| 項目 | 生成型LLM+構造化出力 | 判断特化API |
|---|---|---|
| 返るもの | スキーマに沿ったJSON(答えの値) | 選んだ答え、選択肢ごとの確率、確信度 |
| 答えの範囲 | スキーマのenumで制約する | 定義した選択肢の中だけ |
| 判断の理由 | 項目を足せば文章で書かせられる | 返らない |
| 課金 | 入力トークン+出力トークン | 入力トークンのみ |
| 向いている処理 | 抽出、要約、オブジェクトの生成 | 分類、振り分け、条件判定、採点 |
OpenAIのDecisions APIガイドでも、スキーマに沿ったオブジェクトを生成したい場合はResponses APIのStructured Outputsを、ツール呼び出しが必要な場合はFunction callingを使うよう案内しています。判断特化APIは、生成型LLMを置き換えるものではなく、判断の部分だけを切り出して担当するものです。
主な製品は次の3つです。
| 製品 | 提供元 | 発表日 | 提供形態 | 入力料金(100万トークンあたり) |
|---|---|---|---|---|
| Jev | TypeSafe AI | 9月15日 | 早期アクセス | $0.042 |
| Decisions API(gpt-6-luna) | OpenAI | 9月29日(DevDay) | Public Beta | $0.10 |
| Microsoft-Decision-1 | Microsoft | 10月9日 | Microsoft Foundryでパブリックプレビュー | $0.042 |
いずれも出力トークンは無料です。
本記事では、3製品のうちOpenAIのDecisions APIを使って、このような判断を実装します。Decisions APIは、汎用モデルGPT-6 Lunaを判断用に呼び出すAPIです。
現時点ではパブリックベータ版で、対応モデルはgpt-6-lunaのみです。リクエストにはモデルの指定が必須で、model="gpt-6-luna" を渡します(OpenAI:Decisions APIリファレンス)。
OpenAIは、Responses API経由でGPT-6 Lunaを呼ぶ場合より約10倍速く判断できるとしています。
例えば、Decisions APIは次の3種類の質問に対応しています。1回のリクエストに複数の質問を含めることもできます。
| 種類 | 用途 | 返る値 |
|---|---|---|
| predicate | 条件に当てはまるかを判定する | 当てはまる確率(0〜1) |
| choice | 選択肢から1つ選ぶ | 選んだ値、確信度、選択肢ごとの確率 |
| score | 順序のある段階で評価する | 確率で重み付けしたスコア、確信度、段階ごとの確率 |
choiceの選択肢は2〜255個まで指定できます。各選択肢に説明文を付けられるため、選択肢名だけでは区別しにくい場合も、判断の基準を伝えられます。
判断特化APIが向いているのは、答えの候補を事前に列挙でき、大量に、速く判断したい処理です。
一方、要約や回答文の作成のように文章そのものが成果物になる処理や、答えの候補を事前に決められない判断には使えません。判断の理由を記録として残す必要がある場合も、別途生成型LLMで説明を作る必要があります。
ここからは、社内ヘルプデスクに届いた問い合わせを、Decisions APIで振り分けます。1件の問い合わせに対して、次の3つを1回のリクエストで判定します。
| 名前 | 種類 | 判定する内容 |
|---|---|---|
| category | choice | 担当窓口(アカウント、ネットワーク、機器、ソフトウェア、その他) |
| urgency | score | 業務への影響(低・中・高) |
| escalation | predicate | セキュリティ担当への即時連絡が必要か |
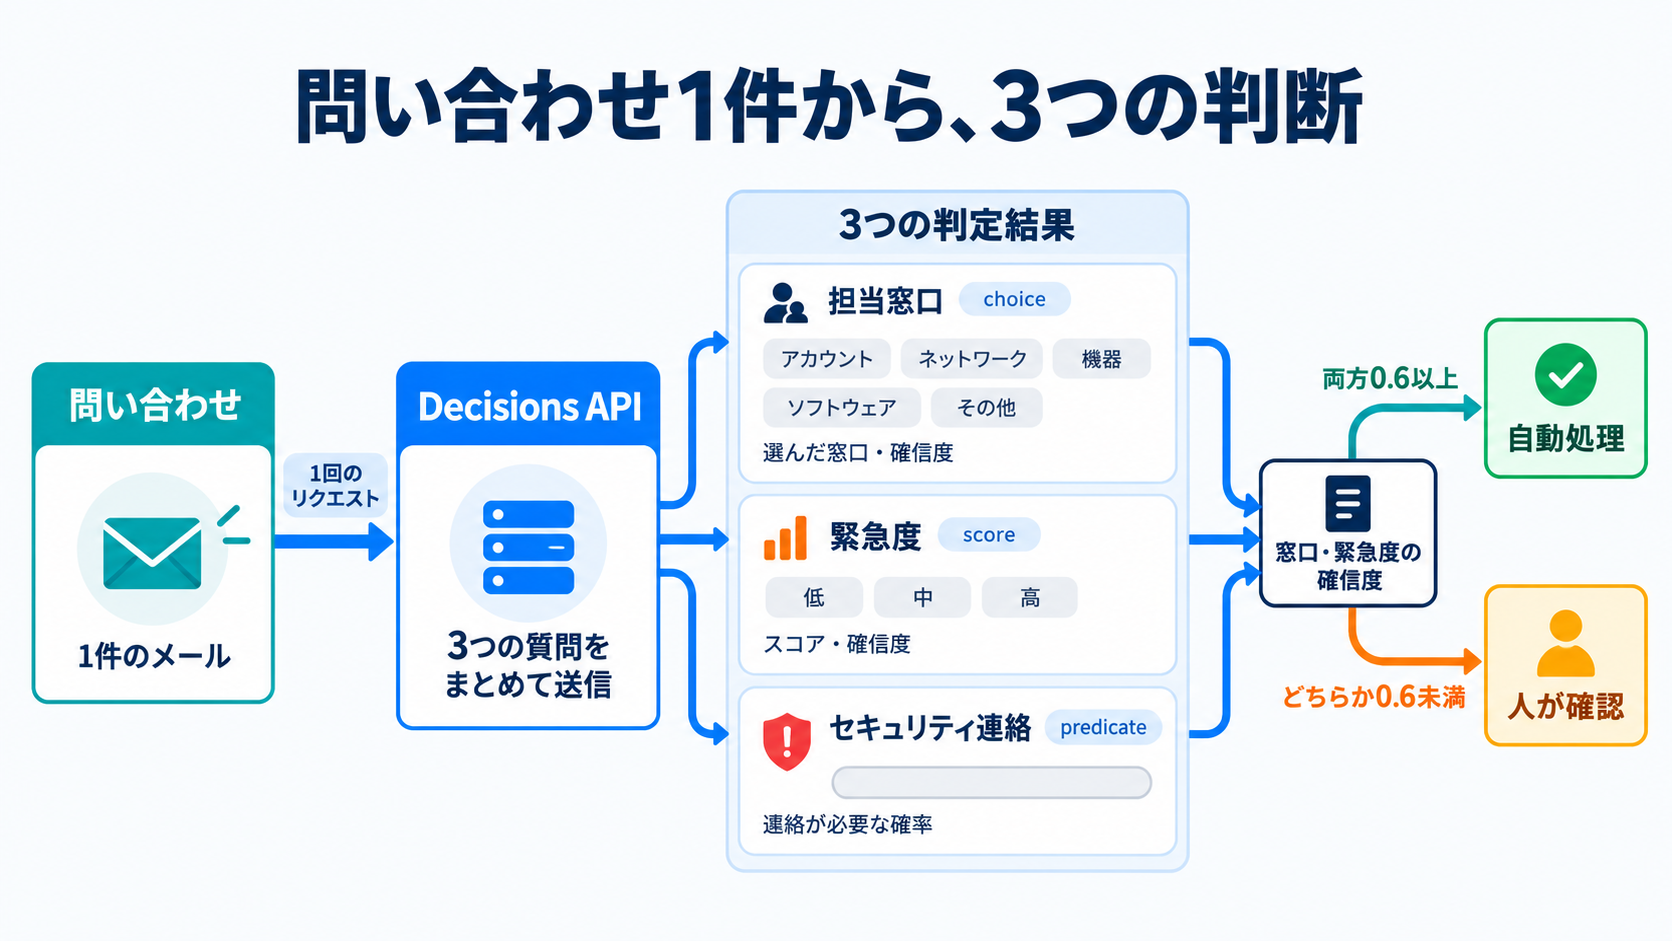
3つの質問を questions.py にまとめます。choiceの選択肢とscoreの段階には説明文を付け、判断基準をモデルに伝えます。どの窓口にも当てはまらない問い合わせのために、other を選択肢に含めています。
MODEL = "gpt-6-luna"

QUESTIONS = [
    {
        "type": "choice",
        "name": "category",
        "instructions": "この問い合わせを担当するのはどの窓口ですか。",
        "choices": [
            {"value": "account", "description": "ログイン、パスワード、権限申請"},
            {"value": "network", "description": "社内ネットワーク、VPN、Wi-Fi"},
            {"value": "device", "description": "PC、プリンター、周辺機器の故障や手配"},
            {"value": "software", "description": "業務アプリやSaaSの不具合、導入"},
            {"value": "other", "description": "上記に当てはまらない問い合わせ"},
        ],
    },
    {
        "type": "score",
        "name": "urgency",
        "instructions": "問い合わせ者の業務への影響はどの程度ですか。",
        "levels": [
            {"label": "低", "description": "業務は続けられる。質問や依頼のみ"},
            {"label": "中", "description": "一部の作業が止まるが、代替手段がある"},
            {"label": "高", "description": "業務が止まっていて、代替手段がない"},
        ],
    },
    {
        "type": "predicate",
        "name": "escalation",
        "instructions": (
            "情報漏えい、不正アクセス、ウイルス感染など、"
            "セキュリティ担当への即時連絡が必要な内容を含みますか。"
        ),
    },
]
client.decisions.create() に、モデル名、問い合わせ本文、質問を渡します。返り値は種類ごとに表示し、スコア・確信度・各候補の確率を区別して確認できるようにします。各候補の確率は1行にまとめます。回答は質問と同じ順序で answers に入り、choice・score・predicateそれぞれの返り値を確認できます。モデルが回答を拒否した質問は refusal として表示されます。
import time

from dotenv import load_dotenv
from openai import OpenAI

from questions import MODEL, QUESTIONS

load_dotenv()
client = OpenAI()

ticket = (
    "朝からVPNにつながらず、社外から基幹システムに入れません。"
    "本日中に請求データを締める必要があり、作業が止まっています。"
)

start = time.perf_counter()
decision = client.decisions.create(model=MODEL, input=ticket, questions=QUESTIONS)
elapsed_ms = (time.perf_counter() - start) * 1000

for answer in decision.answers:
    print(f"\n[{answer.name} / {answer.type}]")
    if answer.type == "choice":
        print(f"  選択結果: {answer.choice}")
        print(f"  確信度: {answer.confidence:.2f}")
        probabilities = "  ".join(
            f"{p.value}={p.probability:.3f}" for p in answer.probabilities
        )
        print(f"  各候補の確率: {probabilities}")
    elif answer.type == "score":
        levels = "、".join(f"{p.label}={p.value}" for p in answer.probabilities)
        print(f"  スコア: {answer.score:.2f}({levels})")
        print(f"  確信度: {answer.confidence:.2f}")
        probabilities = "  ".join(
            f"{p.label}={p.probability:.3f}" for p in answer.probabilities
        )
        print(f"  各段階の確率: {probabilities}")
    elif answer.type == "predicate":
        print(f"  条件に当てはまる確率: {answer.probability:.3f}")
    else:
        print("  回答拒否")

print(f"\n応答時間: {elapsed_ms:.0f} ms")
print(f"入力トークン: {decision.usage.input_tokens}")
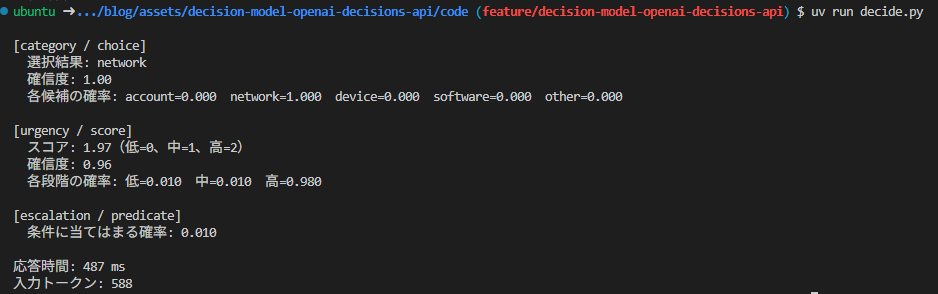
uv run decide.py で実行した結果です。
次に、正解ラベルを付けた架空の問い合わせ16件をまとめて判定します。問い合わせは tickets.json に次の形式で用意しました。
[
  {"id": 1, "text": "パスワードを3回間違えてアカウントがロックされました。解除をお願いします。会議資料の作成が進められません。", "category": "account", "urgency": 2, "escalation": false},
  {"id": 5, "text": "取引先を名乗るメールの添付ファイルを開いたら、PCの画面に見慣れない警告が出続けています。", "category": "other", "urgency": 2, "escalation": true},
  {"id": 14, "text": "社内の座席表はどこで確認できますか。", "category": "other", "urgency": 0, "escalation": false}
]
urgency は段階の番号(0:低、1:中、2:高)です。16件の内訳は、窓口ごとに3〜4件、セキュリティ担当への連絡が必要なものが4件です。
判定では、緊急度は確率が最も高い段階を、セキュリティ連絡は確率0.5以上を「要連絡」として扱います。窓口と緊急度のどちらかの確信度が0.6未満なら「要確認」と表示し、人の確認に回す想定です。
import json
import statistics
import time

from dotenv import load_dotenv
from openai import OpenAI

from questions import MODEL, QUESTIONS

load_dotenv()
client = OpenAI()

REVIEW_THRESHOLD = 0.6  # 確信度がこれ未満なら人の確認に回す

tickets = json.load(open("tickets.json", encoding="utf-8"))
correct = {"category": 0, "urgency": 0, "escalation": 0}
latencies, input_tokens = [], 0

for t in tickets:
    start = time.perf_counter()
    d = client.decisions.create(model=MODEL, input=t["text"], questions=QUESTIONS)
    latencies.append((time.perf_counter() - start) * 1000)
    input_tokens += d.usage.input_tokens

    a = {ans.name: ans for ans in d.answers}
    category = a["category"].choice
    urgency = max(a["urgency"].probabilities, key=lambda p: p.probability).value
    escalation = a["escalation"].probability >= 0.5
    review = min(a["category"].confidence, a["urgency"].confidence) < REVIEW_THRESHOLD

    correct["category"] += category == t["category"]
    correct["urgency"] += urgency == t["urgency"]
    correct["escalation"] += escalation == t["escalation"]
    print(f"# {t['id']} {t['text']}")
    print(
        f"{category} ({a['category'].confidence:.2f}) "
        f"urgency={urgency}({a['urgency'].confidence:.2f}) "
        f"escalation={a['escalation'].probability:.2f} "
        f"{'要確認' if review else ''}  {latencies[-1]:.0f} ms"
    )

n = len(tickets)
print(f"件数: {n}")
for key, value in correct.items():
    print(f"{key} 正解率: {value}/{n}")
print(f"応答時間 中央値: {statistics.median(latencies):.0f} ms / 最大: {max(latencies):.0f} ms")
print(f"入力トークン合計: {input_tokens}")
uv run evaluate.py で実行した結果です。各問い合わせの番号・本文に続けて、判定結果と応答時間を表示します。
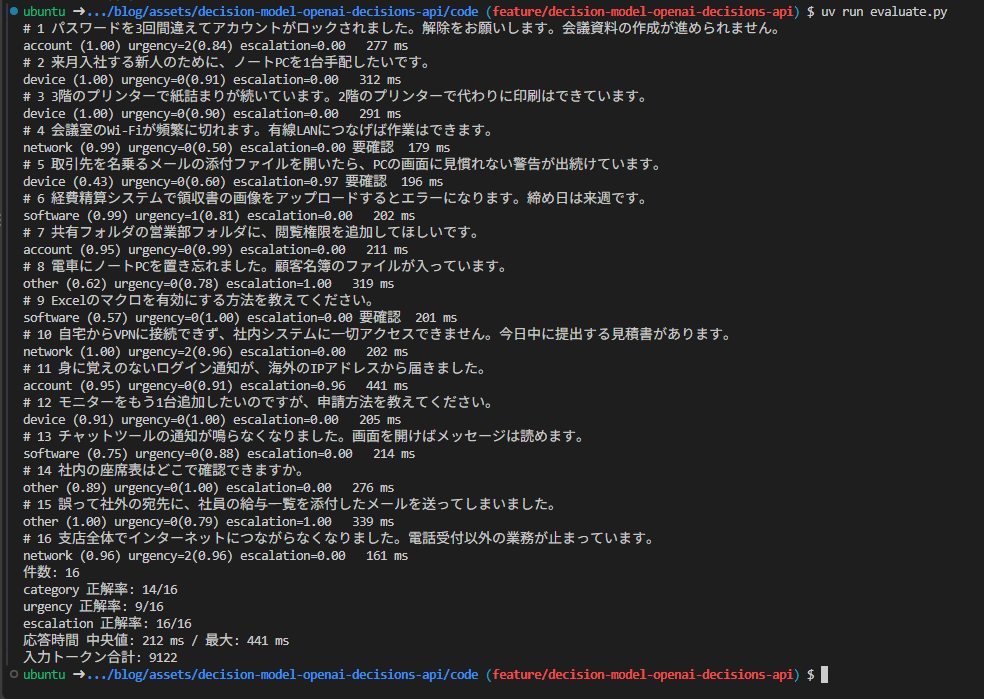
| 項目 | 結果 |
|---|---|
| 窓口(category)の正解数 | 14/16 |
| 緊急度(urgency)の正解数 | 9/16 |
| セキュリティ連絡(escalation)の正解数 | 16/16 |
| 「要確認」になった件数 | 3件 |
| 応答時間の中央値/最大 | 212ms/441ms |
| 入力トークン合計 | 9,122 |
窓口の誤判定は2件でした。添付ファイルを開いた後に警告が出続ける問い合わせ(#5)は、正解ラベルのotherに対してdeviceと判定されました。一方、顧客名簿入りのPCを電車に置き忘れた問い合わせ(#8)は、正解ラベルのdeviceに対してotherと判定されました。どちらもセキュリティ連絡は必要と判定されており、機器の問題とセキュリティ上の問題が重なる問い合わせで、担当窓口の分類が正解ラベルと一致しませんでした。
緊急度は、誤判定した7件すべてで「低」が選ばれました。代替手段のあるプリンターやWi-Fiの不具合に加え、不審なログイン通知や給与一覧の誤送信も「低」となっています。今回の質問では緊急度を「業務への影響」と定義しているため、セキュリティ上の重大さと、作業が止まっているかという基準が一致しないケースがあります。業務停止とセキュリティ上の緊急性を分けて評価し、質問の説明文と正解ラベルの基準をそろえる必要があります。
「要確認」になったのは#4・#5・#9の3件です。このうち#9のマクロ設定に関する質問は、窓口・緊急度とも正解していました。一方、不審なログイン通知(#11)は緊急度の確信度が0.91でも正解ラベルと一致せず、確認対象には入りませんでした。確信度が低いものを人に回す仕組みは作れますが、今回の0.6というしきい値で誤判定をすべて拾えるわけではありません。
今回は、現時点で唯一選択できるgpt-6-lunaで、16件を1回ずつ判定した結果です。判断の精度や応答速度は、使用するモデルに大きく依存すると考えられ、この結果だけで判断特化API全般の性能を評価することはできません。
今後、選択できるモデルが増えた場合には、今回のように実際のタスクに沿った正解ラベル付きのデータで、モデルごとの精度・応答速度・料金を比較することが重要です。タスクの重要度や誤判定の影響、許容できるコストを踏まえてモデルを選び、確信度のしきい値も調整する必要があります。分類精度の評価指標は、以下の記事で解説しています。
最も大きな違いは、確率が返ることです。生成型LLMの構造化出力では答えの値しか得られませんが、Decisions APIでは選択肢ごとの確率と確信度が返ります。確信度が高いものは自動で処理し、低いものだけ人に回す設計を、返ってきた値でそのまま組めます。
predicateのしきい値は、見逃しと誤検知のどちらを避けたいかで決めます。デモのセキュリティ連絡であれば、見逃しのほうが影響が大きいため、しきい値を0.5より下げる判断が考えられます。
答えが選択肢の中に限られるため、生成した文字列を解析する処理や、表記ゆれへの対処も不要です。デモのように独立した質問は1回のリクエストにまとめられ、料金は入力の長さと件数から見積もれます。
判断の理由は返りません。なぜその窓口を選んだのかが分からないため、誤判定の原因を調べるには、入力や選択肢の説明文を変えて試すことになります。判断の根拠を記録する必要がある業務では、生成型LLMとの併用が必要です。
選択肢は事前に決めておく必要があり、想定外の問い合わせを受け止めるには other のような選択肢と、その後の処理を別に設計します。「窓口がネットワークの場合だけ障害範囲を判定する」のように前の判断に依存する処理は、リクエストを分けて順に呼び出します。
Decisions APIはPublic Betaです。現時点で使えるモデルはgpt-6-lunaのみで、キャッシュも利用できません。OpenAIの開発者コミュニティでは、choiceの確率が最も可能性の高い選択肢に偏るという報告もあります(OpenAI Developer Community:Decisions API Public Betaの告知スレッド)。確率をそのまま信頼せず、自社データでしきい値を検証してから使う必要があります。
AIエージェントや業務システムで、分類や振り分けを生成型LLMに任せている箇所があれば、その部分を判断特化APIに置き換えられるか、まず小さなデータで確かめるところから始めるとよいでしょう。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。