生成AI関連
はじめての人のための:AI・機械学習・統計・生成AI・AGIの違いと、期待値の置き方
「AIの回答精度を100%にしてほしいんですが」
この要望、本当によく聞きます。気持ちは分かります。業務で使うシステムに「たまに間違える」なんて許容しにくいですよね。
しかし、この期待こそが生成AI導入プロジェクトを停滞させる最大の原因です。精度100%を目指すあまり、PoCから先に進めない。「まだ精度が足りない」とチューニングを繰り返し、半年経っても本番投入できない。そして、新たなAIサービスを探して導入しては同じことを繰り返してしまう。こういうケースを何度も見てきました。
この記事では、なぜ精度100%が構造的に不可能なのか、どこまで技術で改善できるのか、そして残りをどう運用でカバーするのかを整理します。
「AIに何を期待し、何を期待しないか」を設計する。これが生成AI活用の出発点です。
なお、AIの種類や期待値の基本的な考え方については、下記の記事で整理しています。
そもそも生成AI(LLM)は、「正解を検索して返す装置」ではありません。学習済みのパターンから「次に来る可能性が最も高いトークン(単語の断片)」を確率的に選び続けることで、文章を生成しています。
つまり、構造上「確定的な正解」を保証する仕組みを持っていません。たとえ99回正しく答えても、100回目に異なる確率分布から選択が行われ、誤った回答が生成される可能性は常にあります。
これは、モデルの「バグ」ではなく「仕様」です。確率的に生成するからこそ、多様な文章を柔軟に作れるという強みがあります。裏を返せば、100%の再現性や正確性は原理的に保証できないということです。
仮に精度改善に取り組むとしても、 80%→90% にするのと、 95%→99% にするのでは、必要な労力がまるで違います。
| 精度目標 | 追加で必要な工数(目安) | 主なアプローチ |
|---|---|---|
| 〜80% | 小(数日〜1週間) | プロンプト設計の見直し |
| 80→90% | 中(2〜4週間) | RAG導入、テストケース整備 |
| 90→95% | 大(1〜3ヶ月) | ファインチューニング、ガードレール設計 |
| 95→99% | 特大(3ヶ月〜半年以上) | 複合的な施策+大量の評価データ整備 |
| 99→100% | 現実的に不可能 | 確率的生成の原理上、完全な保証はできない |
95%から先の改善に注ぎ込むコストは、指数関数的に膨らみます。そしてその投資に見合うリターンが得られるかは、業務内容によって大きく異なります。
「もっと賢いモデルを使えば精度が上がるはず」と考えがちですが、多くの場合、ボトルネックはモデル性能ではなくデータの質と量です。
モデルを最新版にアップグレードする前に、まず「モデルに渡しているデータは十分か?正確か?」を確認する方が効果的です。
❌モデルを最新版に変えれば、精度は自動的に上がる
✅精度を決めるのは「タスク × データ × プロンプト」の組み合わせ
モデルの基礎性能が上がっても、タスクに適したプロンプト設計や、良質なデータの準備ができていなければ効果は限定的です。逆に、古いモデルでもプロンプトとデータが適切なら、十分な精度が出ることもあります。
❌PoCの精度がそのまま本番で再現される
✅本番データはPoCより多様で、分布が異なる
PoCでは「うまくいくケース」を中心にテストしがちです。本番環境では、想定外の入力、表記ゆれ、ノイズの多いデータが流れてきます。PoCで90%だった精度が、本番では70%に落ちるのは珍しくありません。
❌精度80%のAIは実用にならない
✅80%を自動化し、残り20%を人間が確認すれば大幅な効率化になる
100件の作業があるとして、80件をAIが処理し、人間は残り20件だけ確認する。これだけで作業量は大幅に減ります。「100%でなければ使えない」という考え方は、AIの価値を大きく見誤っています。
精度改善には主に4つのアプローチがあります。それぞれの特徴と使いどころを整理します。
AIへの指示(プロンプト)を工夫することで、出力の質を改善する手法です。コストが最も低く、最初に取り組むべきアプローチです。
役割の明示、出力形式の指定、制約条件の追加など、プロンプトの書き方ひとつで精度が大きく変わります。
社内ドキュメントやナレッジベースから関連情報を検索し、それをプロンプトに含めてAIに回答させる手法です。モデルが学習していない社内固有の情報に対応する場合に効果的です。
ただし、検索対象のデータが整備されていないと、間違った情報を引いてしまい逆効果になる場合もあります。RAGにおけるメタデータ活用の詳細は下記を参照してください。
特定のタスクに特化したデータでモデルを追加学習させる手法です。高品質な教師データが大量に必要で、コストと時間がかかりますが、特定領域での精度を大きく向上させる可能性があります。
AIの入出力にチェック機構を設け、不適切な回答をブロック・修正する手法です。精度そのものを上げるというより、「低品質な出力をユーザーに届けない」ことで実質的な精度を担保します。
ガードレールの設計と実装の詳細は下記を参照してください。
| 手法 | コスト | 導入難易度 | 精度向上の期待値 | 適したケース |
|---|---|---|---|---|
| プロンプトエンジニアリング | 低 | 低 | 中 | まず最初に試す。即効性がある |
| RAG | 中 | 中 | 中〜高 | 社内ナレッジに基づく回答が必要な場合 |
| ファインチューニング | 高 | 高 | 高 | 大量の教師データがあり、特定タスクに特化する場合 |
| ガードレール | 中 | 中 | 中 | 誤回答の影響が大きく、品質保証が必要な場合 |
三度申しあげますが、これらを全て組み合わせても、精度100%にはなりません。技術的施策は精度を高める手段ですが、残りの数%を埋めるには「運用」が必要です。
曖昧なプロンプトと、制約を明示したプロンプトの違いを見てみましょう。
from openai import OpenAI

client = OpenAI()

# ❌ Before: 曖昧なプロンプト
bad_prompt = "この製品のレビューを分析して"

# ✅ After: 役割・制約・出力形式を明示したプロンプト
good_prompt = """\
あなたは製品レビューの分析担当です。以下のルールに従ってください。

【ルール】
- レビュー文を「ポジティブ」「ネガティブ」「中立」の3つに分類する
- 判定理由を1文で述べる
- 確信度を「高」「中」「低」で示す
- 確信度が「低」の場合は「要人間確認」と明記する

【出力形式】
{"sentiment": "ポジティブ|ネガティブ|中立", "reason": "理由", "confidence": "高|中|低", "needs_review": true|false}
"""

review_prompt = """\
【レビュー文】
バッテリーは長持ちするが、カメラの画質がいまいち。値段を考えると悪くはない。
"""

response_bad = client.responses.create(
    model="gpt-5.2",
    max_output_tokens=300,
    input=f"{bad_prompt}\n\n{review_prompt}",
)

print("【曖昧なプロンプト】")
print(response_bad.output_text)

response_good = client.responses.create(
    model="gpt-5.2",
    max_output_tokens=300,
    input=f"{good_prompt}\n\n{review_prompt}",
)

print("\n【明確なプロンプト】")
print(response_good.output_text)
出力例:
【曖昧なプロンプト】
以下のレビュー文から読み取れるポイントを整理して分析します。

## 1) 総合評価(結論)
- **価格相応で「悪くはない」**という評価。強い満足ではないが、一定の納得感がある“コスパ寄りの可”というトーンです。

## 2) ポジティブ要素(強み)
- **バッテリーが長持ち**
  - 日常利用での安心感につながる主要メリット。
  - 外出時や充電頻度を減らしたい人には刺さりやすいポイント。

## 3) ネガティブ要素(弱み・不満)
- **カメラ画質がいまいち**
  - 写真・動画重視のユーザーにはマイナス。
  - “いまいち”は致命的欠陥というより、期待との差(特に同価格帯の他製品や宣伝イメージとの差)を示唆します。

## 4) 価格とのバランス(評価の基準)
- 「**値段を考えると悪くはない**」から、購入者は品質を価格に照らして判断しています。
- 高性能を求める層というより、**コスト重視で割り切って

【明確なプロンプト】
{"sentiment":"中立","reason":"バッテリーの長持ちを評価しつつカメラ画質に不満もあり、総合的に「値段を考えると悪くはない」と良否が混在しているため。","confidence":"高","needs_review":false}
Before(曖昧なプロンプト)では自由記述の長文が返り、後続処理で使いにくい出力になります。トークン量も多くなり、コストが嵩みます。After(制約を明示したプロンプト)では、構造化された出力が得られ、さらに確信度が低い場合に人間確認へ回す設計まで組み込めます。
テストケースを用意してLLMの正答率を測定するスクリプトです。実際に動かすと、精度が100%にならないことを体感できます。
from openai import OpenAI

client = OpenAI()

# テストケース:レビュー文と正解ラベル
test_cases = [
    {"review": "最高の商品です!大満足!", "expected": "ポジティブ"},
    {"review": "まったく使い物にならない。返品したい。", "expected": "ネガティブ"},
    {"review": "可もなく不可もなく、普通です。", "expected": "中立"},
    {"review": "デザインは好きだけど、すぐ壊れた。", "expected": "ネガティブ"},
    {"review": "値段相応。特に不満はない。", "expected": "中立"},
    {"review": "期待以上の品質でした。", "expected": "ポジティブ"},
    {"review": "悪くはないが、もう少し安ければ…", "expected": "中立"},
    {"review": "二度と買わない。", "expected": "ネガティブ"},
    {"review": "友人にもすすめたい商品。", "expected": "ポジティブ"},
    {"review": "届くのが遅かったが、物自体は良い。", "expected": "ポジティブ"},
]

prompt_template = """\
以下のレビューを「ポジティブ」「ネガティブ」「中立」のいずれか1語で分類してください。
分類結果のみを出力し、それ以外は何も出力しないでください。

レビュー: {review}
"""

correct = 0
results = []
labels = ("ポジティブ", "ネガティブ", "中立")

for case in test_cases:
    response = client.responses.create(
        model="gpt-5.2",
        max_output_tokens=100,
        input=prompt_template.format(review=case["review"]),
    )
    raw_answer = response.output_text.strip()
    answer = next((label for label in labels if label in raw_answer), raw_answer)
    is_correct = answer == case["expected"]
    correct += int(is_correct)
    results.append(
        {
            "review": case["review"][:15],
            "expected": case["expected"],
            "answer": answer,
            "ok": "✅" if is_correct else "❌",
        }
    )

print(f"正答率: {correct}/{len(test_cases)} ({correct / len(test_cases) * 100:.0f}%)\n")
for r in results:
    print(f"  {r['ok']} {r['review']}… → 予測: {r['answer']} (正解: {r['expected']})")
出力例:
正答率: 9/10 (90%)

  ✅ 最高の商品です!大満足!… → 予測: ポジティブ (正解: ポジティブ)
  ✅ まったく使い物にならない。返品… → 予測: ネガティブ (正解: ネガティブ)
  ✅ 可もなく不可もなく、普通です。… → 予測: 中立 (正解: 中立)
  ✅ デザインは好きだけど、すぐ壊れ… → 予測: ネガティブ (正解: ネガティブ)
  ✅ 値段相応。特に不満はない。… → 予測: 中立 (正解: 中立)
  ✅ 期待以上の品質でした。… → 予測: ポジティブ (正解: ポジティブ)
  ✅ 悪くはないが、もう少し安ければ… → 予測: 中立 (正解: 中立)
  ✅ 二度と買わない。… → 予測: ネガティブ (正解: ネガティブ)
  ✅ 友人にもすすめたい商品。… → 予測: ポジティブ (正解: ポジティブ)
  ❌ 届くのが遅かったが、物自体は良… → 予測: 中立 (正解: ポジティブ)
このように、明確に見えるレビューは正しく分類できますが、ニュアンスが曖昧なケース(「悪くはないが…」「届くのが遅かったが物は良い」など)ではブレが出ます。これが生成AIの確率的な性質です。同じスクリプトを再実行すると、結果が変わることもあります。
技術的な施策で精度を高めた上で、残りの数%をカバーするのは人間を含めた運用設計です。
Human-in-the-Loop(HITL)とは、AIの処理フローの中に人間の判断ポイントを組み込む設計思想です。
フローは以下のようになります。
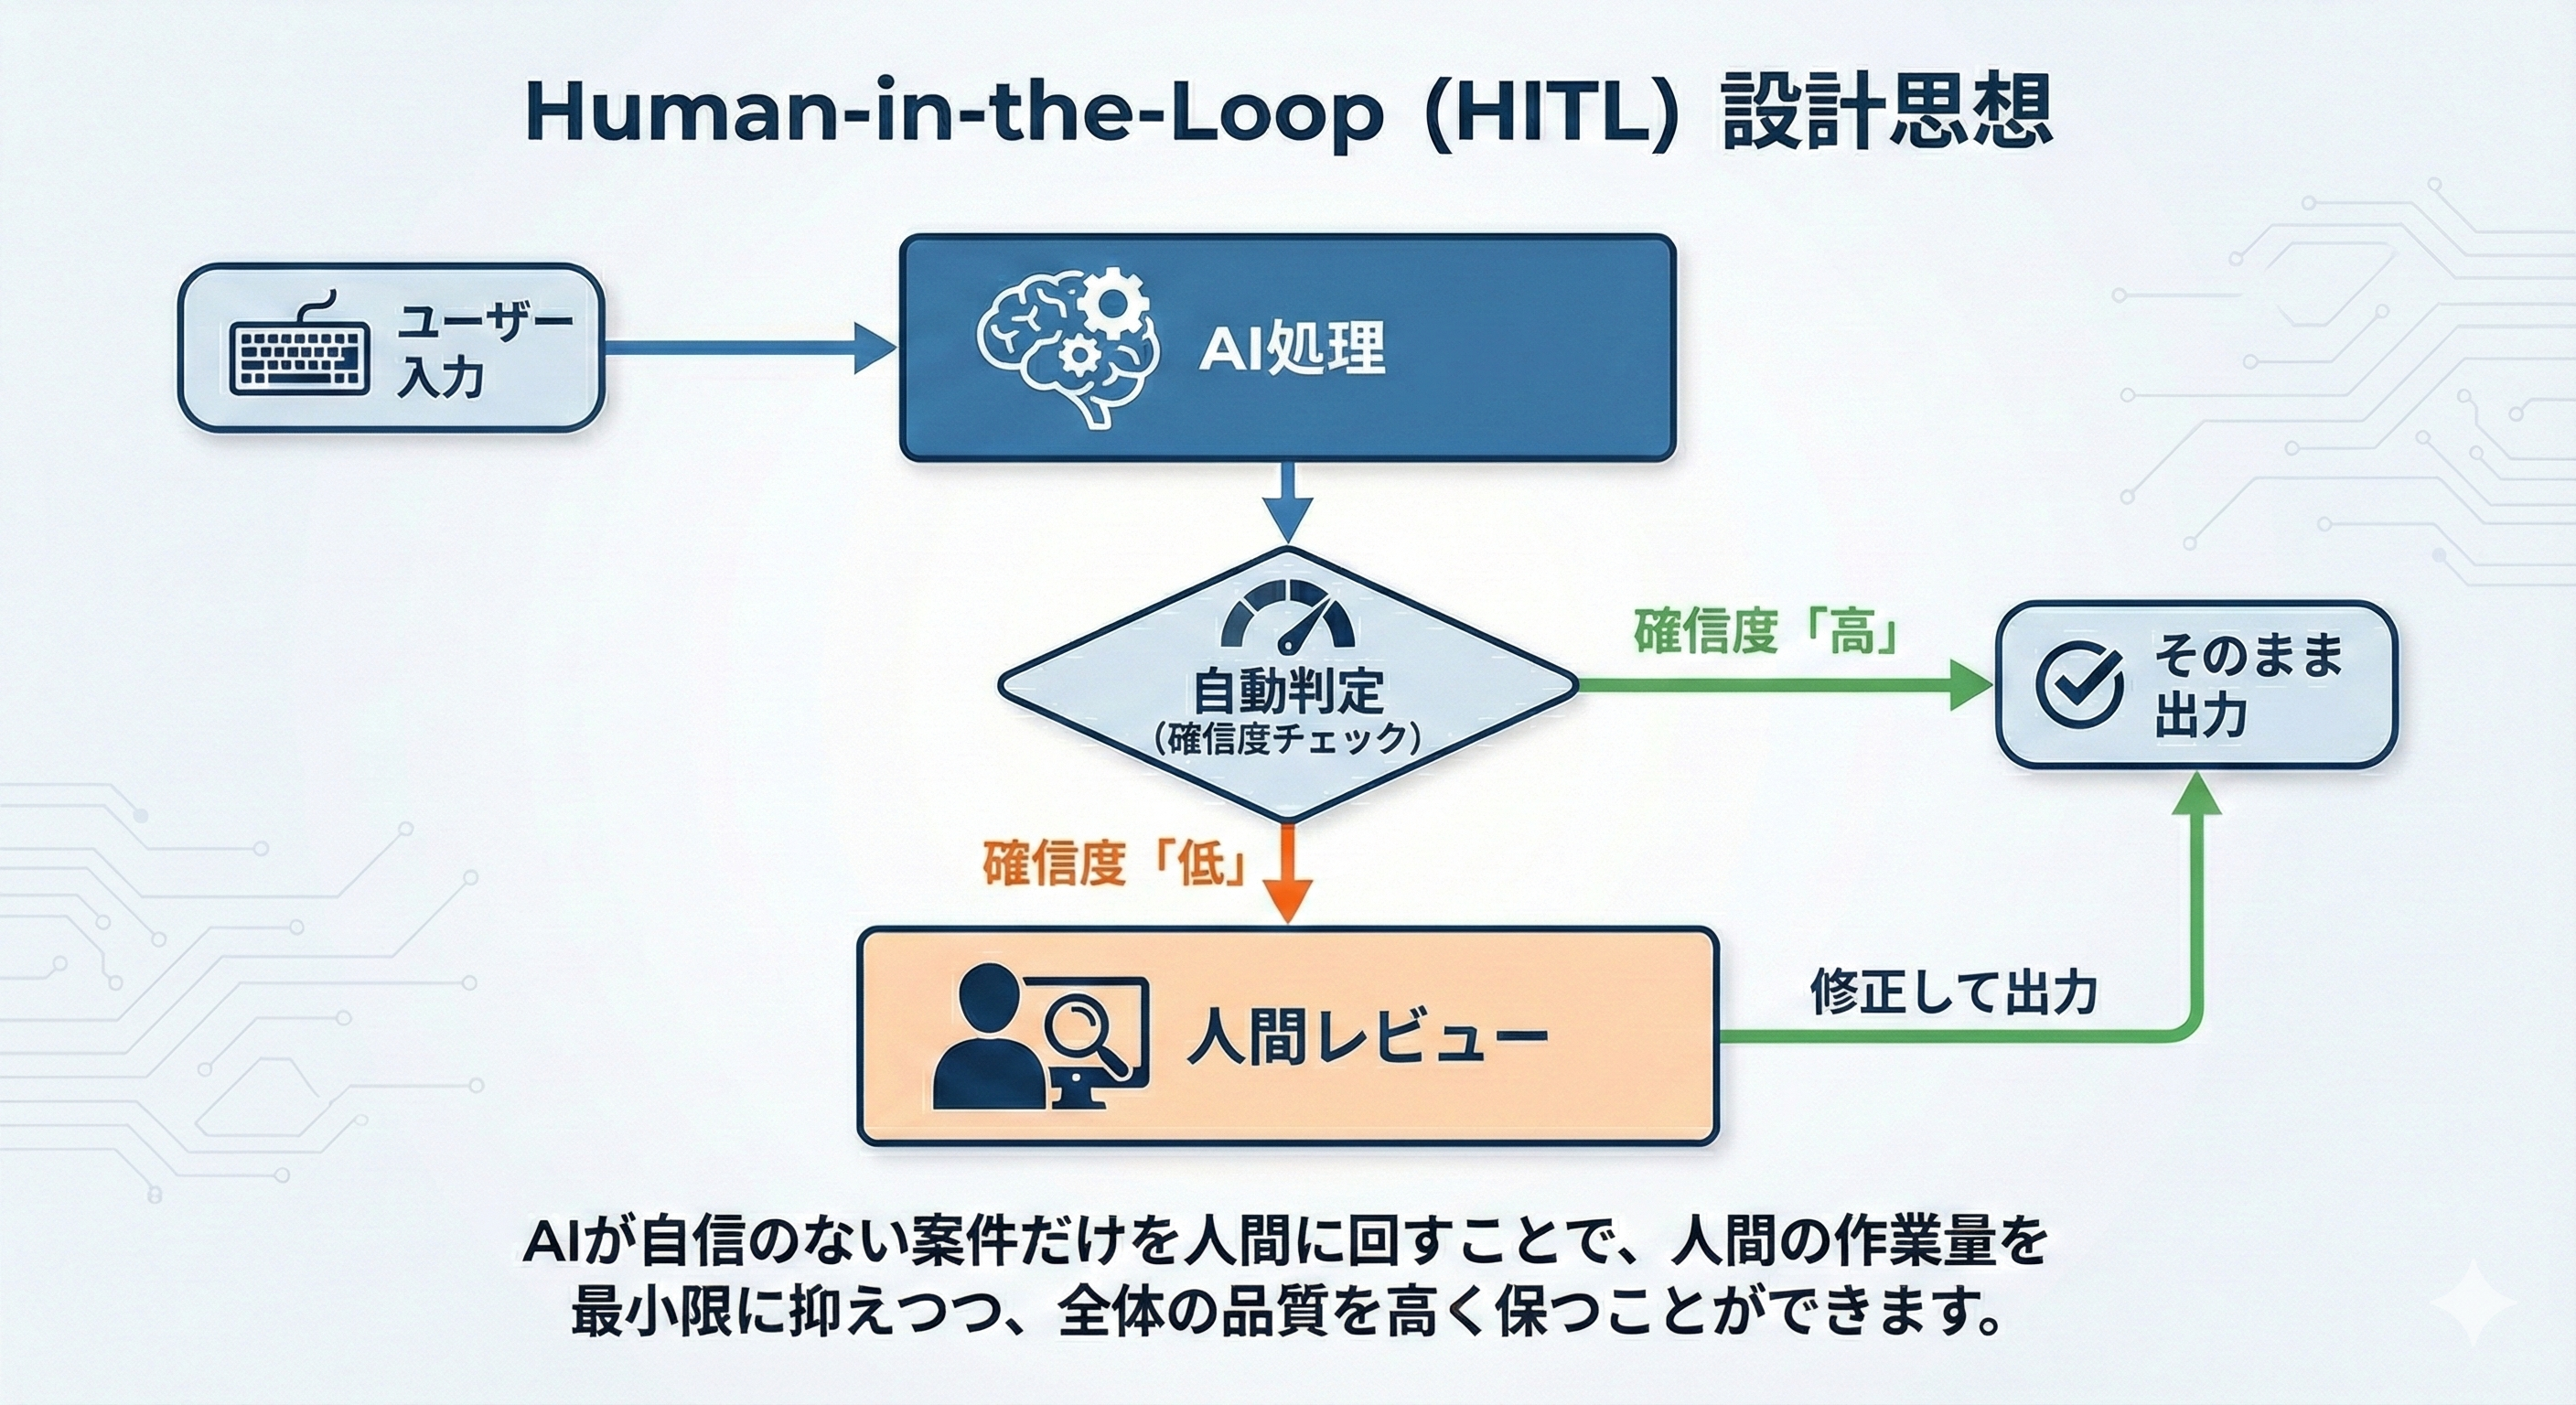
全件を人間がチェックするのではなく、AIが自信のない案件だけを人間に回す。これにより、人間の作業量を最小限に抑えつつ、全体の品質を高く保つことができます。
Human-in-the-Loopを導入すると、業務の構造がどう変わるか見てみましょう。
| 方式 | 人間の作業量 | 品質 | コスト | 特徴 |
|---|---|---|---|---|
| 従来(全て人手) | 100件/100件 | 高 | 高 | 品質は出るが、スケールしない |
| AI+全件確認 | 100件/100件 | 高 | 中 | AIが下書き→人が全件チェック |
| AI+例外確認 | 20件/100件 | 高 | 低 | AIが処理→確信度が低い案件のみ人が確認 |
3つ目の「AI+例外確認」がHuman-in-the-Loopの本質です。AIが100件を処理し、そのうち確信度の高い80件はそのまま通す。残りの20件だけ人間が確認・修正する。これだけで人間の作業量は80%削減されます。
Human-in-the-Loopを設計する前に、「AIのミスが起きたとき何が起きるか」を整理しておく必要があります。以下の5問に答えることで、どこまでAIに任せてよいかが見えてきます。
| # | 問い | 考えるポイント |
|---|---|---|
| 1 | AIが間違えたら何が起きる? | 顧客クレーム? 社内修正で済む? 法的リスク? |
| 2 | 間違いに気づけるタイミングは? | 即座? 翌日? 1ヶ月後? |
| 3 | 修正にかかるコストは? | 5分で直せる? 取り返しがつかない? |
| 4 | 間違いの頻度はどの程度なら許容できる? | 100件中1件? 10件中1件? |
| 5 | 人間がやっても間違える作業か? | 人間のミス率は? AIと比べてどうか? |
5番目の問いは特に重要です。人間が行っても5%ミスする作業であれば、AIの精度が95%でも同等です。AIだけに完璧を求めるのはフェアではありません。
精度を評価軸にすると「100%でなければ失敗」という議論になりがちです。代わりに「効率」を評価軸にすると、AIの価値を正しく測れます。
考え方はシンプルです。
AI導入のROI = 削減できた工数のコスト − (AI利用料 + 人間の修正コスト)
たとえば、月に100件の作業があり、1件あたり30分かかっていたとします。
精度が80%でも、76%の工数削減が実現できます。「精度80%=使えない」ではなく、「精度80%=76%の効率化」と捉えることが重要です。
最初から完璧を目指すのではなく、段階的にAIの自律度を高めていくのが現実的なアプローチです。
| フェーズ | 名称 | 人間の関与 | AIの役割 | 精度目標 |
|---|---|---|---|---|
| Phase 1 | 試用 | 全件確認 | 下書き生成のみ | 70%〜で十分 |
| Phase 2 | 補助 | 例外確認(30%程度) | 一次処理+信頼度判定 | 80〜85% |
| Phase 3 | 協働 | 例外確認(10%程度) | 大半を自律処理 | 90〜95% |
| Phase 4 | 自律 | 定期監査のみ | ほぼ全件を自律処理 | 95%以上 |
Phase 1から始めて、データと実績を積みながらPhase 2、3へと進めていく。各フェーズで効果を測定し、次に進むか判断する。この「段階的なアプローチ」が、生成AI活用で最も成功率が高い進め方です。
本記事のキーメッセージを5つにまとめます。
生成AIで成功する企業は、「精度100%」を追い求める企業ではありません。人とAIの補完関係を設計し、段階的に成熟度を高められる企業です。まずはPhase 1の小さな試みから始めてみてください。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。