生成AI関連
Amazon Bedrock Knowledge Base × S3 VectorsでRAGを作って…
前回の記事では、基盤モデルパーサーがグラフやスキャン画像からテキストを取り出せることを確認しました。ただ、実際に運用するかどうかを決めるとなると、別の情報が必要になります。同期のたびにモデルが何回呼ばれ、何トークンを消費し、いくらかかるのか。そして、検索結果はどのような形でアプリケーションへ返ってくるのか。どちらもマネジメントコンソールの画面には表示されません。
そこで、前回と同じ3種類のPDF(テキストだけ・グラフを含む・スキャン画像だけ)をもう一度同期し、Model invocation loggingとRetrieve APIのレスポンスから実測しました。本記事で確認するのは次の4点です。
Knowledge Basesの構築手順、Model invocation loggingの設定、パーサーの種類ごとの違いは、それぞれ次の記事で扱っています。
Knowledge Basesのデータ取り込みは、文書のパース、チャンク分割、埋め込み生成、ベクトルストアへの保存という順に進みます。料金とレスポンスを読み解くには、この4つを混ぜずに観測する必要があります。パーサーへの入力単位と、Retrieveが返す検索結果の単位は、必ずしも一致しないためです。
観測に使ったのは、Model invocation loggingとRetrieve APIのレスポンスです。Knowledge Bases内部からのモデル呼び出しもログに記録されるため、パーサーと埋め込みモデルの呼び出しはどちらも追えます。
ログの出力先はCloudWatch LogsとS3から選べます。本記事ではS3へ出力したログを使用しました。
| 段階 | 確認した内容 | 確認先 |
|---|---|---|
| パーサー入力 | ページ画像と抽出済みテキストの有無 | Model invocation logging |
| パーサー出力 | 生成されたテキストと入出力トークン数 | Model invocation logging |
| 埋め込み入力 | 埋め込みへ渡されたテキストとトークン数 | Model invocation logging |
| Retrieve結果 | content.type、返却フィールド、メタデータ | Retrieve APIのレスポンス |
検証対象のPDFは前回と同じ3ファイルです。パーサー以外の設定は固定し、3ファイルを1つずつ個別に同期しました。まとめて同期すると、どのログがどのPDFのものか判断しづらくなるためです。
| 項目 | 設定 |
|---|---|
| AWSリージョン | ap-northeast-1 |
| データソース | Amazon S3 |
| 解析戦略 | 基盤モデルパーサー |
| 解析用モデル | jp.anthropic.claude-haiku-4-5-20251001-v1:0 |
| 解析用プロンプト | デフォルト |
| チャンク戦略 | 固定(3,072トークン/オーバーラップ10%) |
| 埋め込みモデル | amazon.titan-embed-text-v2:0 |
| ベクトルストア | Amazon S3 Vectors |
| PDFのページ数 | テキスト:3/グラフ:6/スキャン:1 |
| 検証日 | 2026年8月21日 |
ログを確認すると、解析用モデルの呼び出し回数はPDFのページ数と完全に一致しました。3ページのPDFでは3回、6ページでは6回、1ページでは1回です。
| ページ数 | パーサー呼び出し回数 | 入力トークン | 出力トークン | |
|---|---|---|---|---|
| テキストだけ | 3 | 3 | 10,286 | 3,734 |
| グラフを含む | 6 | 6 | 16,666 | 4,053 |
| スキャン画像だけ | 1 | 1 | 2,160 | 300 |
| 合計 | 10 | 10 | 29,112 | 8,087 |
入力の内容にも共通点がありました。3種類のPDFすべてで、モデルへの入力にページを画像化したデータが含まれていました。テキストレイヤーを持つPDFでは、抽出済みのテキストも同じ入力に同梱されます。一方、モデルからの出力はいずれもテキストだけでした。
次のログは、テキストだけのPDFの1ページを解析した1回分の呼び出しです。長い行は右端で見切れています。
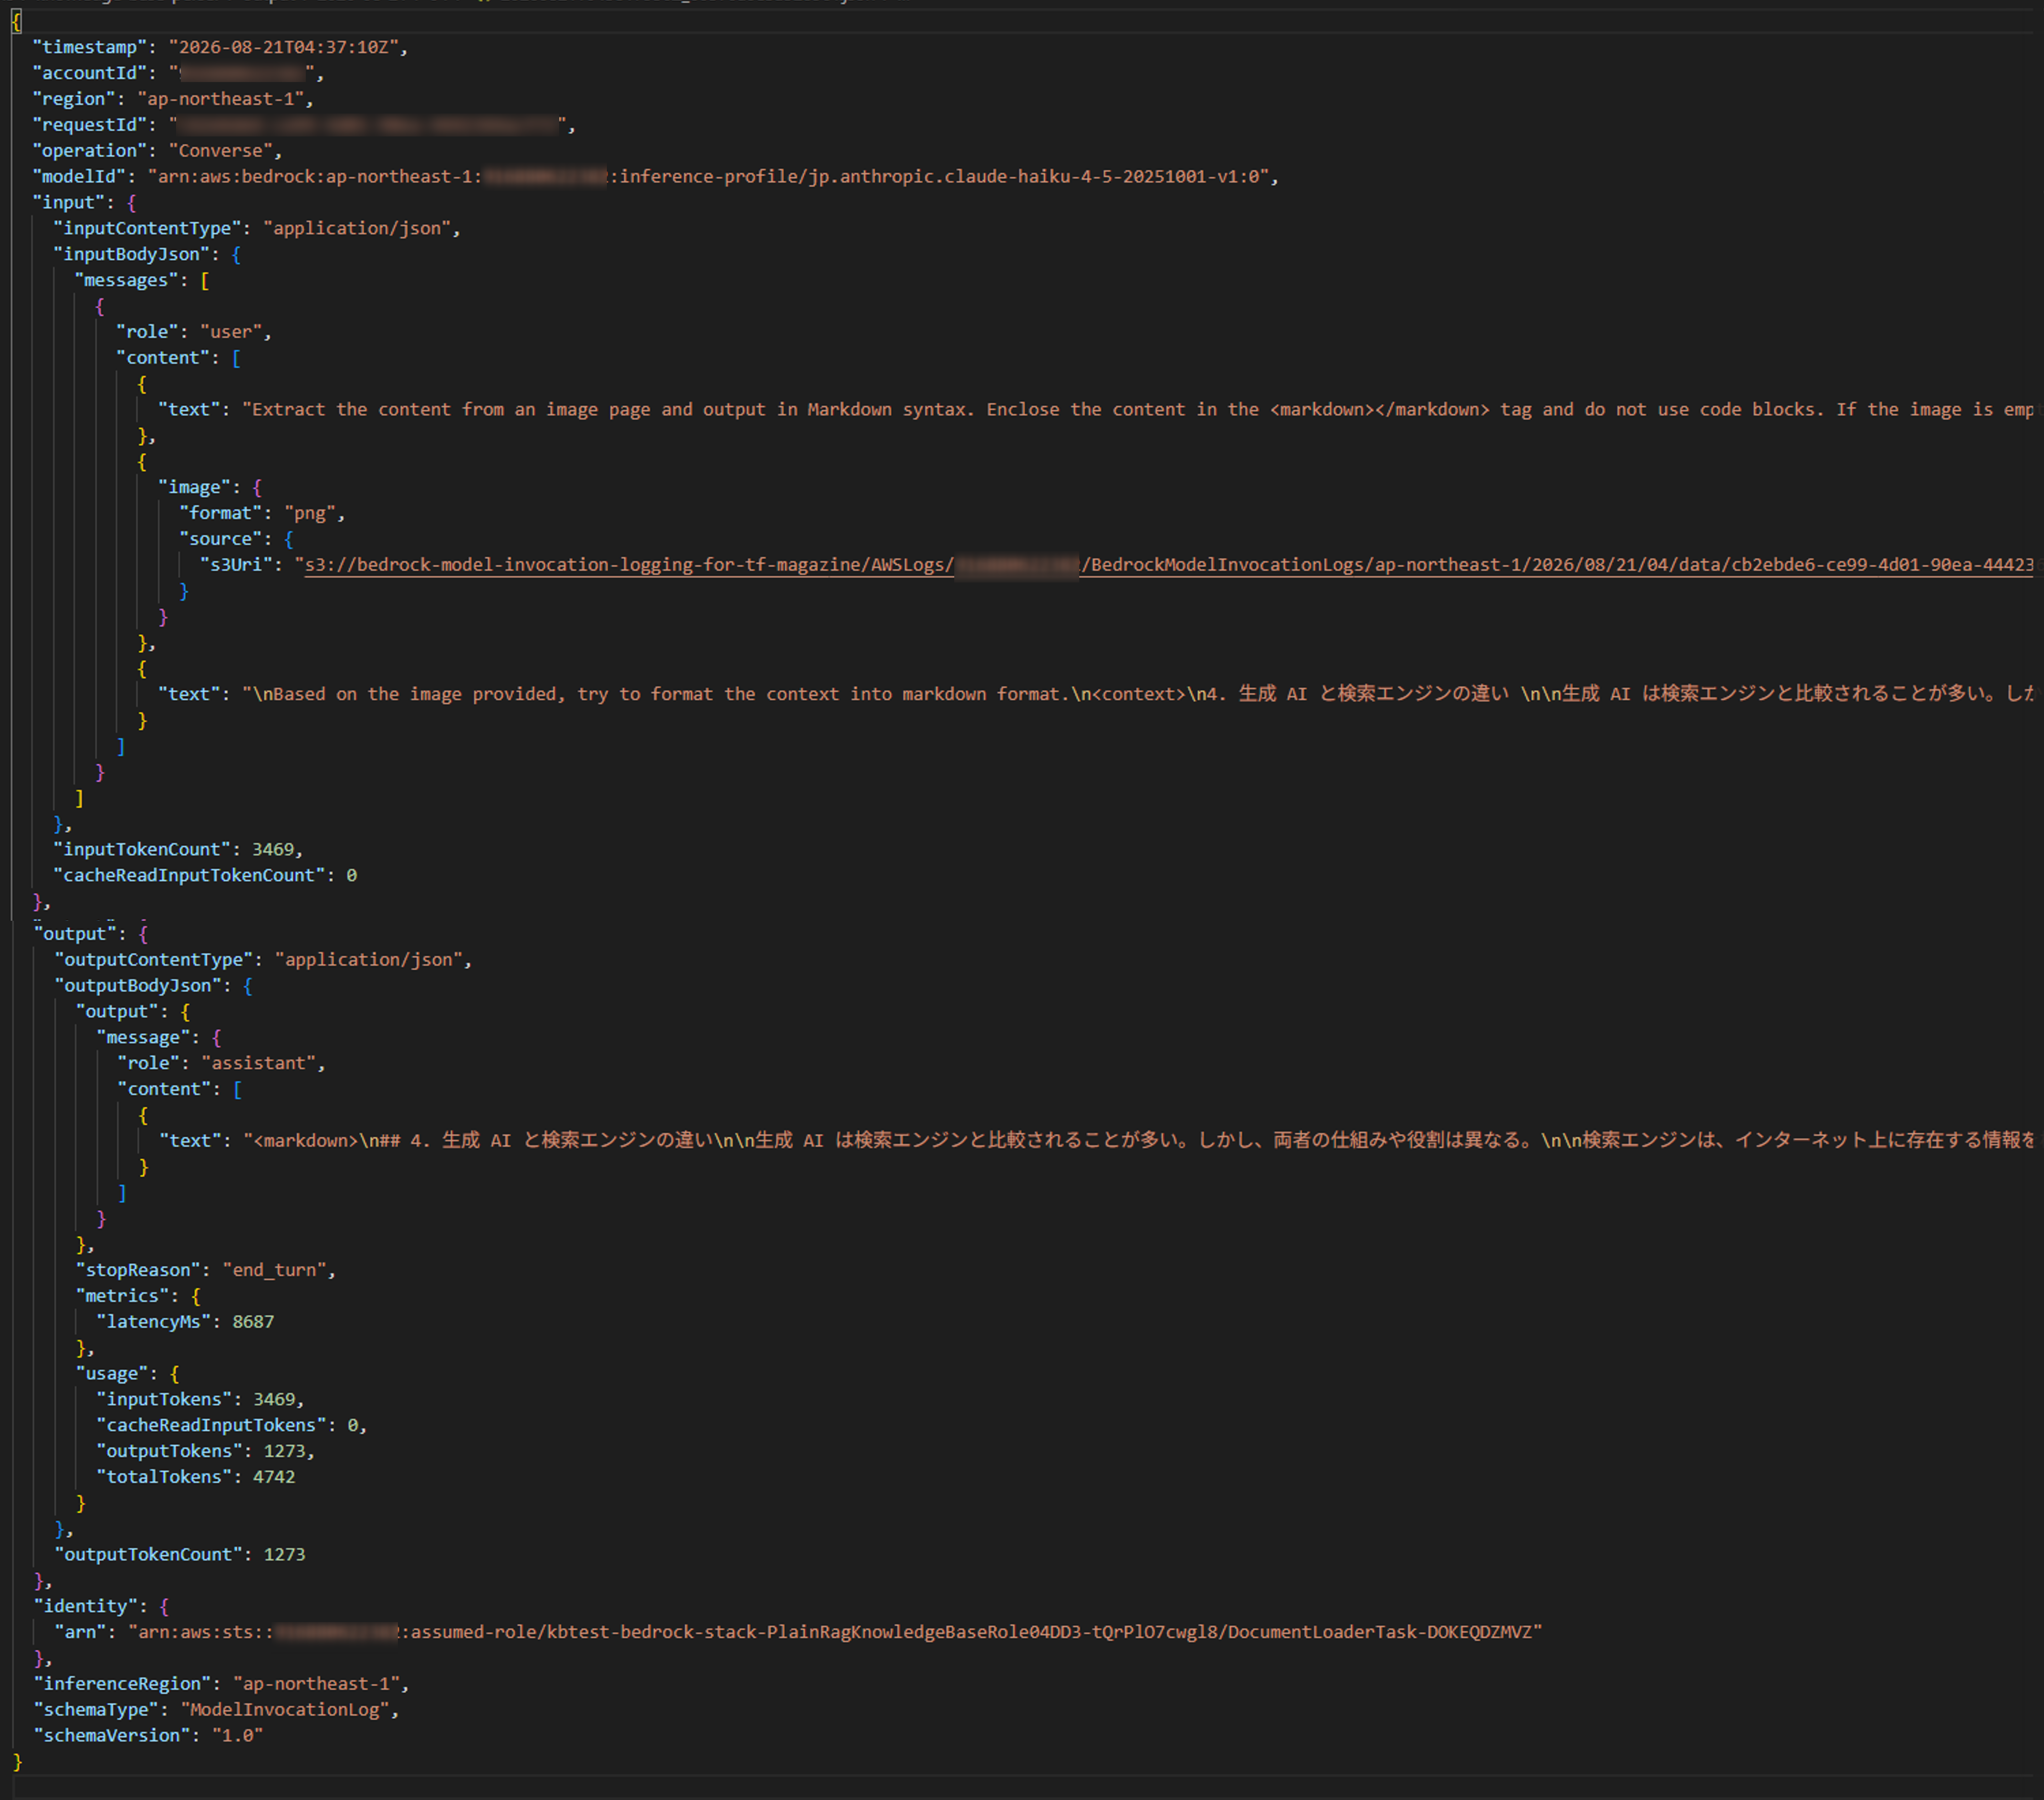
呼び出しに使われているAPIはConverseで、入力は3つのブロックで構成されています。1つ目はデフォルトの解析用プロンプトです。画像ページの内容をMarkdown構文で出力し、<markdown>タグで囲むよう指示しています。2つ目がページを画像化したPNG、3つ目がPDFから抽出済みのテキストです。抽出済みテキストは<context>タグで囲まれ、画像を読み取るときの参照情報として渡されています。
出力は<markdown>タグで囲まれたテキスト1ブロックだけです。この呼び出しでは入力が3,469トークン、出力が1,273トークンでした。
ページ画像の記録方法は、ログの出力先によって変わります。S3へ出力した場合は、上のログのように画像のS3パスが記録されます。CloudWatch Logsへ出力した場合は、画像のバイト列がログ本体に記録されます。同じ内容を確認するつもりでも、出力先によってログの見た目は大きく変わります。
つまり、基盤モデルパーサーは「1ページを画像として見て、その内容をMarkdownへ書き起こす」処理を、ページ数だけ繰り返しています。ページ数から呼び出し回数を見積もれるため、解析料金は事前に概算できます。
基盤モデルパーサーの料金は、解析用モデルの入出力トークン数で決まります。今回使ったClaude Haiku 4.5の単価は、入力が100万トークンあたり1.00ドル、出力が5.00ドルです(2026年8月時点、ap-northeast-1)。単価はモデル、推論方式、リージョンによって変わるため、見積もり時はAmazon Bedrock料金ページで確認してください。
| 料金 | 計算方法 |
|---|---|
| 入力料金 | 入力トークン合計 ÷ 100万 × 入力単価 |
| 出力料金 | 出力トークン合計 ÷ 100万 × 出力単価 |
| パーサー料金 | 入力料金 + 出力料金 |
この式で計算した結果が次の表です。円換算は1ドル=165円としています。
| ページ数 | 入力トークン | 出力トークン | パーサー料金 | 円換算 | 1ページあたり | |
|---|---|---|---|---|---|---|
| テキストだけ | 3 | 10,286 | 3,734 | $0.028956 | ¥4.78 | ¥1.59 |
| グラフを含む | 6 | 16,666 | 4,053 | $0.036931 | ¥6.09 | ¥1.02 |
| スキャン画像だけ | 1 | 2,160 | 300 | $0.003660 | ¥0.60 | ¥0.60 |
| 合計 | 10 | 29,112 | 8,087 | $0.069547 | ¥11.48 | ¥1.15 |
10ページで11.48円、1ページあたり1.15円です。1,000ページの文書群を同期しても1,200円程度に収まる計算になります。基盤モデルを使う解析としては、金額そのものは大きくありません。
ただし、1ページあたりの内訳を見ると、直感とは逆の結果が出ています。最も高いのはテキストだけのPDF(1.59円)で、グラフを含むPDF(1.02円)より高く、スキャン画像だけのPDF(0.60円)の2倍以上です。視覚情報が多いほど高くなるわけではありません。
理由は、本文のテキストが入力と出力の両方でカウントされることです。
入力の内訳は、解析用プロンプト、ページ画像、抽出済みの本文テキストの3つでした。テキストレイヤーを持たないスキャンPDFには、このうち本文テキストがありません。実際、1ページあたりの入力トークンはスキャンPDFが2,160で、これがプロンプトとページ画像だけの場合のおおよその量にあたります。ここへ本文が加わると、グラフPDFは2,778、テキストPDFは3,429まで増えました。増分はそれぞれ約620トークンと約1,270トークンです。
一方、1ページあたりの出力トークンはグラフPDFが676、テキストPDFが1,245でした。入力に加算された本文の分と、ほぼ同じ規模です。パーサーは本文を入力として受け取り、同じ本文をMarkdownとして書き出すため、本文の量が入力と出力に1回ずつ乗ります。
しかも出力単価は入力単価の5倍です。今回の合計では、料金の約6割が出力側で発生しました。文字がびっしり詰まったページほど、入力と出力の両方が膨らみ、そのうえ増えた分の多くが5倍の単価で課金されます。図やグラフが多いページのほうが安いのは、書き起こすテキストが少ないからです。
そしてもう1点、費用面で押さえておきたい挙動があります。PDFがテキストだけで構成されていても、デフォルトパーサーに自動で切り替わることはありません。基盤モデルパーサーを指定した以上、視覚情報を含まないページも基盤モデルへ渡され、料金が発生します。
パーサーが出力したテキストは、指定したチャンク戦略で分割された後、埋め込みモデルへ渡されます。この段階もログに記録されるため、同じように実測できます。
今回使ったAmazon Titan Text Embeddings V2の単価は、入力が1,000トークンあたり0.000029ドル(100万トークンあたり0.029ドル)です(2026年8月時点、ap-northeast-1)。埋め込みモデルは入力のみの課金で、出力側の料金はありません。単価はリージョンによって差があるため、Amazon Bedrock料金ページで自分のリージョンの値を確認してください。
| ページ数 | 埋め込み呼び出し回数 | 入力トークン | 埋め込み料金 | 円換算 | |
|---|---|---|---|---|---|
| テキストだけ | 3 | 3 | 4,195 | $0.00012166 | ¥0.0201 |
| グラフを含む | 6 | 16 | 4,270 | $0.00012383 | ¥0.0204 |
| スキャン画像だけ | 1 | 4 | 339 | $0.00000983 | ¥0.0016 |
| 合計 | 10 | 23 | 8,804 | $0.00025532 | ¥0.0421 |
10ページ分の埋め込み料金は合計0.04円で、同じPDFのパーサー料金11.48円に対して約270分の1でした。基盤モデルパーサーを使う場合、費用の見積もりはパーサー側だけを見ればほぼ足ります。
トークン数も比較しておきます。パーサーの出力が合計8,087トークン、埋め込みへの入力が8,804トークンで、ほぼ同じ規模です。パーサーが書き起こしたテキストが、そのまま埋め込みへ流れていると考えて差し支えありません。ただし両者はトークナイザーが異なるため、数値の一致そのものに意味を求めないでください。
一方、呼び出し回数はページ数と一致しませんでした。3ページのテキストPDFは3回でしたが、6ページのグラフPDFは16回、1ページのスキャンPDFは4回です。1回あたりの入力トークンを割り戻すと、テキストPDFは約1,400、グラフPDFは約270、スキャンPDFは約85となり、指定した3,072トークンの上限にはどれも達していません。
ここから「呼び出し1回=チャンク1件」と読みたくなりますが、そう断定はできません。チャンク分割の仕組みを説明した公式ドキュメントには、基盤モデルパーサーのような高度なパーサーで解析した内容はページやセクションの論理境界をまたいで結合されないと記載がありますが、内部のモデル呼び出しとベクトルストアに保存されるチャンクがどう対応するかまでは書かれていません。サービス内部でまとめて処理されている可能性もあります。ログから読み取れるのは呼び出し回数と入力テキストまでで、チャンクの境界はここでは確定できません。
ここからはレスポンス側です。Knowledge BasesのRetrieve APIは、検索結果をretrievalResults配列で返します。RetrievalResultContentの定義どおり、各要素のcontent.typeを見れば、その結果がテキスト、画像、行、音声、動画のどれなのかを判別できます。
| content.type | 読むフィールド | 内容 |
|---|---|---|
| TEXT | content.text | 検索されたテキストチャンク |
| IMAGE | content.byteContent | Base64でエンコードされた画像のData URI |
| ROW | content.row | 構造化データの行 |
| AUDIO | content.audio | 音声セグメント |
| VIDEO | content.video | 動画セグメント |
今回の3ファイルで実際に返ってきた種別は、次のとおりでした。
| パーサーへの入力 | パーサーの出力 | Retrieveのcontent.type | |
|---|---|---|---|
| テキストだけ(TEXT_ONLY) | ページ画像とテキスト | テキスト | TEXT |
| グラフを含む(TEXT_AND_GRAPH) | ページ画像とテキスト | テキスト | IMAGE |
| スキャン画像だけ(SCAN_PDF) | ページ画像 | テキスト | TEXT |
同じデータソース、同じパーサー、同じ設定でも、TEXTとIMAGEの両方が返っています。パーサーの出力はすべてテキストだったにもかかわらず、グラフを含むPDFだけは画像として返ってきました。「基盤モデルパーサーを使うと常にbyteContentで返る」という理解も、「出力がテキストだからtextで返る」という理解も、どちらも成り立ちません。
ナレッジベースへの問い合わせを説明した公式ドキュメントには、Retrieveがテキストチャンクまたは抽出した画像を返すことは書かれていますが、どちらを選ぶかの条件は明記されていません。今回の結果も、その条件を特定できるものではありません。PDFの構成やパーサーの種類から返却形式を決め打ちしないほうが安全です。
次の例は、実際のレスポンスからIMAGEとTEXTの結果を1件ずつ抜き出したものです。Request ID、アクセス制御用の値、長いBase64文字列、本文は省略し、S3バケット名は匿名化しています。文字列中の"…"は省略部分を表します。
{
  "retrievalResults": [
    {
      "content": {
        "type": "IMAGE",
        "byteContent": "data:image/png;base64,..."
      },
      "location": {
        "s3Location": {
          "uri": "s3://<source-bucket>/documents/TEXT_AND_GRAPH.pdf"
        },
        "type": "S3"
      },
      "metadata": {
        "x-amz-bedrock-kb-document-page-number": 4.0,
        "x-amz-bedrock-kb-description": "<figure>\nFigure: Concerns about using generative AI features in PDF\n...\n</figure>",
        "documentName": "TEXT_AND_GRAPH.pdf",
        "x-amz-bedrock-kb-byte-content-source": "s3://<multimodal-bucket>/.../image.png"
      }
    }
    {
      "content": {
        "type": "TEXT",
        "text": "## 4. 生成 AI と検索エンジンの違い\n生成 AI は..."
      },
      "location": {
        "s3Location": {
          "uri": "s3://<source-bucket>/documents/TEXT_ONLY.pdf"
        },
        "type": "S3"
      },
      "metadata": {
        "x-amz-bedrock-kb-document-page-number": 1.0,
        "documentName": "TEXT_ONLY.pdf"
      }
    }
  ]
}
typeがIMAGEならbyteContent、TEXTならtextが、同じcontentオブジェクトの中に入ります。フィールド名が違うだけで、階層は同じです。
実装上の注意点はここです。content.textの有無だけで分岐すると、画像の結果を静かに取りこぼします。最初にcontent.typeを判定し、TEXTとIMAGEを別々に処理してください。
もっとも、この違いを扱う必要があるかは構成によります。RetrieveAndGenerateのようにKnowledge Basesへ検索から回答生成まで任せる場合、種別の判定はサービス側で完結するため、アプリケーションで意識する場面は限られます。Retrieveだけを呼び出して独自にプロンプトを組み立てる場合は、結果種別に応じた処理が必要です。
画像として返ってきた結果には、contentのほかに2つの値が付いていました。x-amz-bedrock-kb-byte-content-sourceとx-amz-bedrock-kb-descriptionです。前者は、抽出された画像が保存されているマルチモーダルストレージのS3 URIを示します。
なお、AWS公式ユーザーガイドはこの2つを「レスポンスヘッダー」と説明しています。
If the retrieved data contains images, the response also returns the following response headers, which contain metadata for source chunks returned in the response
しかし今回のレスポンスでは、どちらも各検索結果のmetadataオブジェクトの中に入っていました。
注意したいのは後者の中身です。同じユーザーガイドは、x-amz-bedrock-kb-descriptionを画像のBase64文字列として説明しています。しかし今回のTEXT_AND_GRAPHでは、このフィールドに入っていたのはBase64文字列ではなく、<figure>タグで囲まれたパース後のテキストでした。図のキャプションと内容の説明が、そのまま読める形で格納されています。
画像結果でもパース後のテキストが手に入るため、独自にプロンプトを組み立てる場合は使い道があります。ただし、公式の説明と実測が食い違っている状態なので、仕様として当てにするのは避けたほうがよいでしょう。ここで示したのは、Claude Haiku 4.5をパーサー、Amazon Titan Text Embeddings V2を埋め込みモデルとし、ap-northeast-1で実行した1回の検証結果です。今後仕様が変わる可能性もあるため、実装前に、自分の環境のレスポンスを保存して確認してください。
実測値をまとめると、基盤モデルパーサーの費用は次のように動きます。料金はページ数と、そのページに含まれる文字の量で決まります。視覚情報の有無ではありません。テキストが密なページほど入力と出力の両方のトークンが増え、1ページあたりの単価が上がります。
この結果は、データソース分割の判断に直結します。基盤モデルパーサーが必要なのは、グラフやスキャン画像の中にしか情報がないPDFです。テキストレイヤーだけで検索に足りるPDFを同じデータソースに置くと、そのファイルが本文量の多い文書であるほど、無駄な費用が積み上がります。
対策は、文書の種類ごとにデータソースを分けることです。テキスト中心のPDFはデフォルトパーサーのデータソースへ、視覚情報を含むPDFは基盤モデルパーサーのデータソースへ振り分けます。データソースの取り込み設定で指定する解析戦略は、同じデータソース内のファイルへ一律に適用されるため、ファイル単位での切り替えはできません。
なお、解析戦略の種類は、データソースを接続した後に変更できません。同じ種類の中で解析用モデルや解析用プロンプトを変更することはできますが、デフォルトパーサーと基盤モデルパーサーの切り替えは種類の変更にあたるため、後から切り替えたい場合は、新しいデータソースを作成して同期し直すことになります。分割の方針は、最初の設計時点で決めておくほうが手戻りが少なくなります。
基盤モデルパーサーの実測から分かったことを整理します。
費用面のポイントは次の6点です。
レスポンス側で押さえておきたいのは次の3点です。
パーサーの選択は、解析精度だけでなく費用でも決まります。テキストだけのPDFまで基盤モデルへ渡す必要があるかを見直し、文書の種類ごとにデータソースを分けることで、検索できる情報と同期料金のバランスを取れます。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。