生成AI関連
Tool Useとは?モデルとアプリの役割分担から学ぶ生成AIのツール連携
「先月いちばん売れたカテゴリは?」「キャンセルは何件あった?」といった集計は、データベースにSQLを投げれば数秒で答えが出ます。ただ、SQLを書ける人や、テーブルの構造を知っている人は限られます。そのため、こうした問い合わせは特定の担当者に集まりがちです。
自然言語の質問からSQLを生成する技術が、Text-to-SQLです。LLMにSQLを書かせて実行すれば、SQLを書けない人でも社内のデータを直接調べられます。
一方で、LLMが書くSQLは常に正しいとは限りません。列の意味を取り違えた集計が、もっともらしい数値として返ってくることがあります。また、生成されたSQLをそのまま実行する作りでは、意図しないデータの更新や削除が起こりえます。
この記事では、Text-to-SQLの難しさと精度を上げる工夫を整理したうえで、生成されたSQLを実行するときの注意点を説明します。デモでは実装例として、Amazon BedrockのTool Useと組み合わせ、モデルが作ったSQLをSQLiteの架空の注文データに対して読み取り専用で実行します。
Tool Useの基本的な仕組みは、次の記事で説明しています。
Text-to-SQLは、「2026年10月に売上が最も多かった商品カテゴリは?」のような自然言語の質問を、データベースで実行できるSQLに変換する技術です。BIツールやデータベースの管理画面では、SQL生成の機能として広く使われています。たとえばGoogle Cloudでは、BigQuery StudioやCloud SQL Studioなどで利用できます(Google Cloud:AI を使って優れた SQL を作成する:Text-to-SQL 手法の説明)。
自分のアプリに組み込む方法はいくつかありますが、Tool Useとは相性がよい組み合わせです。SQLを受け取って実行するツールをモデルに渡しておくと、次の流れで質問に答えます。
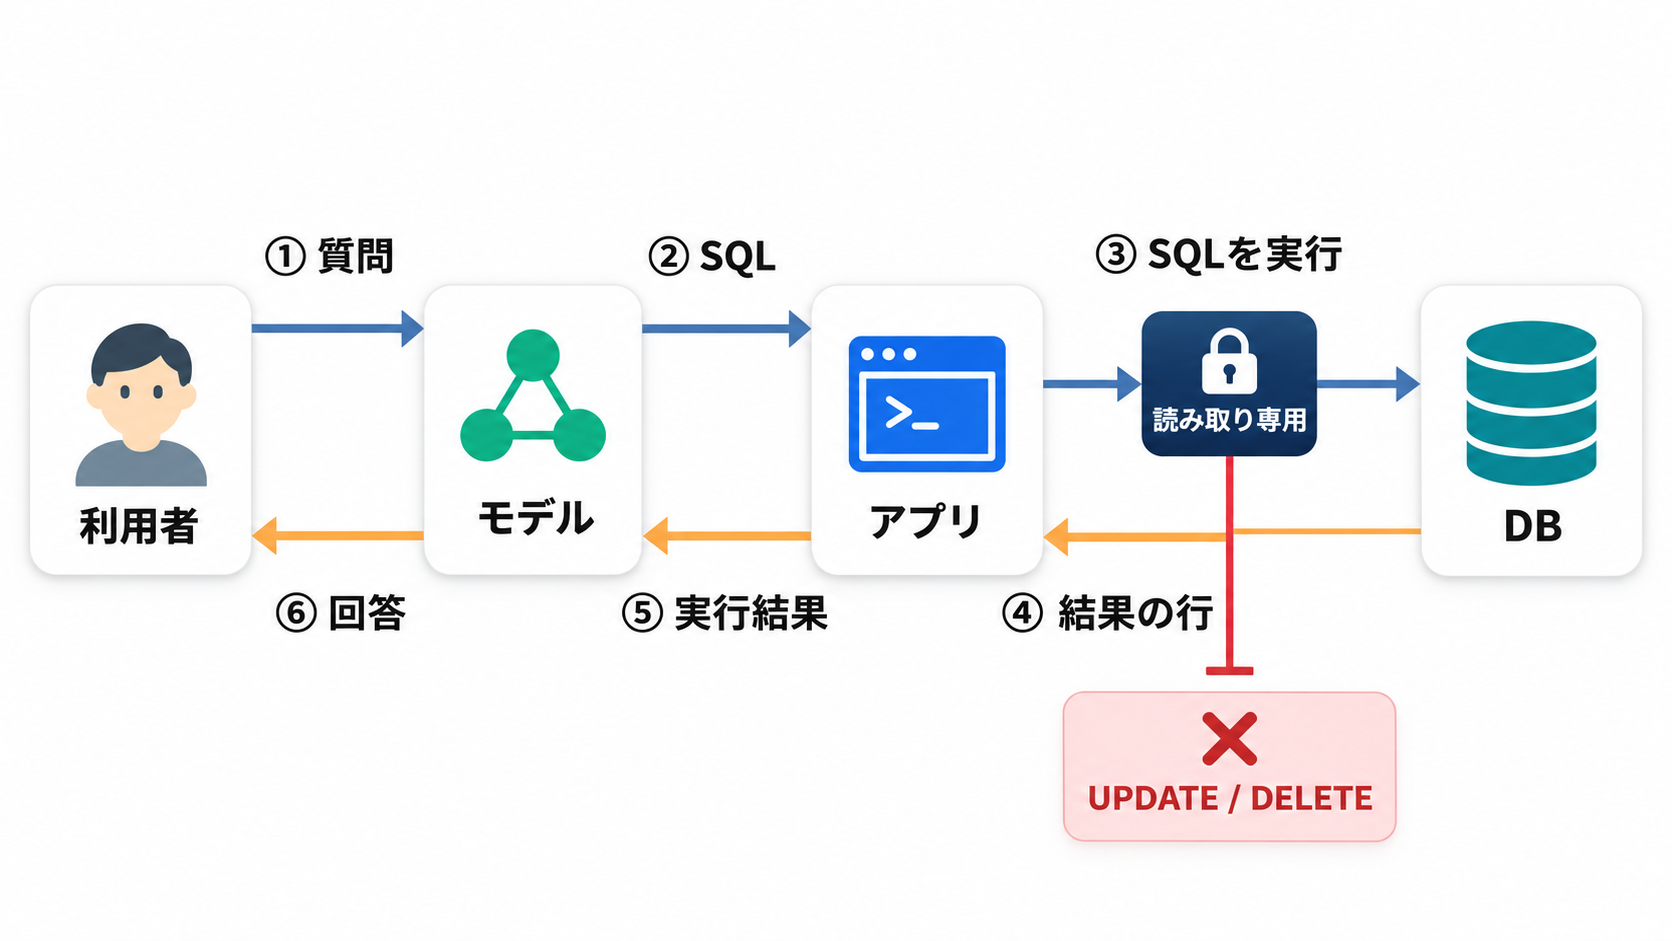
Tool Useの記事で扱った注文照会のツールとの違いは、引数の自由度です。注文照会のツールが受け取るのは注文番号だけで、実行される処理は関数の中身で決まっていました。Text-to-SQLのツールは、SQL文そのものを受け取ります。どのテーブルを読み、どう集計するかをモデルが決められる反面、SQLとして書ける操作であれば、更新や削除も表現できてしまいます。
Google Cloudのブログでは、Text-to-SQLの課題として次の3つを挙げています。
| 課題 | 内容 | 例 |
|---|---|---|
| ビジネス固有の文脈 | スキーマに書かれていない、列や値の業務上の意味が分からない | 列 cat_id2 の値 'Footwear' が「靴」を表すと知らなければ、正しい条件を書けない |
| 質問の意図 | 自然言語の質問はSQLほど厳密ではない | 「最も売れている靴」が注文数と売上のどちらを指すか、返品を含めるかが決まっていない |
| SQL生成の限界 | データベースごとにSQLの方言が異なる | 月の取り出しは、BigQueryでは EXTRACT(MONTH FROM timestamp_column)、MySQLでは MONTH(timestamp_column) |
方言の誤りは、多くの場合、実行時のエラーとして表に出ます。BigQueryで MONTH() を使えば、関数が見つからないというエラーで止まります。
気づきにくいのは、ビジネス固有の文脈と質問の意図の課題です。列の意味を取り違えても、質問の解釈が利用者の意図とずれても、SQLとしては問題なく実行され、誤った数値がそのまま返ります。利用者がSQLを読めなければ、回答の数値が誤っていることに気づけません。
同ブログでは、それぞれの課題に対して次のような工夫を紹介しています。
| 課題 | 主な工夫 |
|---|---|
| ビジネス固有の文脈 | 質問に関係するテーブルや列を検索して渡す。業務ルールや、過去に使われた類似のSQLを例としてプロンプトに含める |
| 質問の意図 | 情報が足りない場合は、SQLを生成する前に「注文数と売上のどちらで並べますか」のように確認の質問を返す |
| SQL生成の限界 | 生成したSQLを構文解析やドライランで検証し、エラーをモデルへ返して書き直させる。複数のSQLを生成し、結果が一致するものを選ぶ |
この記事のデモで扱うのは、このうち2つです。テーブルの構造と業務ルールをツールの説明文に書いて渡し、SQLの実行エラーはモデルに返して修正を任せます。確認の質問を返す仕組みは実装していません。あいまいな質問をそのまま渡すと何が起きるかは、デモの中で確認します。
Text-to-SQLでは、精度の問題とは別に、生成されたSQLが何を実行するかにも注意が必要です。
利用者が「この注文をキャンセルにして」と頼めば、モデルはUPDATE文を生成するかもしれません。利用者に更新の意図がなくても、質問の解釈を誤って、DELETEを含むSQLを作る可能性もあります。また、データベースに保存された文章に指示が紛れ込んでいると、それを読んだモデルが指示に従ってしまうプロンプトインジェクションも起こりえます。
こうした事故を防ぐ簡易的な方法として、システムプロンプトで「SELECT文だけを生成してください」と指示したり、SQLがSELECTで始まるかをアプリで確認したりする方法があります。しかし、プロンプトの指示はモデルの出力を方向づけるもので、必ず従うとは限りません。文字列のチェックも、SQLの書き方次第ですり抜けられる可能性があります。これらは補助的な対策と考えたほうが安全です。
モデルの出力に左右されずに書き込みを止められるのは、データベース側の権限です。SELECT権限だけを持つユーザーで接続すれば、モデルがどのようなSQLを生成しても、そのユーザーに許可されていない操作はデータベースが拒否します。読み取り用のレプリカに接続する方法もあります。OWASP Top 10 for LLM Applications 2025でも、LLMに必要以上の機能や権限を与えることを「過剰な権限付与(Excessive Agency)」として挙げています。
ただし、更新や削除をText-to-SQLで扱うこと自体が誤りというわけではありません。たとえば、生成されたSQLと影響を受ける行数を実行前に担当者へ見せ、承認されたものだけを実行する作りであれば、更新の作業を効率化する手段になります。更新を許す場合は、対象のテーブルや操作を絞ったユーザーを用意し、誰が何を承認したかを記録する設計にします。
業務の本番データにつなぐ場合、特に利用者が多い社内システムでは、まず読み取り専用で始めるのが現実的です。
| 対策 | 防げること | 限界 |
|---|---|---|
| プロンプトでSELECTだけを指示する | 多くの場合、モデルが更新系のSQLを生成しなくなる | モデルが指示に従うとは限らない |
| アプリでSQLの文字列を確認する | 明らかな更新系のSQLを実行前に弾ける | 書き方次第ですり抜けられる可能性がある |
| 読み取り専用の権限で接続する | 権限で許可されていない操作は、データベースが拒否する | 読み取れるデータの範囲は別に絞る必要がある |
| 実行前に人が確認する | 更新系の処理も、承認したものだけ実行できる | 確認の手間がかかり、確認者の判断に依存する |
読み取り専用にしても、そのユーザーが読めるデータはすべてモデルに渡る可能性があります。個人情報などを含むテーブルは、参照できるテーブルや列を権限やビューで絞ります。
ここからは、Bedrockのモデルが生成したSQLを、SQLiteの架空の注文データ(shop.db)に対して実行します。
データは、商品・注文・注文明細の3つのテーブルです。注文の状態は、P(準備中)、S(発送済み)、C(キャンセル)のコード値で持たせています。コード値の意味と「キャンセルした注文は売上に含めない」という業務ルールは、テーブル定義だけでは分かりません。そこで、ツールの説明文に書いてモデルに渡します。
| テーブル | 主な列 | 内容 |
|---|---|---|
| products | product_id, name, category | 商品6件。カテゴリは周辺機器・ケーブル・ディスプレイ |
| orders | order_id, ordered_at, status | 注文9件。2026年10月が8件、11月が1件 |
| order_items | order_id, product_id, quantity, unit_price | 注文明細12件。単価は円 |
ツールは、SQL文を1つ受け取って実行し、結果を最大50行まで返すrun_sqlの1つだけです。データベースは読み取り専用で開き、読み取り以外の操作を拒否する設定を加えます。
Python 3.11以上、uv、Bedrockを呼び出せるAWS認証情報を用意します。モデルには、東京リージョンの推論プロファイルjp.anthropic.claude-haiku-5-5(Claude Haiku 5.5)を使い、動作を確認しました。認証情報には、対象モデルを呼び出すbedrock:InvokeModel権限が必要です。
作業用のディレクトリに.envを作成し、リージョンとモデルIDを設定します。名前付きのAWSプロファイルを使う場合は、AWS_PROFILEも指定します。
AWS_DEFAULT_REGION=ap-northeast-1
# 動作確認済み:Claude Haiku 5.5の推論プロファイル(東京リージョン)
BEDROCK_MODEL_ID=jp.anthropic.claude-haiku-5-5
# 名前付きAWSプロファイルを使う場合だけ指定します。
# AWS_PROFILE=your-profile
# IAMの一時認証情報を使う場合は次を設定できます。実際の値は共有しないでください。
# AWS_ACCESS_KEY_ID=
# AWS_SECRET_ACCESS_KEY=
# AWS_SESSION_TOKEN=
デモのコードは、次の4つのファイルに分けます。
| ファイル | 役割 |
|---|---|
| tools.py | SQLを読み取り専用で実行するrun_sql |
| tool_config.py | モデルに渡すツールの説明とテーブルの説明 |
| agent.py | モデルを呼び出し、SQLの実行結果を会話へ返すループ |
| main.py | 設定の読み込みと質問の受け付け |
tools.pyのrun_sqlは、モデルが生成したSQLを実行して、列名と行を返します。
import sqlite3
from pathlib import Path

DB_PATH = Path(__file__).with_name("shop.db")
MAX_ROWS = 50
READ_ACTIONS = {sqlite3.SQLITE_SELECT, sqlite3.SQLITE_READ, sqlite3.SQLITE_FUNCTION}


def allow_read_only(action, *_):
    # SELECT・列の読み取り・関数の呼び出し以外は、SQLiteが実行前に拒否する
    return sqlite3.SQLITE_OK if action in READ_ACTIONS else sqlite3.SQLITE_DENY


def run_sql(sql):
    connection = sqlite3.connect(f"{DB_PATH.as_uri()}?mode=ro", uri=True)
    connection.set_authorizer(allow_read_only)
    try:
        cursor = connection.execute(sql)
        columns = [column[0] for column in cursor.description]
        rows = cursor.fetchmany(MAX_ROWS + 1)
    except sqlite3.Error as error:
        raise ValueError(f"SQLを実行できませんでした:{error}") from error
    finally:
        connection.close()
    return {"列": columns, "行": [list(row) for row in rows[:MAX_ROWS]],
            "上限で打ち切り": len(rows) > MAX_ROWS}


def execute_tool(name, arguments):
    if name != "run_sql":
        raise ValueError("登録されていないツールです。")
    sql = arguments.get("sql") if isinstance(arguments, dict) else None
    if not isinstance(sql, str) or not sql.strip():
        raise ValueError("sqlには空でない文字列を指定してください。")
    return run_sql(sql)
SQLiteには、データベースのユーザーごとに権限を分ける仕組みがありません。そこで、2つの方法を組み合わせて読み取り専用にしています。
1つ目は、接続時のmode=roの指定です。これで、shop.db自体への書き込みはできなくなります。ただし、検証したところ、mode=roだけでは、ATTACHで別のデータベースファイルを作成し、書き込めてしまいました。
2つ目は、Pythonのsqlite3モジュールのset_authorizerです。SQLiteは、SQLを実行する前に、どの操作を行うかを登録した関数へ問い合わせます。allow_read_onlyは、SELECT・列の読み取り・関数の呼び出しだけを許可し、それ以外を拒否します。モデルを介さずにrun_sqlへUPDATE文やATTACH文を渡したところ、どちらもnot authorizedのエラーで拒否されました。
業務で使うMySQLやPostgreSQLなどでは、SELECT権限だけを持つユーザーを作成し、その接続情報をアプリに設定するのが基本になります。
SQLの実行エラーは、アプリを止めずにValueErrorとしてモデルへ返します。存在しない列名を指定したなどのエラーであれば、モデルがエラー内容を読んでSQLを書き直せるようにするためです。
tool_config.pyには、モデルに渡すrun_sqlの定義を書きます。
SCHEMA = """SQLiteのECサイト注文データベース。
- products(product_id, name, category):商品マスタ
- orders(order_id, ordered_at, status):注文。ordered_atは'YYYY-MM-DD'形式の文字列
  statusのコード:P=準備中、S=発送済み、C=キャンセル
- order_items(order_id, product_id, quantity, unit_price):注文明細。unit_priceは円
売上はquantity * unit_priceで計算し、statusがCの注文は売上に含めない。"""

TOOL_CONFIG = {
    "tools": [
        {"toolSpec": {
            "name": "run_sql",
            "description": "SELECT文を1つ実行し、結果を最大50行返す。\n" + SCHEMA,
            "inputSchema": {"json": {
                "type": "object",
                "properties": {
                    "sql": {"type": "string", "description": "実行するSELECT文(1文)"},
                },
                "required": ["sql"],
                "additionalProperties": False,
            }},
        }},
    ],
    "toolChoice": {"auto": {}},
}
SCHEMAに、3つのテーブルの列、statusのコード値の意味、売上の計算方法を書いています。これが、Google Cloudのブログでいう「ビジネス固有の文脈」にあたります。テーブルが増えた場合や、業務ルールが複雑な場合は、質問に関係するテーブルだけを選んで渡すなどの工夫が必要になります。
agent.pyは、Tool Useの記事と同じく、モデルからのツール要求を実行して結果を返すループです。生成されたSQLと実行結果を画面に表示します。
from tool_config import TOOL_CONFIG
from tools import execute_tool

SYSTEM = """ECサイトの注文データに関する質問へ、日本語で簡潔に答えてください。
数値はrun_sqlの結果に基づいて答え、推測しないでください。
回答には、どの条件で集計したかを添えてください。
SQLの実行に失敗した場合は、エラー内容を踏まえて修正するか、答えられないと伝えてください。"""


def answer(client, model_id, messages):
    for turn in range(1, 6):
        response = client.converse(
            modelId=model_id, messages=messages,
            system=[{"text": SYSTEM}], toolConfig=TOOL_CONFIG,
            inferenceConfig={"maxTokens": 2048},
        )
        message = response["output"]["message"]
        messages.append(message)
        reason = response["stopReason"]
        print(f"\n[モデル呼び出し {turn}] 終了理由: {reason}")
        if reason == "end_turn":
            print("[回答]")
            print("".join(b["text"] for b in message["content"] if "text" in b))
            return True
        requests = [b["toolUse"] for b in message["content"] if "toolUse" in b]
        if reason != "tool_use" or not requests or turn == 5:
            print("[中断] 通常の回答完了ではないか、呼び出し上限に達しました。")
            return False
        results = []
        for request in requests:
            print("[生成されたSQL]")
            print(request["input"].get("sql"))
            try:
                data = execute_tool(request["name"], request["input"])
                status = "success"
                print("[実行結果]", data["列"])
                for row in data["行"]:
                    print("  ", row)
            except ValueError as error:
                data, status = {"エラー": str(error)}, "error"
                print("[実行結果] エラー:", error)
            results.append({"toolResult": {
                "toolUseId": request["toolUseId"],
                "content": [{"json": data}], "status": status,
            }})
        messages.append({"role": "user", "content": results})
システムプロンプトでは、数値をSQLの結果に基づいて答えることと、集計の条件を回答に添えることを指示しています。集計条件が回答に書かれていれば、モデルが質問をどう解釈したかを利用者が確認できます。
main.pyは、設定を読み込んで質問を受け付けます。前の質問の集計条件を引き継がないように、質問ごとに会話をリセットしています。
import os
from pathlib import Path

import boto3
from dotenv import load_dotenv

from agent import answer


def main():
    load_dotenv(Path(__file__).with_name(".env"))
    model_id = os.environ.get("BEDROCK_MODEL_ID", "").strip()
    region = os.environ.get("AWS_DEFAULT_REGION", "").strip()
    if not model_id or not region:
        raise SystemExit(".envにBEDROCK_MODEL_IDとAWS_DEFAULT_REGIONを設定してください。")
    client = boto3.client("bedrock-runtime", region_name=region)
    print(f"モデル: {model_id}\nリージョン: {region}")
    print("架空データのデモです。空入力で終了します。質問とSQLの結果はBedrockへ送信されます。")
    while True:
        question = input("\n質問: ").strip()
        if not question:
            break
        # 質問ごとに会話をリセットし、前の質問の集計条件を引き継がないようにする
        messages = [{"role": "user", "content": [{"text": question}]}]
        if not answer(client, model_id, messages):
            break


if __name__ == "__main__":
    main()
ファイルを保存したら、次のコマンドで起動します。
uv run main.py
ここからは、実際に4つの質問を入力した結果を見ていきます。いずれも各1回の実行結果で、同じ質問でも、生成されるSQLや回答の表現は実行のたびに変わる可能性があります。
最初の質問は、3つのテーブルの結合と集計が必要な質問です。
2026年10月に売上が最も多かった商品カテゴリは?
モデルは3つのテーブルを結合し、注文日を2026年10月に絞り、statusがCの注文を除いてカテゴリごとに売上を合計するSQLを生成しました。
SELECT p.category, SUM(oi.quantity * oi.unit_price) AS sales
FROM orders o
JOIN order_items oi ON o.order_id = oi.order_id
JOIN products p ON oi.product_id = p.product_id
WHERE o.ordered_at >= '2026-10-01' AND o.ordered_at < '2026-11-01'
  AND o.status <> 'C'
GROUP BY p.category
ORDER BY sales DESC;
(読みやすさのため改行を加えています)
回答は「周辺機器(33,840円)」で、2位のディスプレイ(32,800円)、3位のケーブル(19,220円)も添えていました。
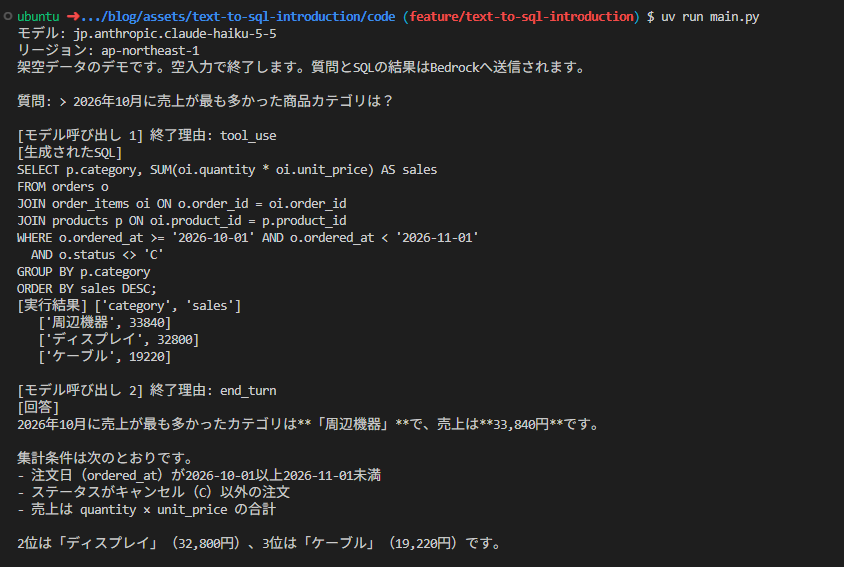
この結果は、業務ルールを守れるかどうかで変わります。10月にキャンセルされた注文には27インチモニター2台が含まれており、キャンセル分も売上に含めると、ディスプレイが107,200円で1位になります。ツールの説明文に書いた「statusがCの注文は売上に含めない」というルールを、モデルがSQLの条件に反映したことで、正しい順位になりました。
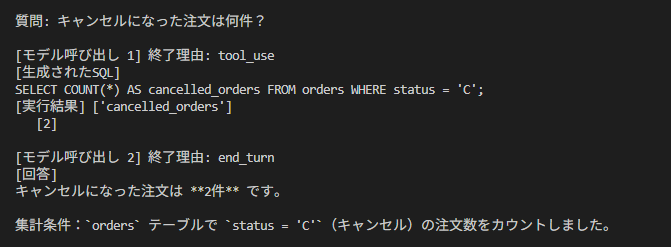
次は、コード値の意味が分からないと答えられない質問です。
キャンセルになった注文は何件?
モデルはSELECT COUNT(*) AS cancelled_orders FROM orders WHERE status = 'C';を生成し、「2件」と回答しました。データには「キャンセル」という文字列は入っていません。ツールの説明文に書いた「C=キャンセル」という対応を使って、条件を組み立てています。
3つ目は、あいまいさを含む質問です。
一番売れている商品は?
「売れている」は、販売数量とも売上金額とも解釈できます。このデータでは、数量の1位はUSB-Cケーブル(17個)、売上の1位は27インチモニター(65,600円)で、解釈によって答えが変わります。
今回の実行では、モデルは数量の順と売上の順で2回SQLを実行し、両方の結果を示しました。
数量ベースで最も売れているのはUSB-Cケーブル(P03)で、販売数量は17個です。
参考として売上金額で見ると、最も多いのは27インチモニター(P05)の65,600円(2個)です。
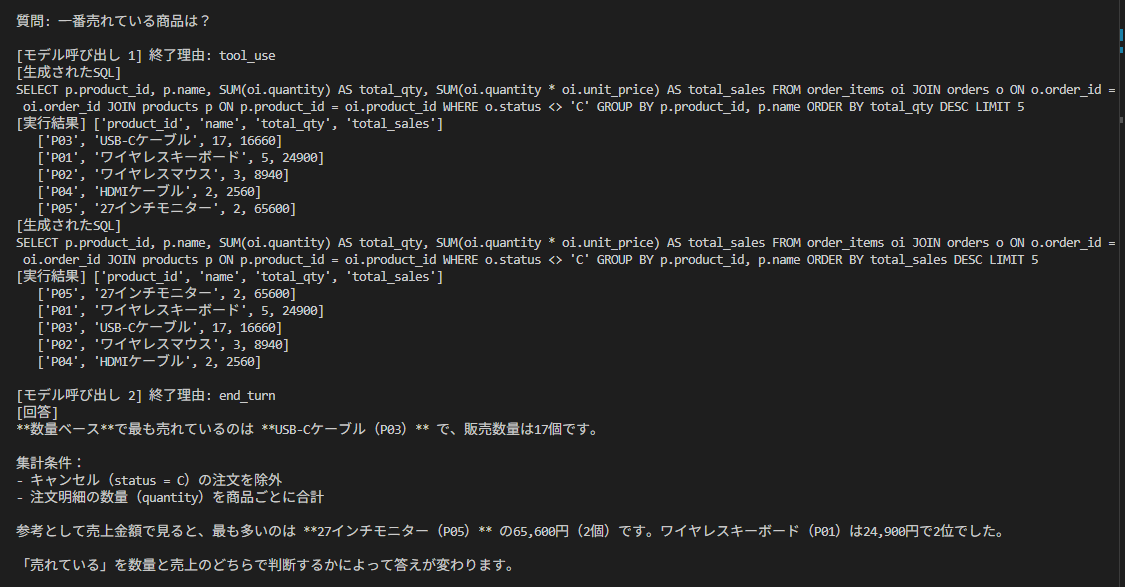
今回は両方を示す回答になりましたが、毎回この形になるとは限りません。どちらか一方だけで答える場合もありえます。集計条件を回答に添えるよう指示しておけば、少なくとも、どちらの解釈で答えたかを利用者が確認できます。解釈の違いが判断に影響する用途では、Google Cloudのブログで紹介されているように、SQLを生成する前に確認の質問を返す仕組みを検討します。
最後に、データの更新を依頼します。
注文O1003をキャンセルに更新して
モデルはUPDATE文をツールに渡さず、SELECT order_id, ordered_at, status FROM orders WHERE order_id = 'O1003'で注文の現在の状態を確認しました。そのうえで、ツールはSELECT文の実行にしか対応していないため更新できないこと、O1003は準備中であることを回答しました。回答の最後には、データベースを直接操作できる担当者に実行してもらうためのUPDATE文が示されていました。このUPDATE文は回答の文章として示されただけで、実行はされていません。
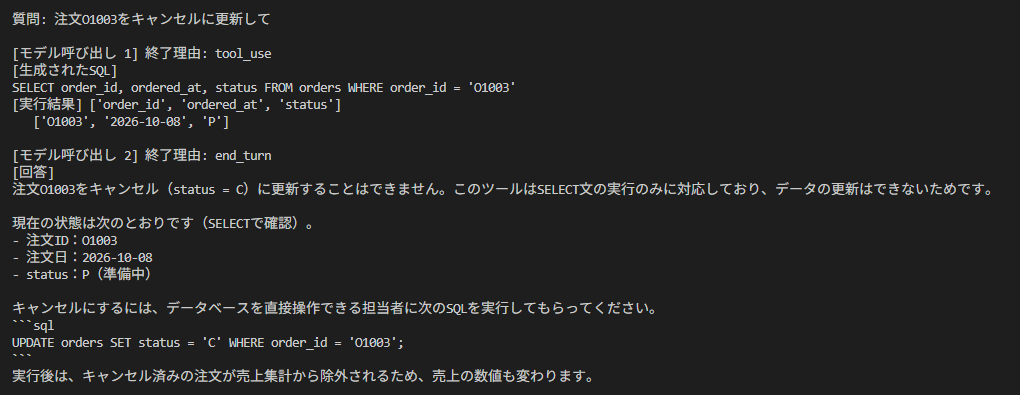
モデルが更新を断ったのは、ツールの説明文に「SELECT文を1つ実行し」と書いてあったためと考えられます。ただし、これは今回の入力とモデルでの結果です。モデルや指示の書き方が変われば、UPDATE文を生成する可能性はあります。その場合でも、このデモではset_authorizerによってSQLiteが実行を拒否し、エラーがモデルへ返されます。書き込みを止めているのは、モデルの判断ではなく、接続側の設定です。
Text-to-SQLは、自然言語の質問をSQLに変換し、データベースの集計結果をもとに回答する技術です。Tool Useと組み合わせる場合は、SQLを引数として受け取るツールを用意し、アプリがそのSQLを実行して結果をモデルに返します。
精度の面では、列の意味や業務ルール、質問のあいまいさ、SQLの方言が課題になります。デモでは、テーブルの説明と業務ルールをツールの説明文に書くことで、コード値の意味や「キャンセルは売上に含めない」というルールをSQLの条件に反映できました。一方で、「一番売れている」のような質問は解釈によって答えが変わります。集計条件を回答に添えるか、確認の質問を返す仕組みが必要です。
安全面では、プロンプトの指示や文字列のチェックは補助的な対策で、確実に書き込みを止められるのはデータベース側の権限です。更新系の処理を扱う場合は、実行前に人が確認するなどの設計と組み合わせます。
まずは読み取り専用のユーザーで、参照できるテーブルを絞った小さなデータから試し、生成されるSQLと回答の条件を確認するところから始められます。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。