生成AI関連
生成AIに機密情報を渡していいの?
生成AIの業務利用が広がるにつれ、次のような質問をよく聞きます。
機密情報全般の整理は、以前の記事で扱いました。
今回はその続編として、SIerなどの現場でSEやPMが案件単位での生成AI利用をどう考えるべきか?をまとめます。
なお、個別案件では顧客契約・社内規程・法務判断を何よりも優先する必要があります。本記事はあくまで考える指針としてご一読ください。また、製品仕様や公的資料は2026年4月17日時点の公開情報を前提にしています。
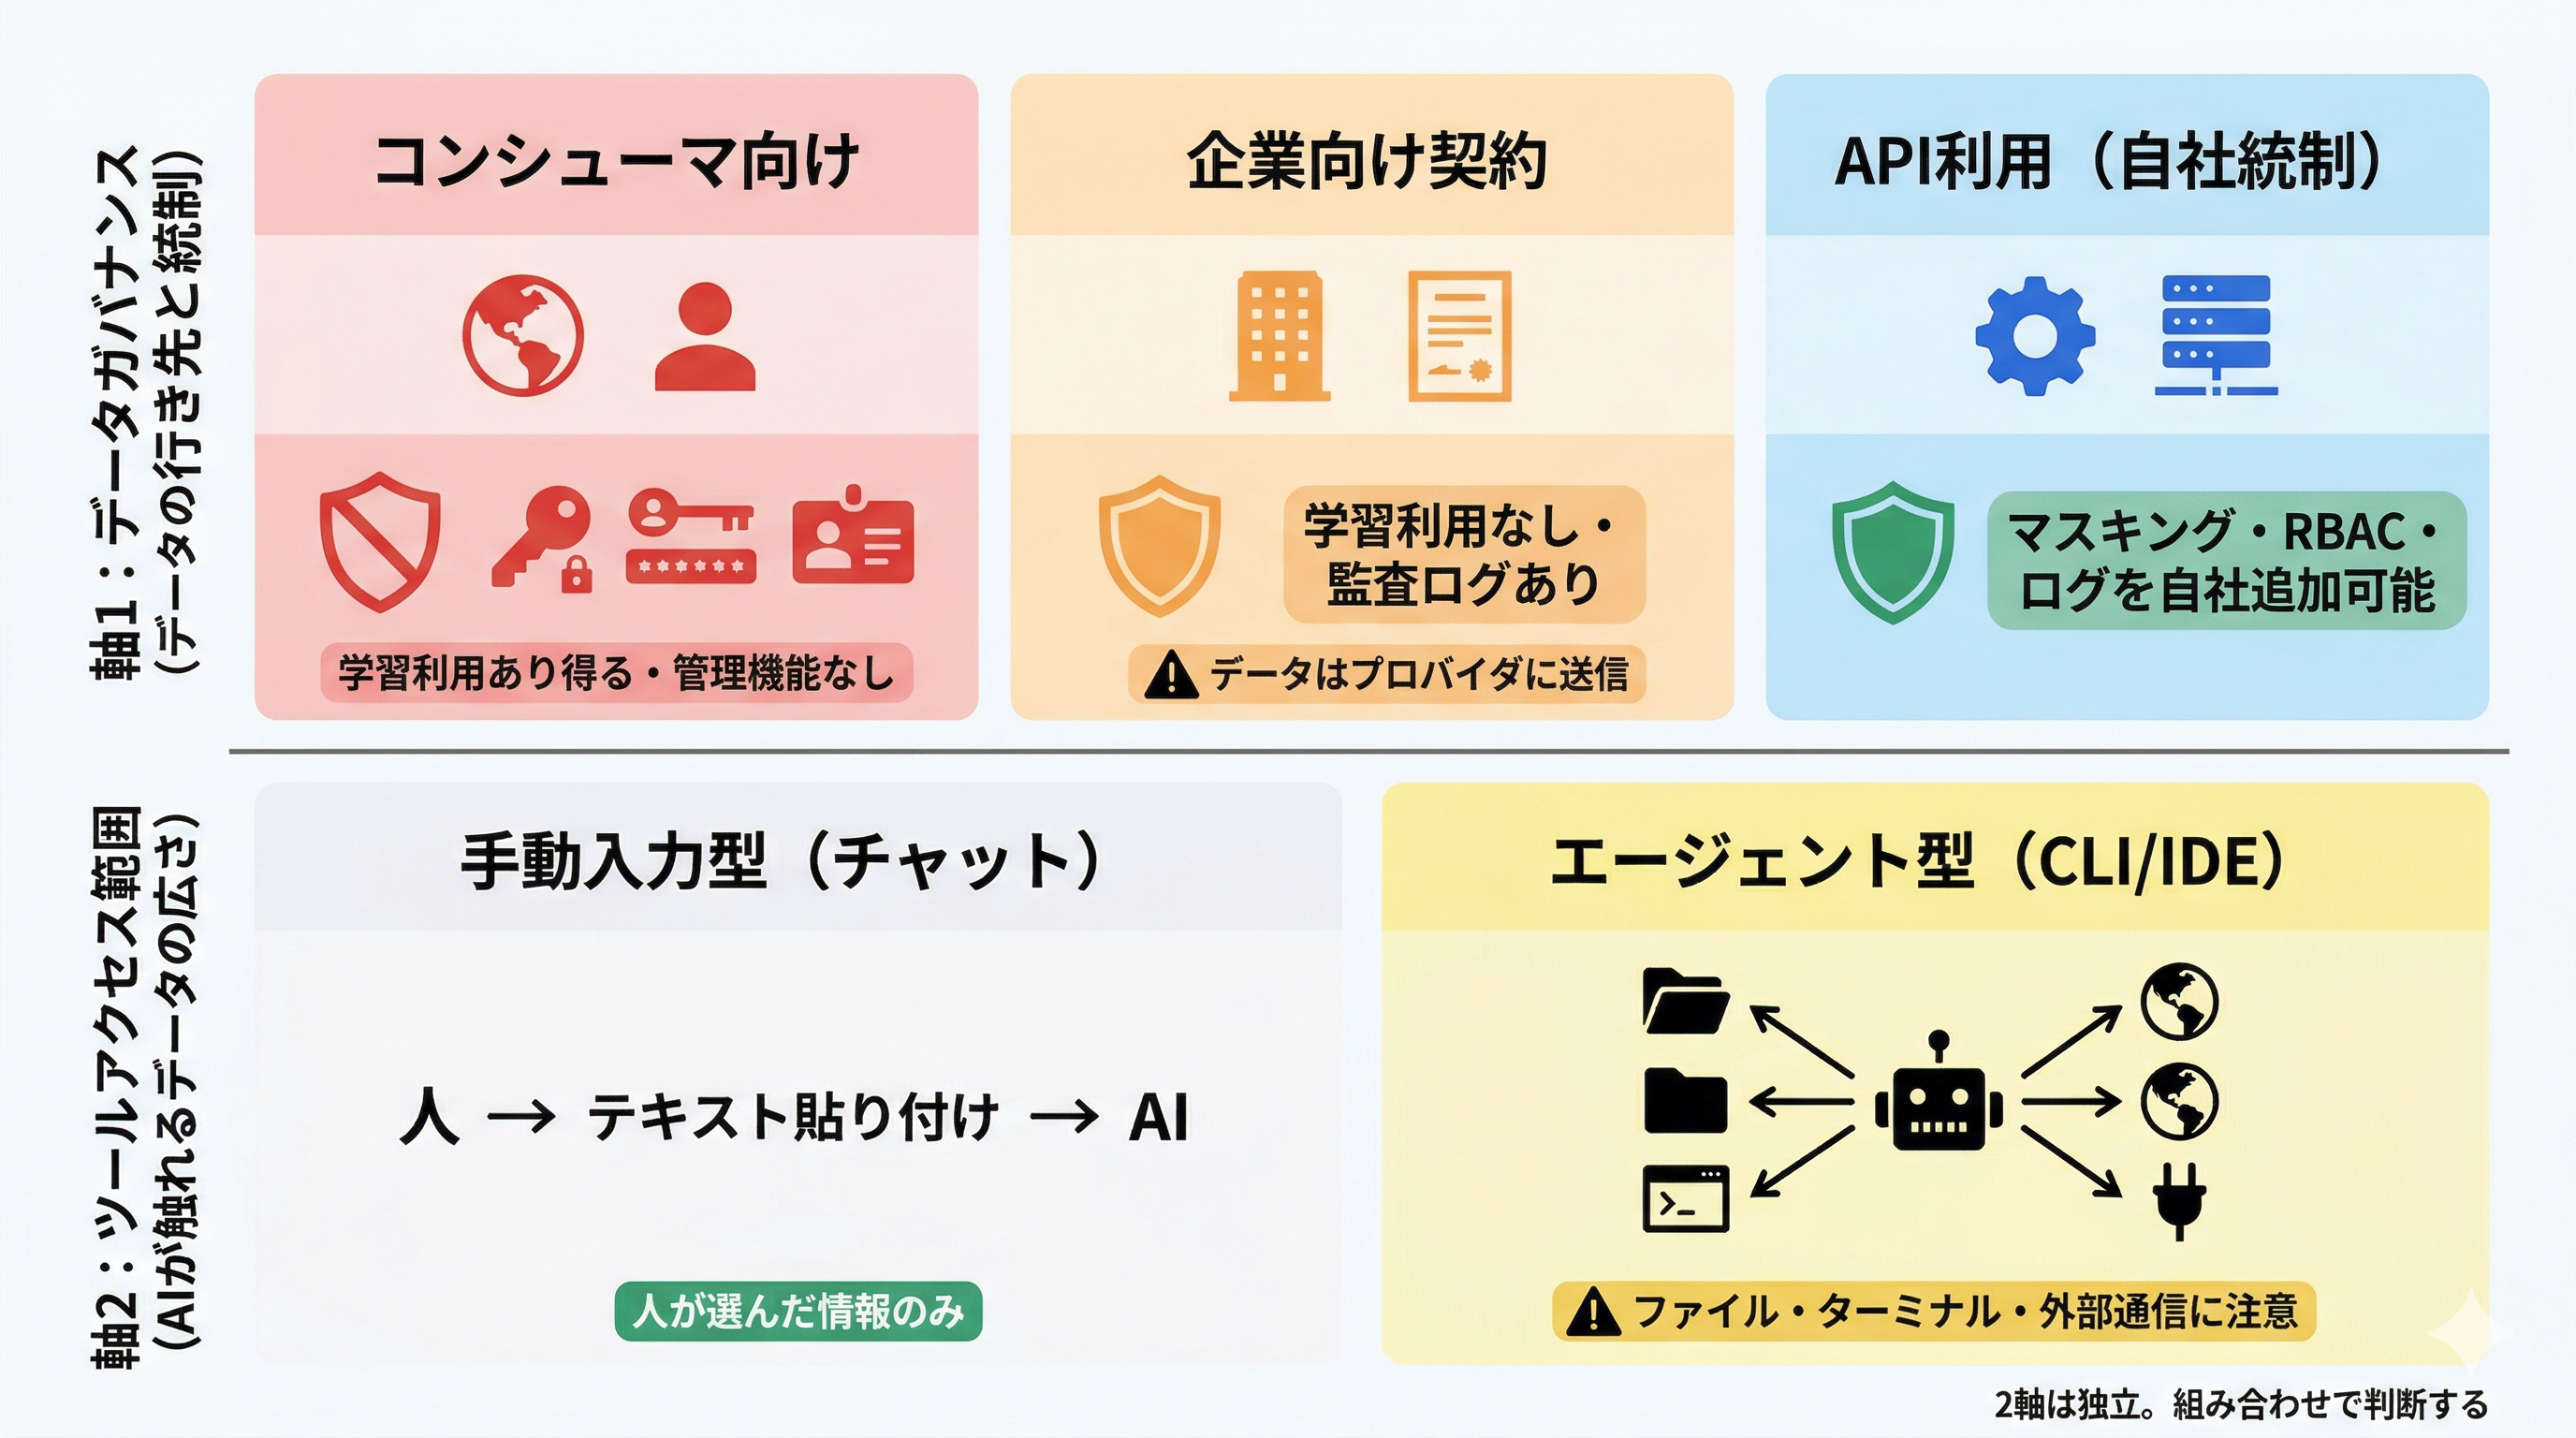
「どこまで業務情報を入れてよいか」を判断するには、2つの軸を分けて考えるのが実務上理解しやすくなります。
最初に見るべきなのは、生成AIサービスをどの契約形態で使用しているかです。プランや契約形態によって、データが学習に使われるか、どこに保存されるか、管理権限があるかが変わります。
| 契約・プランの形態 | 入力しやすい情報 | 入力前に必ず確認すること | 原則そのまま入れない情報 |
|---|---|---|---|
| コンシューマ向け(個人/無料プラン) | 公開済み資料、一般論、ダミー化したサンプル | そもそも案件で利用許可があるか | 認証情報、個人データ、本番設定、顧客固有情報 |
| 企業向け(ビジネス/エンタープライズ契約) | 伏字化したコード断片、最小化した社内文書 | 契約、保存、外部連携、管理機能 | 生パスワード、本番値、未マスク個人情報 |
| API利用(自社アプリケーション経由) | マスキング済み入力、用途限定の業務データ | 監査、RBAC、保持期間、第三者送信 | 人が直接貼った秘密情報、統制なしの広範囲データ |
もう一つ見るべきなのは、そのAIツールが何にアクセスできるかです。
この2軸は独立しています。チャット型でもコンシューマプランで使えばデータ管理の責任は軽減されず、エージェント型でも企業向け契約とアクセス設計を組み合わせれば統制が効きます。
経済産業省は2025年2月に AIの利用・開発に関する契約チェックリスト を公表し、2026年3月31日には AI事業者ガイドライン(第1.2版) を更新しています。
ここから見えてくるのは、AI利用は「便利だから何に使用してもOK」ではなく、契約・データ分類・最小化・統制で管理するテーマだということです。
現場では法務論より先に、顧客契約で許されているかを見るべきでしょう。
経産省の契約チェックリストは、AIサービス利用時に少なくとも次の観点を確認するよう促しています。
特にSIerなどシステム開発を委託されている現場において、次のどれかに該当すると、契約違反になり得ます。
つまり、OpenAIやGoogleの企業向け条件が問題なかったとしても、それだけでは足りません。案件で使ってよいかどうかは、顧客契約と社内ルールで決まります。
「個人情報さえ入れなければ大丈夫」と考えるのは危険です。実務では、少なくとも個人情報と営業秘密・秘密情報を分けて見ます。
個人情報保護委員会のQ&Aでは、氏名のみでも個人情報になり得る、住所や電話番号は他の情報と容易照合できれば個人情報になり得る、メールアドレスも内容次第で個人情報になり得ると整理されています。
参考:
さらに、外国クラウド上で個人データを扱う場合は、個人情報保護法上の論点が出ます。もっとも、個人情報保護委員会は、クラウド事業者が保存された個人データを取り扱わないこととなっている場合には、第三者への「提供」に当たらないことがあるとしています。ただし、その場合でも利用者側には安全管理措置や外国制度の把握が求められます。
参考:
一方で、個人情報ではなくても守るべき情報は大量にあります。典型的には、以下が挙げられます。
これらは不正競争防止法上の営業秘密や、契約上の秘密情報に当たり得ます。個人情報でないから大丈夫とはなりません。
では、これらの情報をAIに相談したいときは、具体的にどうすればよいのでしょうか。
生成AIに相談したい内容の多くは、実際には生データを必要としません。AIに必要なのは、次のどれかであることが大半です。
そのため、実務では次の4原則で安全性を担保するようにしましょう。
この「対応関係だけ残して実値を捨てる」という考え方は、設定ファイルやネットワーク情報で特に重要です。
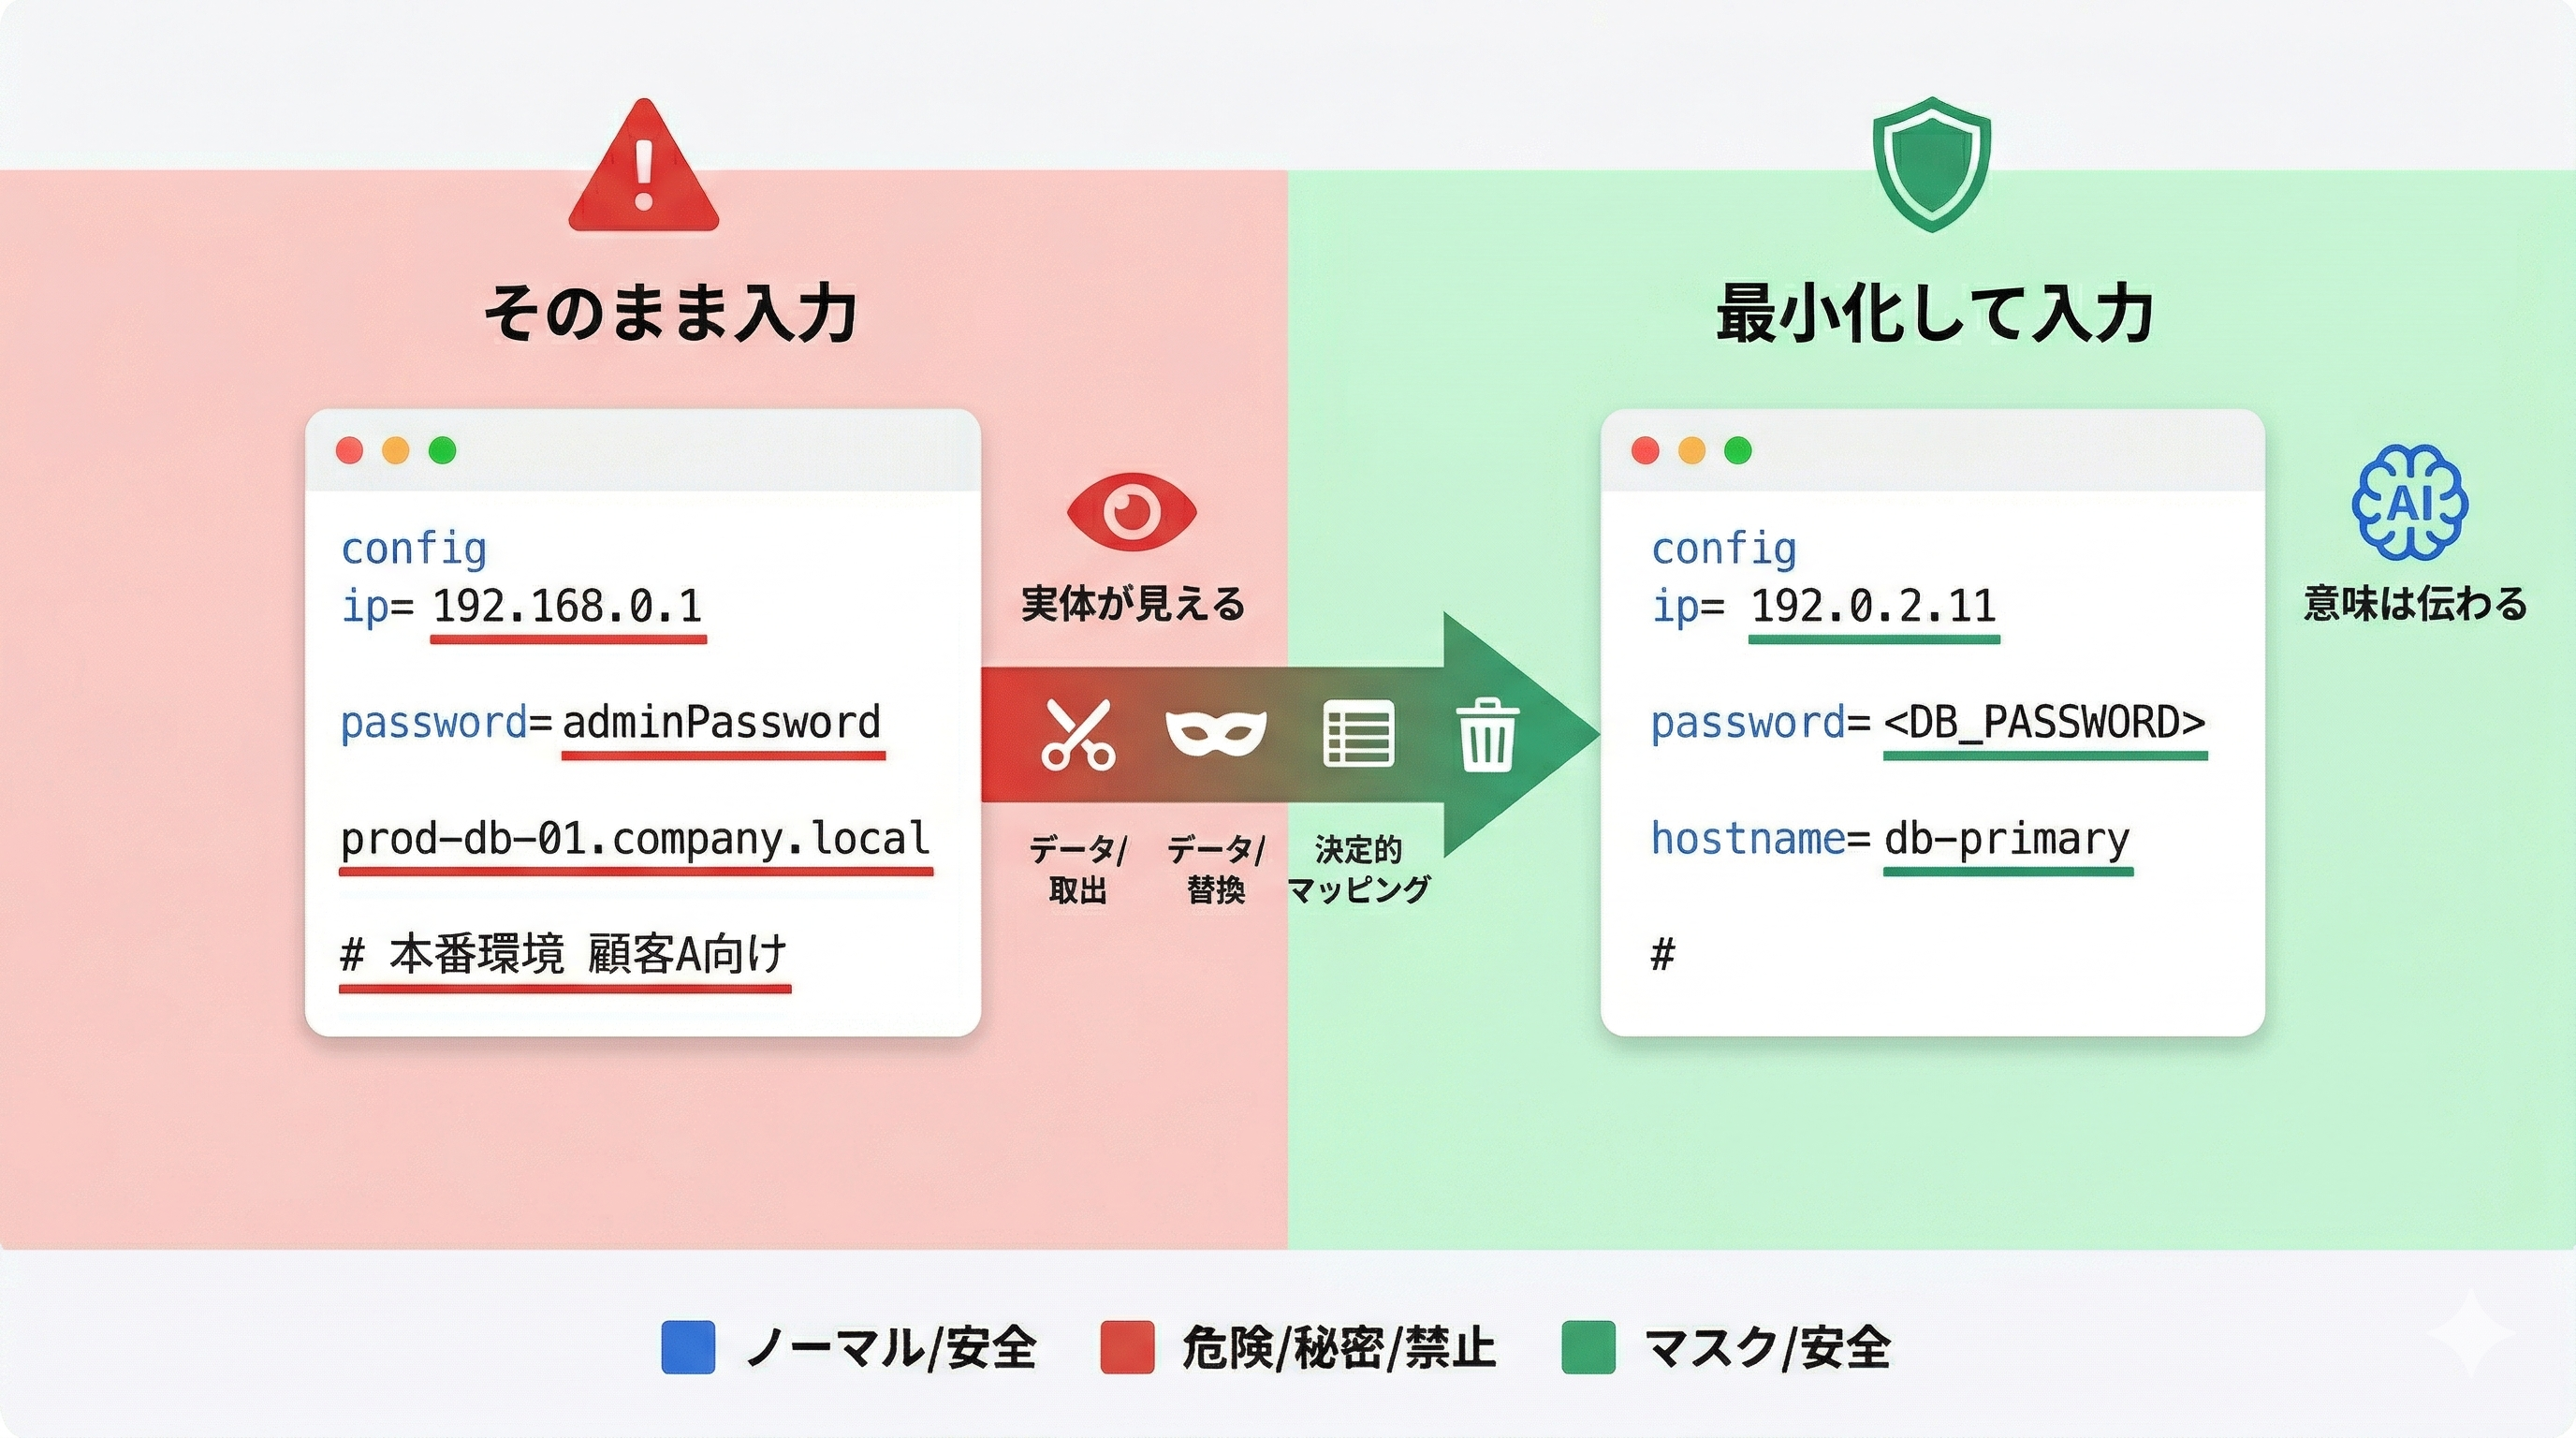
公開型AIにはそのまま貼らないが基本になるでしょう。企業向けAIやAPIでも、秘密値は原則マスクすることを強く推奨します。
次のようなコードは、そのまま入れるべきではありません。
Connection conn = DriverManager.getConnection(
    "jdbc:mysql://192.168.0.1:3306/customer_prod",
    "admin",
    "adminPassword"
);
AIに相談したいのが「接続方式が正しいか」「例外の原因は何か」であれば、必要なのは実IPや実パスワードではありません。次のように意味だけ残せば十分です。
Connection conn = DriverManager.getConnection(
    "jdbc:mysql://<DB_HOST>:3306/<DB_NAME>",
    "<DB_USER>",
    "<DB_PASSWORD>"
);
実務上の判断を整理すると、以下のようになります。
ここで大事なのは、「実値がないとAIが答えられないか」を先に疑うことです。大半のケースでは答えは「不要」です。
ここは少し丁寧に考える必要があります。company、address、vote のような一般名詞だけで、直ちに違法になるわけではありません。ただし、コード全体の文脈が揃うと、業務ドメインや顧客業種、制度対応の内容が推測されることはあります。
たとえば、次のような情報が重なると推知性が上がります。
公開型AIに渡すなら、一般名詞を全部消す必要はありません。むしろ、意味まで消すと相談の価値が落ちます。実務的には次の整理が使いやすいです。
| 残してよいことが多い | 置換した方がよい | 原則落とした方がよい |
|---|---|---|
| company address status などの一般名詞 | クラス名、テーブル名、パッケージ名、制度名 | 顧客名、案件名、社内略号、内部URL、チケット番号 |
また、ファイルを丸ごと投げるより、相談したい関数やロジックだけを切り出す方が安全です。これは情報保護だけでなく、AIの回答精度にも有効です。
これはさらに慎重に扱うべきです。/etc/hosts や本番設定ファイルは、個人情報でなくても内部構成・接続関係・冗長構成・命名規則を表します。そのまま出すと、システムの輪郭がかなり見えてしまいます。
公開型AIには原則そのまま投入しません。企業向けAIであっても、次はマスクしてから渡すことを推奨します。
マスキングするなら、関係性を保ったまま決定的に置換します。IPv4はRFC 5737で予約された 192.0.2.0/24、198.51.100.0/24、203.0.113.0/24、IPv6はRFC 3849の 2001:db8::/32 を例示用に使えます。
参考:
たとえば、主系・副系の対応だけ残したいなら次のようにします。
# 置換後の例
192.0.2.11 app-primary
192.0.2.12 app-secondary
192.0.2.21 db-primary
192.0.2.22 db-secondary
2001:db8::11 app-primary-v6
2001:db8::12 app-secondary-v6
このとき重要なのは、192.168.0.1 -> 192.0.2.11、192.168.0.2 -> 192.0.2.12 のように、ペア関係だけ残して実値を捨てることです。本番構成の「意味」は残せても、「実体」は漏らさない形にできます。
最後に、現場で使いやすいチェックリストを置いておきます。どれか1つでも No なら、そのまま投入しない方が安全です。
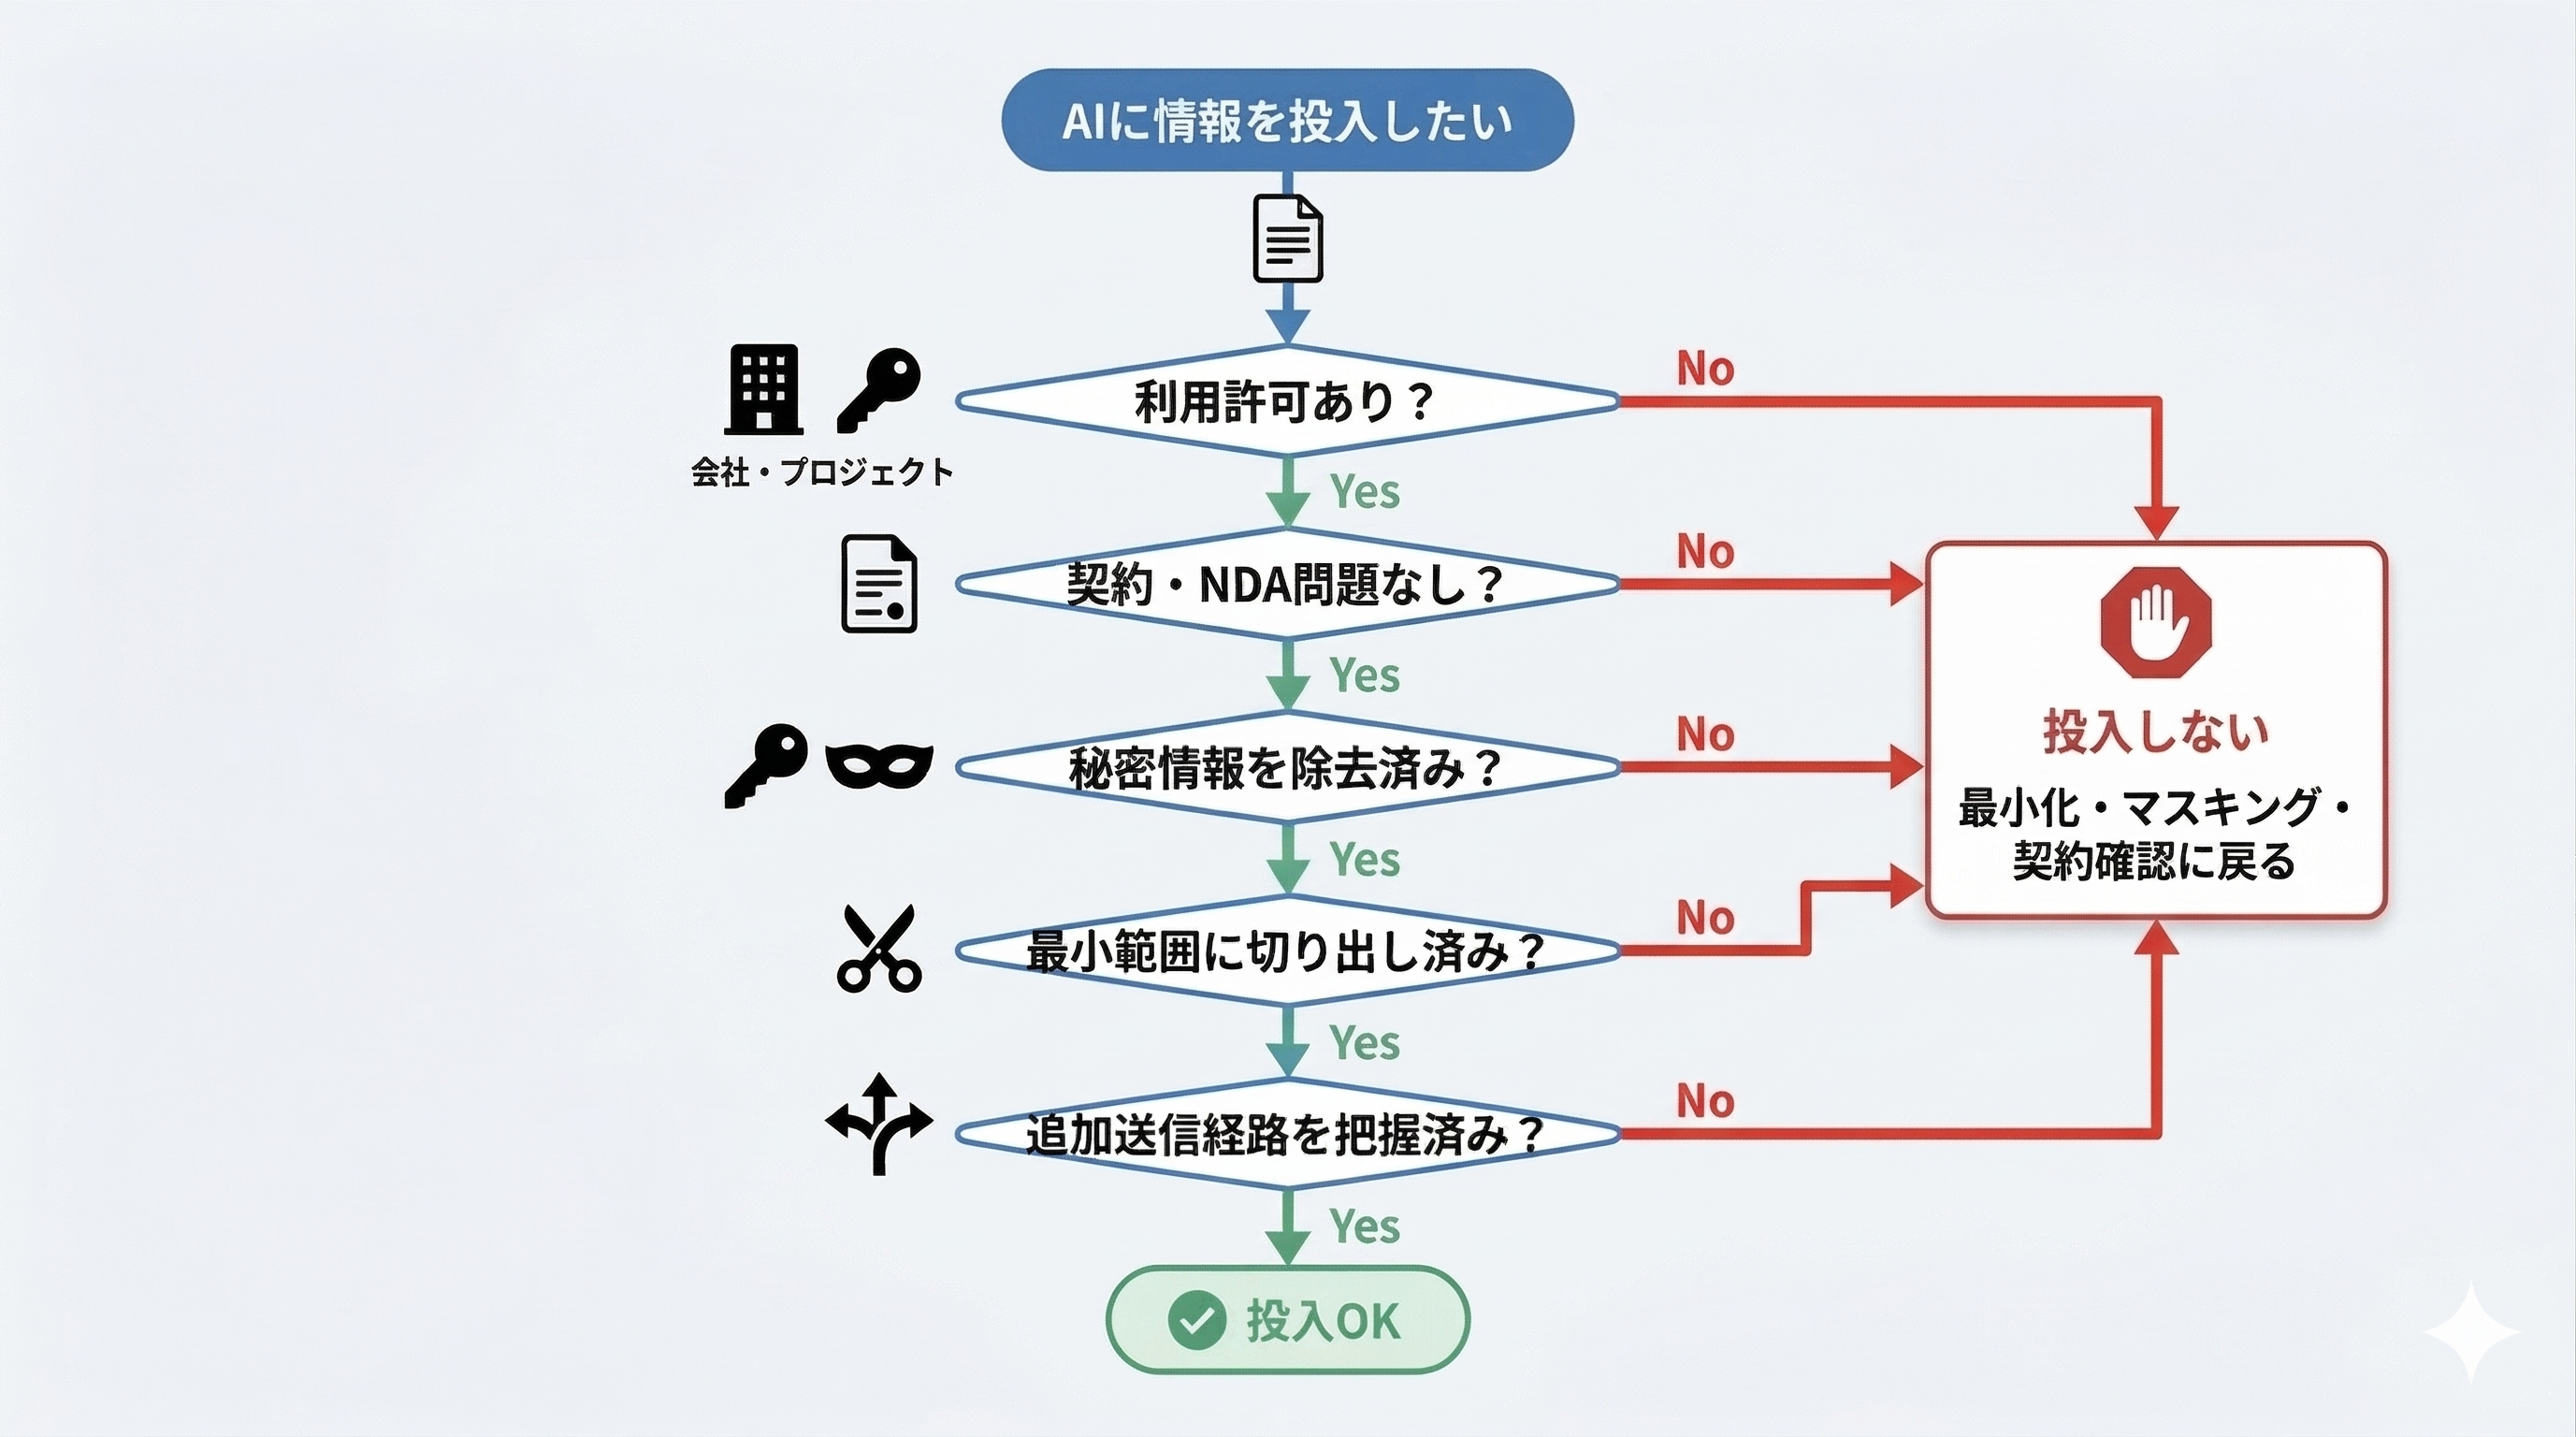
現場で一番避けたいのは、「企業向けだから大丈夫だと思って、そのまま貼ってしまう」ことです。企業向けプランでも、秘密を最小化する責任までは肩代わりしてくれません。
当社のようなSIerの立場で生成AIを使うときに重要なのは、AIを一律にOK/NGで語らないことです。見るべきなのは、どのAIか、どの情報か、どの契約か、どこまで最小化したかです。
判断の基軸は2つです。軸1(データガバナンス)では、コンシューマ向けには公開情報のみ、企業向けでも最小限、API経由なら統制を追加できる。軸2(ツールアクセス範囲)では、チャット型なら人が選んだ情報のみ、エージェント型ならファイル除外・外部通信・端末統制を設計する。この2軸で考えると、利用するツールが変わっても判断を大きく外しにくくなります。
特に、DB接続文字列、ソースコード断片、/etc/hosts、本番設定ファイルのような「動く材料」は、AIにとっても人間にとっても情報量が大きいので、丸投げしないのが基本です。
迷ったら、まずは契約確認 -> データ分類 -> 最小化 -> 入力環境の確認の順で見てください。そこまでやって初めて、生成AIを「安全に便利な道具」として使えるようになります。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。