生成AI関連
Structured Outputsの基本と実践
2025年12月のAWS re:Inventで、Amazon Bedrockの新しい推論基盤「Mantle(マントル)」が発表されました。Mantleは大規模なモデルサービングのために設計された分散推論エンジンで、bedrock-mantle という新しいサービスエンドポイントを通じて利用します。
このエンドポイントの最大の特徴は、OpenAIのResponses API・Chat Completions API、そしてAnthropicのMessages APIという、業界で広く使われているAPI仕様にそのまま対応している点です。つまり、OpenAI SDKやAnthropic SDKで書かれた既存のアプリケーションを、ベースURLとAPIキーを差し替えるだけでBedrock上のモデルに接続できます。
一方で、従来の bedrock-runtime エンドポイント(InvokeModelやConverse API)とは、認証方式もリクエストの形式も大きく異なります。単なる新機能の追加ではなく、Bedrockの呼び出し方そのものにもう一つの体系が加わった、と捉えるのが実態に近い変化です。
本記事では「従来のBedrockと何が違うのか分からない」という方に向けて、Bedrock Mantleの概要、従来のBedrock Runtimeとの違い、実際のAPI呼び出し方法などの特徴を整理します。
Mantleは、Amazon Bedrockの推論を支える分散推論エンジンの名称です。利用者から見ると、bedrock-mantle.{region}.api.aws という専用エンドポイントとして提供され、以下の3つのAPIをサポートします。
| API | 互換仕様 | 主な用途 |
|---|---|---|
| Responses API | OpenAI互換 | ステートフルな会話管理、エージェント型アプリケーション(推奨) |
| Chat Completions API | OpenAI互換 | ステートレスなチャット。既存資産の移行が容易 |
| Messages API | Anthropic互換 | Claudeモデルへのネイティブアクセス |
AWSの公式ドキュメントでは、Mantleの利点として次の点が挙げられています。
Key benefits include:
- Asynchronous inference – Support for long-running inference workloads through the Responses API
- Stateful conversation management – Automatically rebuild context without manually passing conversation history with each request
- Simplified tool use – Streamlined integration for agentic workflows
- Flexible response modes – Support for both streaming and non-streaming responses
- Easy migration – Compatible with existing OpenAI SDK codebases
要約すると、非同期推論、ステートフルな会話管理、ツール利用の簡素化、ストリーミング対応、そして既存のOpenAI SDKコードベースからの容易な移行が主な利点です。
対応リージョンは米国東部(バージニア北部・オハイオ)、米国西部(オレゴン)、欧州(フランクフルト、アイルランドほか)、アジアパシフィック(東京、シドニー、ムンバイほか)などに広がっており、東京リージョン(ap-northeast-1)でも利用可能です。最新の対応リージョンは公式ドキュメントのSupported Regions and Endpointsで確認できます。
また、Bedrockコンソールからはモデルカタログの比較機能や、後述するAPIキー管理・Projects機能にアクセスできるようになっており、Mantleを前提とした検証をコンソール上でも進めやすくなっています。
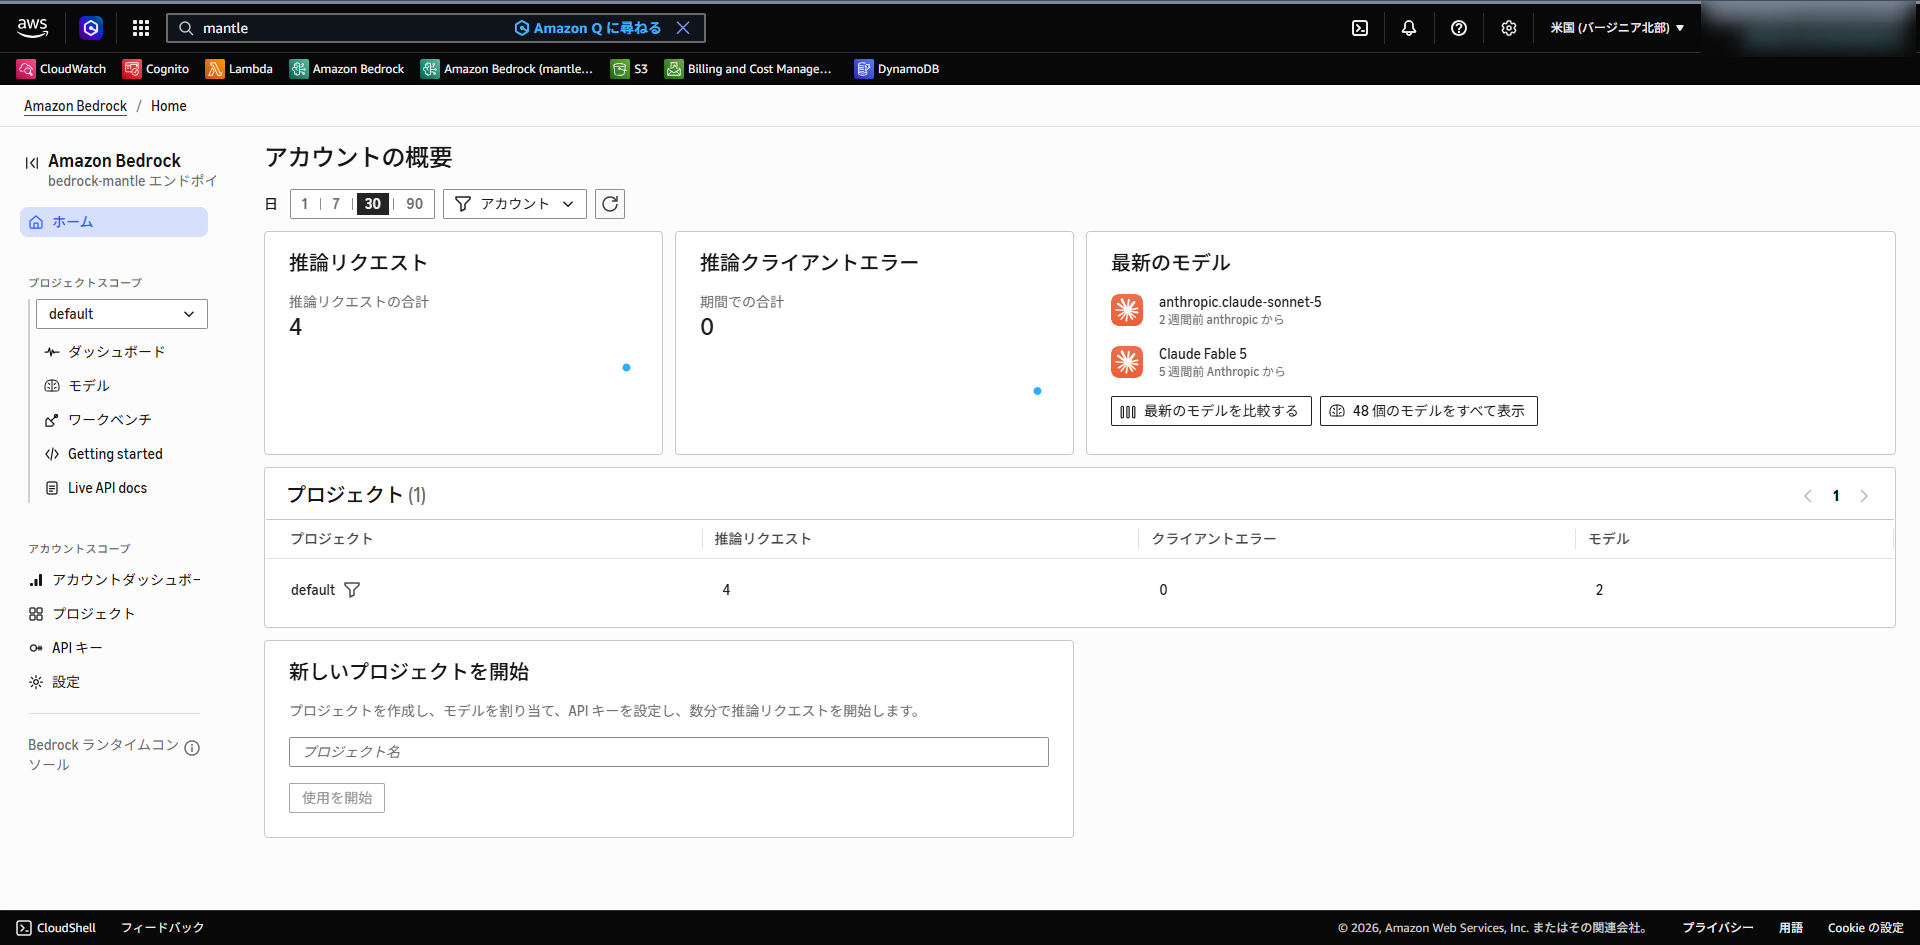
従来、Bedrockでモデルを呼び出す際は bedrock-runtime エンドポイントに対して、AWS SDK(boto3など)からInvokeModelまたはConverse APIを実行するのが標準的な方法でした。Mantleではこの前提が大きく変わります。主な違いを表にまとめます。
| 項目 | bedrock-runtime(従来) | bedrock-mantle(新) |
|---|---|---|
| エンドポイント | bedrock-runtime.{region}.amazonaws.com | bedrock-mantle.{region}.api.aws |
| 主なAPI | Invoke / Converse / Messages / Chat Completions | Responses / Chat Completions / Messages |
| 認証方式 | AWS SigV4(AWS SDK経由) | Bedrock APIキー(Bearerトークン)またはSigV4 |
| 利用するSDK | AWS SDK(boto3等) | OpenAI SDK / Anthropic SDKをそのまま利用可能 |
| 会話状態の管理 | クライアント側で履歴を毎回送信 | Responses APIによるサーバー側の状態管理に対応 |
| クォータ | bedrock-runtime用のクォータ | 別体系の独立したクォータ |
特に実装面で影響が大きいのは次の3点です。
Mantleを利用する上でまず押さえるべきなのが、Bedrock APIキーによる認証です。APIキーには2種類あります。
| 種類 | 有効期限 | 実体 | 推奨用途 |
|---|---|---|---|
| 短期APIキー | 最大12時間(セッション有効期間に連動) | IAMプリンシパルの権限を継承したトークン | 本番システム・簡単なテスト・短期間のみ使用するスクリプト |
| 長期APIキー | 設定した有効期限まで | 専用IAMユーザーに紐づくクレデンシャル | 検証・学習用途のみ |
短期APIキーは、コンソールの「API keys」メニューから生成できるほか、公式のトークンジェネレーターライブラリ(aws-bedrock-token-generator)を使ってプログラムから生成することも可能です。生成方法の詳細は公式ドキュメントのAPI keysのページにまとまっています。
from aws_bedrock_token_generator import provide_token
from dotenv import load_dotenv

load_dotenv()

token = provide_token()
print(f"Token: {token}")
生成にはAWS認証情報が必要です。リージョンは .env に記述した AWS_REGION を python-dotenv 経由で読み込んでいます。
短期キーは最大12時間で失効するため、固定値としてアプリケーションに設定する使い方はできません。長時間稼働するアプリケーションでAPIキー認証を利用する場合は、トークンジェネレーターによるキー生成の自動化を検討します。provide_token() は有効なトークンが残っていればキャッシュを返し、期限切れであれば自動的に再生成するため、リクエスト前に毎回呼び出す実装が公式ドキュメントで推奨されています。
また、IAMポリシー側では bedrock:CallWithBearerToken アクションでAPIキー利用を制御できます。条件キー bedrock:bearerTokenType を使えば「短期キーのみ許可する」といった統制も可能で、企業利用における最小権限の原則を維持できます。具体的なポリシー例は公式ドキュメントのControl who can generate and use API keysを参照してください。
ここからは、実際のコードでMantleの呼び出し方法を確認します。比較のため、従来のbedrock-runtimeでの呼び出しも並べて示します。
本記事のサンプルコードでは、接続情報を .env ファイルに記述し、python-dotenvで読み込む方式を採用します。リージョンごとのMantleエンドポイントとBedrock APIキーを次のように設定します。
# Bedrock APIキー(短期キーは最大12時間有効)
BEDROCK_API_KEY=<Bedrock APIキー>

# OpenAI SDK用の設定(APIキーはBEDROCK_API_KEYの値を参照)
OPENAI_API_KEY=${BEDROCK_API_KEY}
OPENAI_BASE_URL=https://bedrock-mantle.us-east-1.api.aws/v1

# APIキー生成等で使用するリージョン
AWS_REGION=us-east-1
注意点として、OPENAI_API_KEY に設定するのはOpenAIのAPIキーではなく、BedrockのAPIキーです。また、ベースURLをOpenAIのもの(https://api.openai.com/v1)のままにすると、Bedrockではなく OpenAIに直接接続されてしまうため、移行時には必ず両方を変更します。
まず、利用可能なモデルの一覧をModels API(GET /v1/models)で取得してみます。モデル数が多いため、itertools.batched(Python 3.12以降)で3列に整形して出力します。
from itertools import batched

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()

client = OpenAI()

ids = [model.id for model in client.models.list()]
width = max(map(len, ids)) + 4

for row in batched(ids, 3):
    print("".join(model_id.ljust(width) for model_id in row))
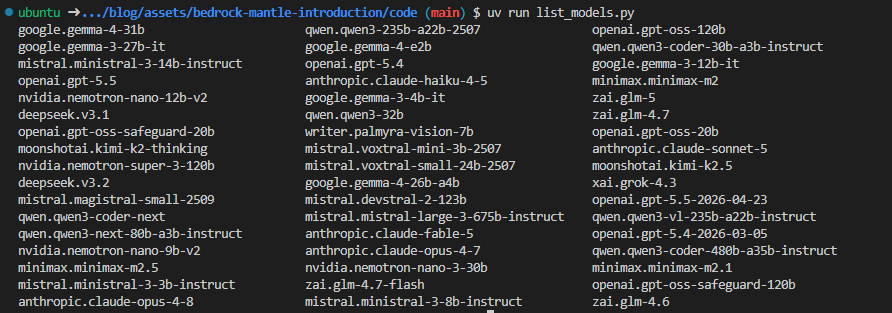
モデルIDは openai.gpt-5.4 や anthropic.claude-sonnet-5 のように「プロバイダー名.モデル名」の形式で指定します。
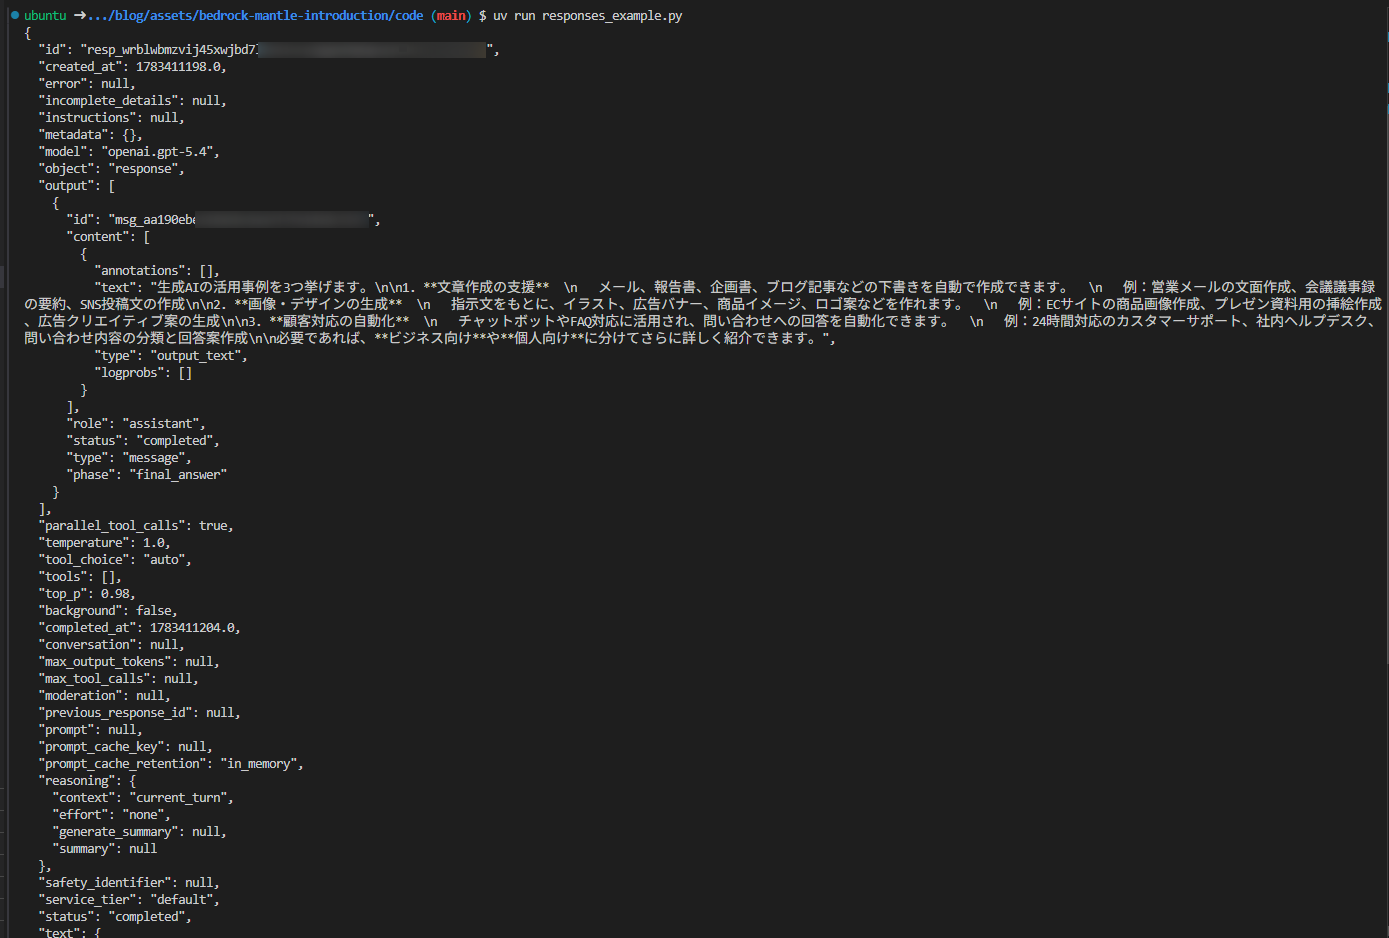
次に、Responses APIでテキスト生成を実行してみます。ここではGPT-5.4を指定します。OpenAIのGPT-5系モデルは、Bedrockではbedrock-mantleエンドポイント経由でのみ利用できるモデルであり、Mantleの導入によって選択肢に加わったモデルの代表例です。
1点注意があります。GPT-5系モデルは、他のモデルが使用する /v1 パスではなく、/openai/v1 という専用パスで提供されています(GPT-5.4のモデルカードに明記されています)。/v1 パスに対してGPT-5.4を指定すると「このモデルは /v1/responses APIに対応していない」という validation エラーが返るため、base_url を明示的に指定します。
# pip install openai python-dotenv
import json
import os

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()

client = OpenAI(
    base_url="https://bedrock-mantle.us-east-1.api.aws/openai/v1",
    api_key=os.environ["BEDROCK_API_KEY"],
)

response = client.responses.create(
    model="openai.gpt-5.4",
    input=[
        {"role": "user", "content": "生成AIの活用事例を3つ教えてください。"}
    ]
)

print(json.dumps(response.model_dump(), ensure_ascii=False, indent=2))
ストリーミングも stream=True を指定するだけで、OpenAI APIと同じイベント形式で受信できます。
※ ただし、これはあくまでリクエスト側の話で、stream=True を指定すると戻り値は単一のレスポンスオブジェクトではなくイベントのストリームに変わります。上記のコードのままレスポンス全体を参照しようとするとエラーになるため、受け取る側もイベントを順次処理する実装に合わせて変更する必要があります。
Claudeモデルに対しては、Anthropicネイティブ形式のMessages APIが利用できます。エンドポイントパスは /anthropic/v1/messages で、Anthropic Python SDKを利用する場合は base_url にMantleエンドポイントの /anthropic までを指定し、api_key にBedrock APIキーを設定します。
import json
import os

from anthropic import Anthropic
from dotenv import load_dotenv

load_dotenv()

client = Anthropic(
    base_url="https://bedrock-mantle.us-east-1.api.aws/anthropic",
    api_key=os.environ["BEDROCK_API_KEY"],
)

message = client.messages.create(
    model="anthropic.claude-sonnet-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "量子コンピューティングを一文で説明してください。"}
    ],
)

print(json.dumps(message.model_dump(), ensure_ascii=False, indent=2))
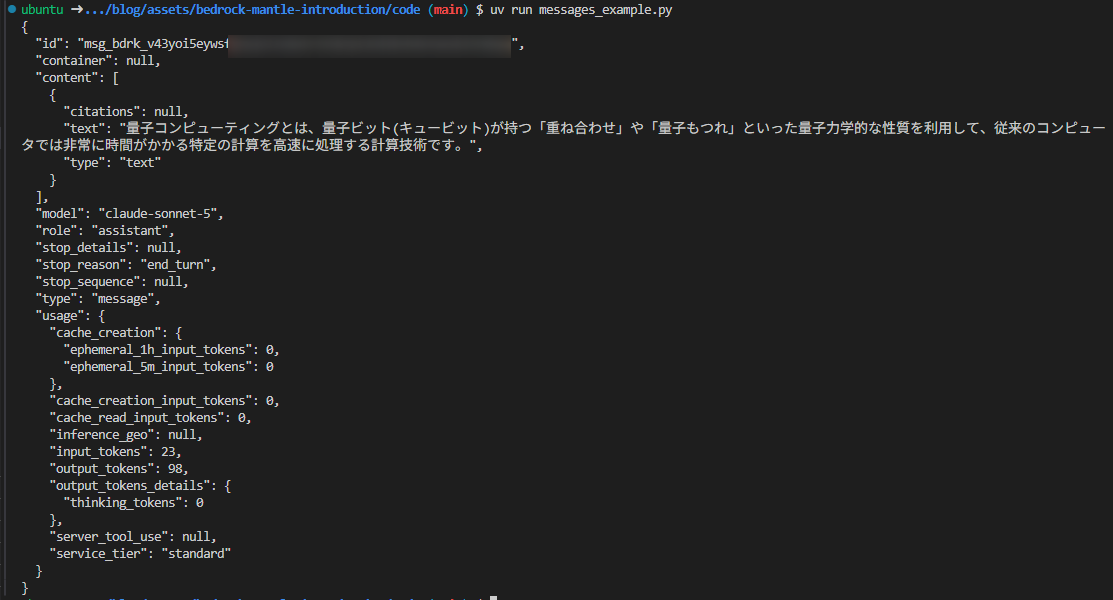
コード自体はAnthropic本家のAPIを呼び出す場合とまったく同じで、接続先とAPIキーを差し替えるだけで動作します。認証用の x-api-key ヘッダーやAPIバージョンを示す anthropic-version: 2023-06-01 ヘッダーはSDKが自動的に付与します。従来のbedrock-runtime経由では、リクエストボディ内に "anthropic_version": "bedrock-2023-05-31" を含める独自方式だったため、ここも移行時の変更点になります。
Messages APIでは、システムプロンプト、マルチターン会話、ツール利用、画像入力(Vision)、プロンプトキャッシュ、Extended ThinkingといったClaudeの主要機能がサポートされています。
ただし、注意点として、ClaudeのStructured Outputs(構造化出力)は本記事執筆時点(2026年7月)ではMantleエンドポイント経由では利用できません。公式ドキュメントでは、Anthropic ClaudeモデルでStructured Outputsを使う場合は bedrock-runtime エンドポイントのConverse APIまたはInvokeModel APIを利用するよう案内されています。このように、機能の利用可否はエンドポイントとモデルの組み合わせごとに異なり、今後変わる可能性もあるため、利用前に公式ドキュメントのStructured Outputsのページで最新の対応状況を確認してください。
Structured Outputsの活用方法は以下の記事で解説しています。
比較のため、同じ処理を従来のbedrock-runtimeエンドポイントで実行するコードを示します。こちらはBedrock APIキーではなく、AWS認証情報(SigV4)による認証です。
# 比較用: 従来のbedrock-runtimeエンドポイントでの呼び出し(AWS認証情報を使用)
import json
import os

import boto3
from dotenv import load_dotenv

load_dotenv()

client = boto3.client("bedrock-runtime", region_name=os.environ["AWS_REGION"])

response = client.invoke_model(
    modelId="us.anthropic.claude-sonnet-5",
    body=json.dumps(
        {
            "anthropic_version": "bedrock-2023-05-31",
            "max_tokens": 1024,
            "messages": [
                {
                    "role": "user",
                    "content": "量子コンピューティングを一文で説明してください。",
                }
            ],
        }
    ),
)

result = json.loads(response["body"].read())
print(result["content"][0]["text"])
boto3クライアントの生成、SigV4による署名、レスポンスボディのパースなど、AWS固有の実装が必要であることが分かります。Mantleでは、これらがOpenAI SDK・Anthropic SDKの標準的な書き方に置き換わります。
Mantleの目玉機能の一つが、Responses APIによるサーバー側での会話状態管理です。従来のChat CompletionsやConverse APIでは、マルチターン会話を実現するためにクライアント側で会話履歴を保持し、毎回のリクエストに全履歴を含めて送信する必要がありました。
Responses APIでは、前回レスポンスの id を次のリクエストの previous_response_id に指定するだけで、サーバー側に保存された文脈を引き継いで会話を継続できます。この仕組みについては、データの取り扱いを正しく理解しておくことが重要です。
デフォルトが「保存する」側に倒れているのは、OpenAIのResponses API仕様に合わせたためです。機密データを扱うシステムでは、store の設定を明示的に管理する運用ルールを定めることを推奨します。
なお、ここで登場する「Projects」は、Mantleと同時期に導入されたOpenAI互換のリソース管理機能です。アプリケーション・環境・チームごとにプロジェクトを分割し、IAMベースのアクセス制御とタグによるコスト可視化を実現できます。保存されたレスポンスもProject単位でスコープされるため、プロジェクトをまたいだ参照はできません。
エンタープライズ利用の観点では、Mantleのセキュリティ設計として「Zero Operator Access」と「データ保持設定」の2つを押さえておくことを推奨します。
Mantleが採用する設計思想が「Zero Operator Access(ZOA)」です。これは、AWSのオペレーター(運用担当者)が顧客データにアクセスするための技術的手段そのものを排除するアプローチで、以下のような仕組みで実現されています。
ZOA設計の詳細は、AWS公式ブログのExploring the zero operator access design of Mantleで解説されています。
生成AIの業務利用では、プロンプトや応答に機密情報が含まれるケースが少なくありません。「クラウド事業者の従業員であってもデータに触れられない」ことがアーキテクチャレベルで担保されている点は、セキュリティ要件の厳しい企業がBedrockを選定する際の材料になります。生成AI利用時のデータの取り扱いについては、以下の記事も参考にしてください。
紛らわしい点として、前のセクションで説明した store パラメータとは別に、コンソールには「データ保持設定(data retention mode)」が存在します。両者は目的が異なります。
| 設定 | 目的 | 制御単位 |
|---|---|---|
| store パラメータ | 会話状態の保存(previous_response_id による会話継続のため) | リクエスト単位 |
| データ保持設定 | 不正利用検出(abuse detection)のためのデータ保持ポリシー | プロジェクト単位 |
Amazon Bedrockは原則としてゼロデータ保持(ZDR)で動作しますが、公式ドキュメントの悪用検出のページに例外が明記されています。たとえばOpenAIのGPT-5.4 / GPT-5.5では、分類器によってフラグされたトラフィックが不正利用の自動検出のために最大30日間保持される仕様になっています。実際に、データ保持設定を「保持なし(none)」に設定してGPT-5.4を呼び出すと、data retention mode 'none' is not available for this model というvalidationエラーが返ります。保持ポリシーはモデルごとに異なるため、機密性の高いデータを扱う場合は、利用予定モデルのデータ保持条件を事前に確認してください。
一方、store パラメータを false にする設定は、Responses APIの会話状態保存を無効化するためのものです。つまり「会話状態を保存しない」設定と「不正利用検出のための保持ポリシー」は別の制御であり、機密性の要件が厳しいシステムでモデルを選定する際は、この違いも確認することを推奨します。
では、既存のbedrock-runtimeからMantleに全面移行すべきかというと、現時点では用途による使い分けが現実的です。AWSのドキュメントを踏まえた使い分けの目安は以下の通りです。
bedrock-mantleが適しているケース
bedrock-runtimeが適しているケース
なお、前述のStructured Outputsのように、機能の利用可否がエンドポイントとモデルの組み合わせによって決まるケースがあります。エンドポイント選定の際は、利用したい機能とモデルの組み合わせが対応しているかを個別に確認してください。
また、すべてのモデルがすべてのAPIに対応しているわけではありません。たとえばResponses APIは対応モデルが限定されています。利用予定のモデルがどのAPI・エンドポイントに対応しているかは、公式ドキュメントのモデル別API互換性で事前に確認してください。
本記事では、Amazon Bedrockの新しい推論基盤であるMantleについて解説しました。要点を振り返ります。
OpenAI互換・Anthropic互換のAPIをAWSの認証・ガバナンスの枠組みの中で利用できるようになったことで、既存の生成AIアプリケーションをBedrockへ移行するハードルは大きく下がりました。まずは検証環境で短期APIキーを発行し、既存コードの接続先を切り替えるところから試すことを推奨します。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。