生成AI関連
Structured Outputsの基本と実践
生成AIをシステムに組み込むとき、回答の精度や処理速度とあわせて考えておきたいのが、異常なトークン消費への備えです。
生成AIが同じような内容を繰り返し、必要以上に長い出力を続けることがあります。この状態を見逃すと、処理が完了しないだけでなく、従量課金のAPI利用料が想定以上に増える可能性があります。
最大出力トークン数が大きい状態で反復が続くと、利用できる回答が得られないまま、出力トークン数、処理時間、API利用料が増加します。さらに、同じ条件で自動再試行する構成では、失敗するたびに入力と出力の料金が重なります。1回あたりの差額が小さくても、処理件数が多いシステムでは月単位のコストに無視できない差が生じます。
本記事では、このような反復出力を「出力ループ」と呼び、コストが増える仕組みと、出力上限、再試行、監視による対策を整理します。
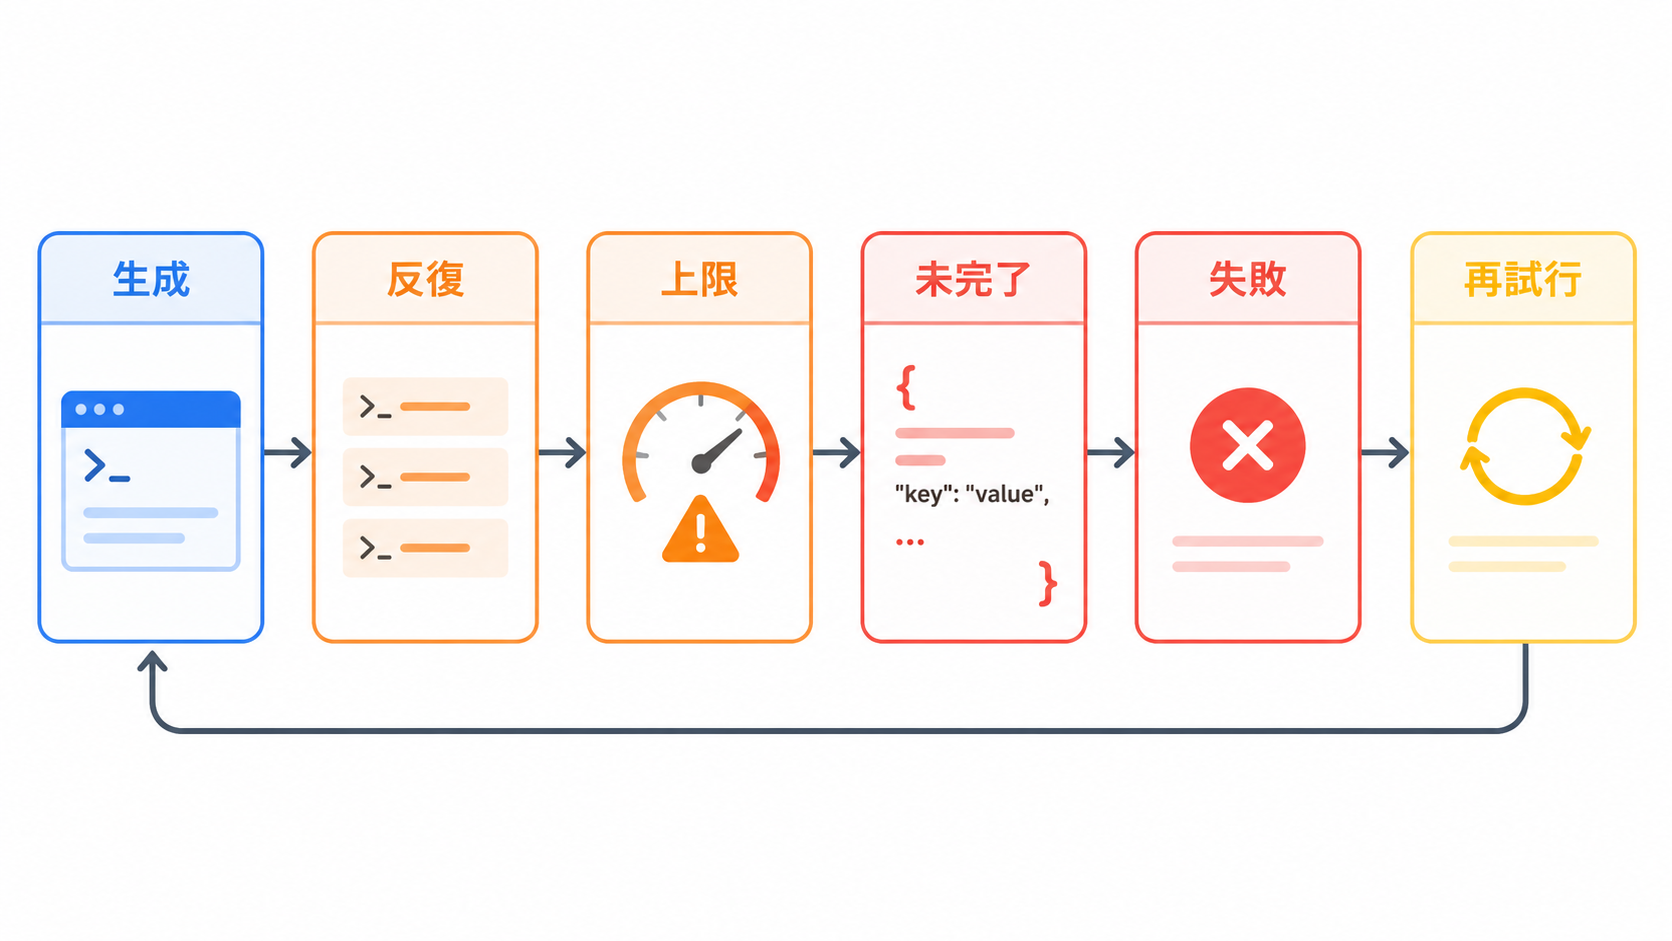
本記事における出力ループとは、モデルが同一または類似する表現を繰り返し、必要な回答を完成させないまま出力上限付近まで生成を続ける状態です。厳密には最大出力トークン数で停止するため無限ではありませんが、上限が大きい場合や再試行が重なる場合には、運用上無視できない問題になります。
生成AIの回答を後続処理で扱う場合、Structured Outputs(構造化出力)が利用できます。Structured Outputsは、あらかじめ定義したスキーマに沿って、JSONなどの決められた形式で回答を生成させる仕組みです。
モデルが生成したJSONをPydanticで検証し、アプリケーション内のデータへ変換すれば、自由記述の回答を扱う場合と比べて出力形式を安定させやすくなります。
Structured Outputsの基本と、Pydanticを使った検証方法については、以下の記事で解説しています。
ここからは、弊社内で使用している生成AIシステムをもとに説明します。このシステムは、ユーザーから受け取った情報をもとに、後続処理で利用するJSONを生成します。主な構成は次のとおりです。
| 項目 | 設定・状況 |
|---|---|
| モデル | Gemini 2.5 Flash-Lite |
| 推論設定 | 推論なし |
| temperature | 約0.8 |
| 出力形式 | Structured Outputsを利用したJSON |
| 後続処理 | Pydanticによるデータ変換・検証 |
通常であれば、モデルがJSONを完成させ、Pydanticによる検証を経て後続処理へ進みます。しかし、同じフィールドの内容を繰り返すと、JSONを閉じる前に出力上限へ到達し、JSONが完成せず、データへ変換できないまま処理が終了します。
Gemini 2.5 Flash-Liteの最大出力トークン数は65,536トークンです(Gemini 2.5 Flash-Lite)。アプリケーション側で現実的な上限を設けていなければ、利用可能なデータを取得できないまま、仕様上限まで出力料金が積み上がる可能性があります。
弊社システムで出力ループが起こった例です。
下記は最大出力トークン数を1,000トークンに設定していたため、1,000トークンの出力で停止しています。現実的な上限を設定しておらず、反復が続いた場合は、モデルの仕様上限まで消費する可能性があります。
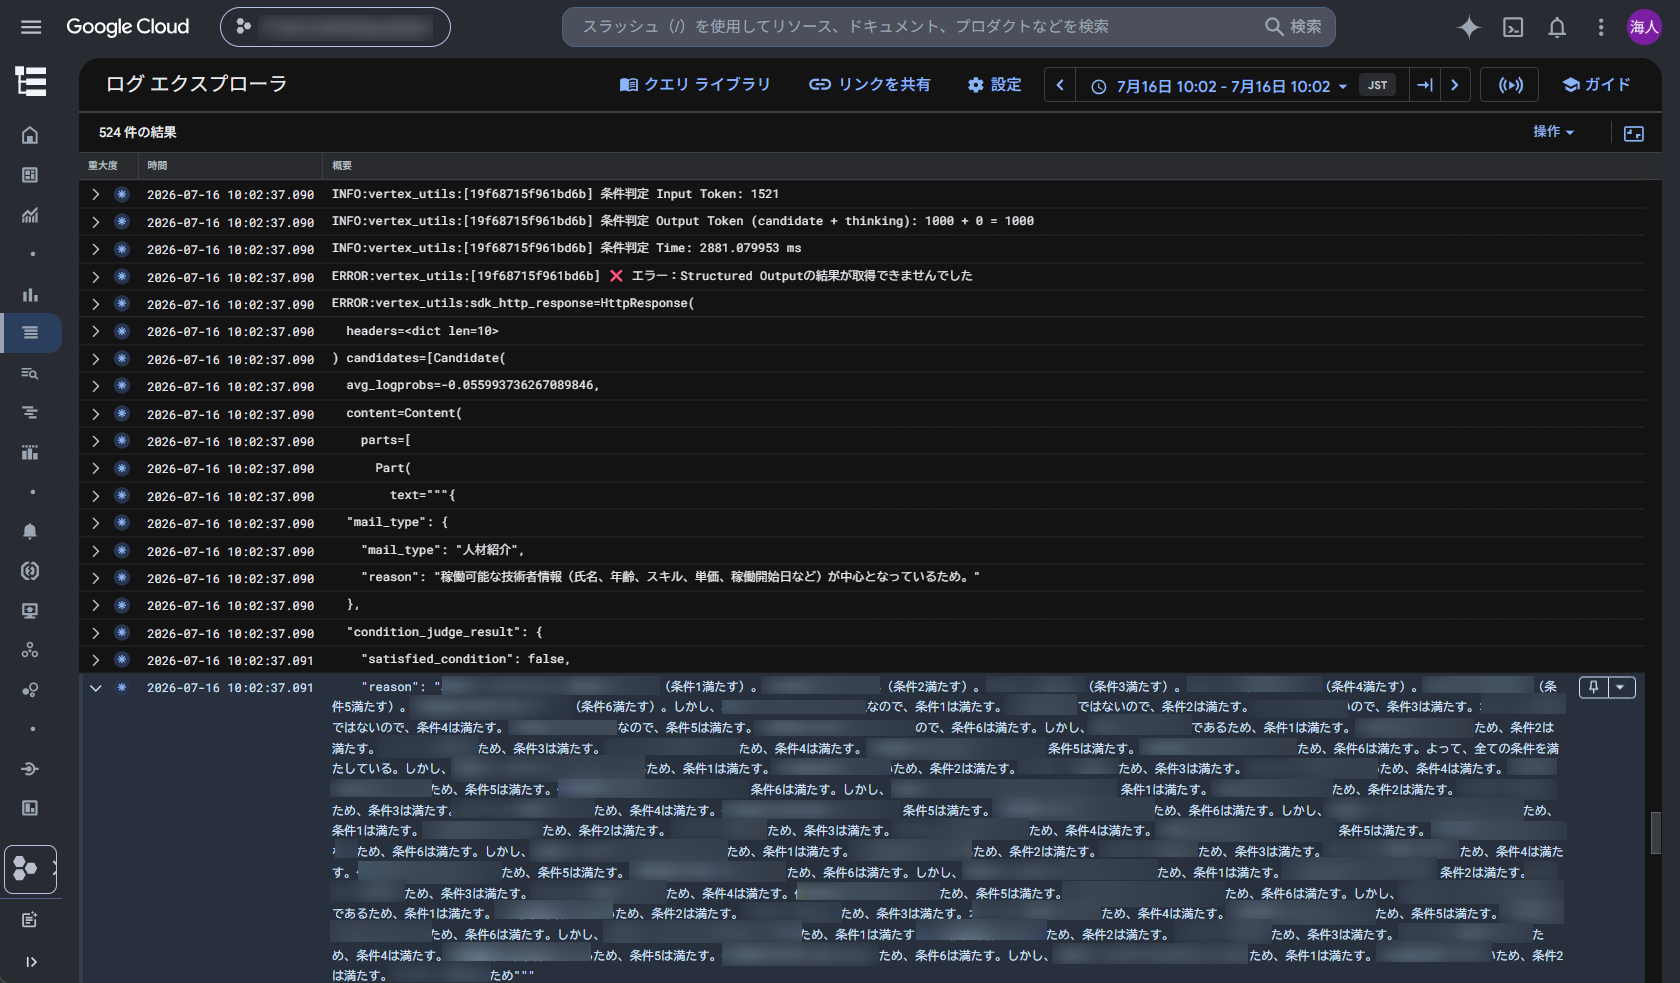
このログからは、次の状況を確認できます。
| ログの項目 | 確認できる内容 |
|---|---|
| condition_judge_result.reason | 同じ判定内容(条件1~条件6を満たすこと)が繰り返されている。出力制限に引っかかり、中途半端な箇所で文が途切れている |
| Input Token | 入力は1,521トークンだった |
| Output Token (candidate + thinking) | 回答の出力が1,000トークン、思考トークンが0トークンで、合計1,000トークンだった |
| エラーメッセージ | 「Structured Outputの結果が取得できませんでした」と記録され、後続処理で利用できる結果を得られなかった |
つまり、出力トークンは上限値まで消費されたうえ、利用可能なデータを取得できないまま処理が終了していました。
まず、計算の前提となるシステムの処理規模と出力トークン数を整理します。
| 項目 | 値 |
|---|---|
| 集計期間 | 2日間 |
| 処理件数 | 6,225件(1日平均約3,100件) |
| 正常時の出力トークン数 | 1件あたり平均約426トークン |
| 反復出力が見られた処理 | 386件、約6.2%(1日平均193件) |
| システム側の最大出力トークン数 | 1リクエストあたり1,000トークン |
このシステムでは、正常時の平均約426トークンに対して、出力の揺れを吸収できるよう最大出力トークン数を1,000トークンに設定していました。そのため、出力ループが起きても生成は1,000トークンで停止します。
この上限を設定せず、モデルの仕様上限である65,536トークンまで反復が続いた場合、正常時の約154倍、1,000トークンで停止する場合の約65倍の出力トークンを消費します。
| 正常時の平均 | 1,000トークンで停止 | 仕様上限まで継続 | |
|---|---|---|---|
| 1回あたりの出力トークン数 | 約426 | 1,000 | 65,536 |
| 1回あたりの出力料金(概算) | 約0.03円 | 約0.06円 | 約4.19円 |
※ 料金は、2026年7月時点のVertex AIにおけるGemini 2.5 Flash-Liteの通常推論の出力単価、100万トークンあたり0.40ドルをもとに概算しています(Vertex AIの料金)。1ドル160円で換算し、入力トークンと再試行の料金は含めていません。
1日平均193件の反復出力がすべて1,000トークンまで続いた場合、正常時との差額は出力料金だけで1日約7円、月20営業日で約140円です。
一方、最大出力トークン数を設定せず、同じ193件が65,536トークンまで続くと、反復出力分の料金は1日約810円です。正常時との差額は1日約804円、月20営業日で約16,100円になります。正常時だけの出力料金は1日約85円ですが、出力ループを含めると約889円となり、約10.5倍です。
自動再試行の回数を制限していなければ、この差はさらに広がります。temperatureが約0.8であっても同様の出力が再び選ばれる可能性はあり、温度を低くすれば出力が安定する、高くすれば(ランダム性を上げれば)ループを回避できるとは限りません。同じ失敗パターンを再現しやすくなる場合もあるため、出力の偶然の変化だけに依存しない設計が必要です。
なお、temperatureを含むテキスト生成パラメータの仕組みについては、以下の記事で詳しく解説しています。
Googleのトラブルシューティングガイドでも、Structured Outputsで改行やテキストが繰り返される事象が挙げられています。Structured Outputsに対しては入力内のエスケープシーケンスやフィールド順などの見直し、反復出力全般に対してはプロンプトやtemperatureの調整が対策として案内されています(Gemini APIのトラブルシューティングガイド)。少なくともGeminiシリーズでは、Flash-Liteだけで発生する問題とはいえません。
Gemini以外の生成AIモデル(OpenAIやClaudeなど)を利用する場合も、出力ループが発生する可能性は十分にあります。生成AIは、それまでに生成した内容をもとに次のトークンを確率的に生成するため、同じパターンに入り込むと反復が続く可能性があります。
生成AIを利用する場合、モデルが異なることや、より高性能なモデルであることだけを理由に反復出力への対策を省かず、出力上限や再試行回数を設計することが重要です。ただし、モデルごとに発生頻度や表れ方は異なる可能性があり、各社のモデルで同じ頻度で発生するという意味ではありません。
生成AI APIの料金は、一般に入力トークンと出力トークンの使用量に応じて決まります。正常な回答が得られなかった場合でも、モデルが生成した出力トークンは消費され、料金が発生します。
対策がない場合は、次の順序で処理エラーとコストが連鎖する可能性があります。
1回の生成にかかる概算コストは、次のように考えられます。
1回の生成コスト = 入力トークン数 × 入力単価 + 出力トークン数 × 出力単価
さらに自動再試行がある場合は、このコストが試行回数分だけ積み上がります。入力とプロンプトが固定されていても、各試行で入力トークンと出力トークンがあらためて消費されます。
1処理の合計コスト = 1回の生成コスト × 試行回数
このように、最大出力トークン数をモデルの仕様上限に近い状態で運用すると、1件の異常がコストへ与える影響も大きくなります。そのため、設計段階で上限と再試行制御を組み込むことが重要です。
最初に確認したい対策が、最大出力トークン数の設定です。
モデルが対応する最大出力トークン数は、そのシステムで実際に必要な出力量を意味するものではありません。Gemini 2.5 Flash-Liteが最大65,536トークンを出力できるとしても、数項目のJSONを返す処理に同じ上限は必要ありません。
GoogleのGenerateContent APIでは、maxOutputTokensによってレスポンスに含める最大トークン数を指定できます(GenerateContent API)。この値は、正常時の出力を計測したうえで決めます。
設定の考え方は次のとおりです。
上限を小さくしすぎると、正常な出力まで途中で切れる可能性があります。一方、余裕を持たせすぎると、出力ループ発生時のトークン消費を十分に抑えられません。そのため、「モデルが出力できる最大値」ではなく、「この処理で許容する最大値」として定義することが重要です。
弊社内のシステムでは、正常時の平均値だけでなく、出力トークン数の分布や上位値、正常な出力が途中で切れないための余裕も確認したうえで、最大出力トークン数を1,000トークンに設定しています。ただし、必要な出力量は処理によって異なるため、同じ値をそのままほかのシステムへ適用するのではなく、正常時の分布を計測して決める必要があります。
1,000トークンで停止すれば、出力料金の上限は1回あたり約0.06円です。仕様上限まで続いた場合の約4.19円と比べて、異常時の出力料金上限を約98.5%削減できます。
最大出力トークン数は、1回の異常生成による影響を抑えるための対策です。しかし、上限到達後にシステムが無制限に再試行すれば、合計コストは増え続けます。そこで、モデルの応答を正常な出力として処理する前に、終了理由とトークン使用量を確認します。
Gemini APIは、モデルが生成を終了した理由をfinishReasonとして返します。通常の停止はSTOP、リクエストで指定した最大トークン数への到達はMAX_TOKENSです。また、usageMetadataから入力、出力、合計のトークン数を取得できます(GenerateContent APIのレスポンス仕様)。
同様の仕組みはほかの生成AI APIにもあります。例えば、ClaudeのMessages APIでは、max_tokensと終了理由を示すstop_reasonを利用できます(ClaudeのStop reasons)。パラメータ名やレスポンス形式は異なりますが、出力上限への到達を検知し、その後の処理を制御するという考え方は共通しています。
出力形式の変換に入る前に終了理由を確認すると、「JSONのパースに失敗した」という結果だけでなく、「出力上限に到達したためJSONが完了しなかった可能性がある」と原因を分類できます。
再試行の方針は、エラーの種類ごとに分けます。
| 状況 | 再試行の考え方 |
|---|---|
| 一時的な通信エラー | 回数を制限し、待機時間を設けて再試行する |
| レート制限 | ベンダーの推奨に従い、待機時間を徐々に延ばして再試行する |
| 出力上限への到達 | 同じ条件で直ちに再試行せず、出力条件や処理方法を見直す |
| JSONの構文エラー | 終了理由を確認し、未完了と形式不正を区別する |
| スキーマ検証エラー | 不一致の項目を記録し、修正指示または代替処理へ進む |
| 同一エラーの連続 | 規定回数で停止し、通知または手動確認へ切り替える |
特に避けたいのは、同じ入力、同じプロンプト、同じ設定で、成功するまで再試行する設計です。試行回数を制限し、同一エラーが続いた場合は停止または手動確認へ切り替えることで、反復出力によるコストの増幅を防ぎます。
安全な再試行にするには、最大試行回数だけでなく、1つの処理全体で許容するトークン数や金額も決めます。たとえば、1回あたりの上限を超えていなくても、複数回の試行を合計したトークン数が予算を超えた場合は停止する、という考え方です。
出力ループは、API呼び出し自体が成功として記録される場合があります。モデルからレスポンスを受け取った後、アプリケーション側の変換で失敗する構成では、APIのエラー率だけを監視しても異常を捉えられません。
最低限記録したい項目は次のとおりです。
監視では、日次の請求額だけでなく、1リクエストあたりの出力トークン数も確認します。日次コストは利用件数の増加でも上昇するため、コストだけでは通常の利用増と異常生成を区別できません。リクエスト単位のトークン数を併用すると、少数の異常なリクエストを特定しやすくなります。
| 監視指標 | 検知できる可能性がある事象 |
|---|---|
| 1リクエストあたりの出力トークン数 | 単発の出力ループ、過剰に長い回答 |
| MAX_TOKENSの発生回数 | 出力上限への到達、上限設定の不整合 |
| Pydanticによる検証・変換の失敗率 | JSON未完了、値や型の不一致 |
| 1処理あたりの再試行回数 | 同じ処理エラーの反復、外部サービスの不調 |
| 処理時間 | 長時間の生成、タイムアウト直前の処理 |
| 日次・時間単位の推定コスト | 全体的な利用量または異常消費の増加 |
AWSが公開しているAmazon Bedrock AgentCore Observabilityの障害調査例でも、トークン使用量が多い一方でエラー率が低い状態を、エージェントのループを見つける兆候として紹介しています。同記事では、トークン上限、実行ステップ数の上限、反復検出、CloudWatchアラームなどが対策として挙げられています(Debugging production agents with Amazon Bedrock AgentCore Observability)。
AIエージェントと単一のモデル呼び出しでは処理構造が異なりますが、「エラー率だけではなく、トークン使用量と処理の軌跡を見る」という考え方は共通しています。利用中のクラウドや監視製品にかかわらず、同様の指標を記録してアラートへつなげることができます。
出力ループへの対策は、1つの設定だけで完結しません。最大出力トークン数を設定しても、それだけでは異常の原因究明や再試行による増幅を防げないためです。
対策を役割ごとに整理すると、次の4層になります。
| 層 | 主な対策 | 目的 |
|---|---|---|
| 制限 | 最大出力トークン数、処理時間、試行回数、処理全体のトークン予算 | 1件の出力ループによる最大損失を限定する |
| 判定 | 終了理由、JSON構文、スキーマ、値の妥当性を段階的に確認する | 処理エラーの原因を分類する |
| 回復 | エラー別の再試行、待機時間の調整、代替モデル、手動確認 | 同じ失敗の反復を避ける |
| 監視 | トークン数、変換失敗率、再試行回数、日次コストへのアラート | 異常を早期に検知する |
また、ストリーミングで出力を受信するシステムでは、同じ文字列やJSON要素が一定回数以上続いた場合に生成を中断する方法も考えられます。ただし、正当な繰り返しを誤検知する可能性があるため、タスクごとの出力特性を踏まえてしきい値を決める必要があります。
生成AIのStructured Outputsは、指定したJSON Schemaに従う出力を得るための有効な仕組みです。Googleも、Structured Outputsの利用時にはアプリケーション側で値を検証し、エラー処理を実装することを推奨しています(Structured outputs)。
Pydanticで検証すると、必須項目の欠落や型の不一致、許容範囲外の値を検出し、不正なデータが後続処理へ渡るのを防げます。ただし、Pydanticによる検証は出力が終わった後に行われるため、出力ループ中のトークン消費は止められません。データの妥当性確認とは別に、最大出力トークン数や再試行回数の上限が必要です。
既存の生成AIシステムを点検する場合は、次の項目から確認できます。
最初から高度な反復検出を実装することが難しい場合でも、最大出力トークン数の見直しと、トークン使用量の記録から始められます。この2点だけでも、出力ループ発生時の影響を限定し、原因を調査するための情報を残せます。
本記事では、生成AIの出力ループがコストへ与える影響と、その対策を整理しました。
生成AIシステムでは、正常時の品質だけでなく、異常時にどこまでトークンを消費し得るかを設計段階で確認することが重要です。まずは現在利用しているモデルの出力上限と、各処理の実際の出力トークン数を比較することから始めるとよいでしょう。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。