生成AI関連
コーディングエージェントを従量課金で走らせる前に ― Bedrock・Azure AI Foundr…
前編では、コーディングエージェント(Claude CodeやCodexなど)の料金モデルを整理し、従量課金で走らせる際のコスト構造と落とし穴を解説しました。
前編の要点は次の3つでした。
後編である本記事では、トークンとコストを抑えるための代表的なテクニックを整理します。個々のテクニックの詳細に立ち入るのではなく、「どのような手法があり、それぞれがコストのどこに効くのか」という全体地図を示すことが本記事の目的です。各テクニックの詳細な手順や検証は、今後の個別記事で扱っていく予定です。
なお、本記事は2026年7月時点の各社公式ドキュメントに基づいています。料金や割引率、コマンド、仕様は変更される可能性があるため、実際の導入にあたっては必ず最新の公式情報をご確認ください。
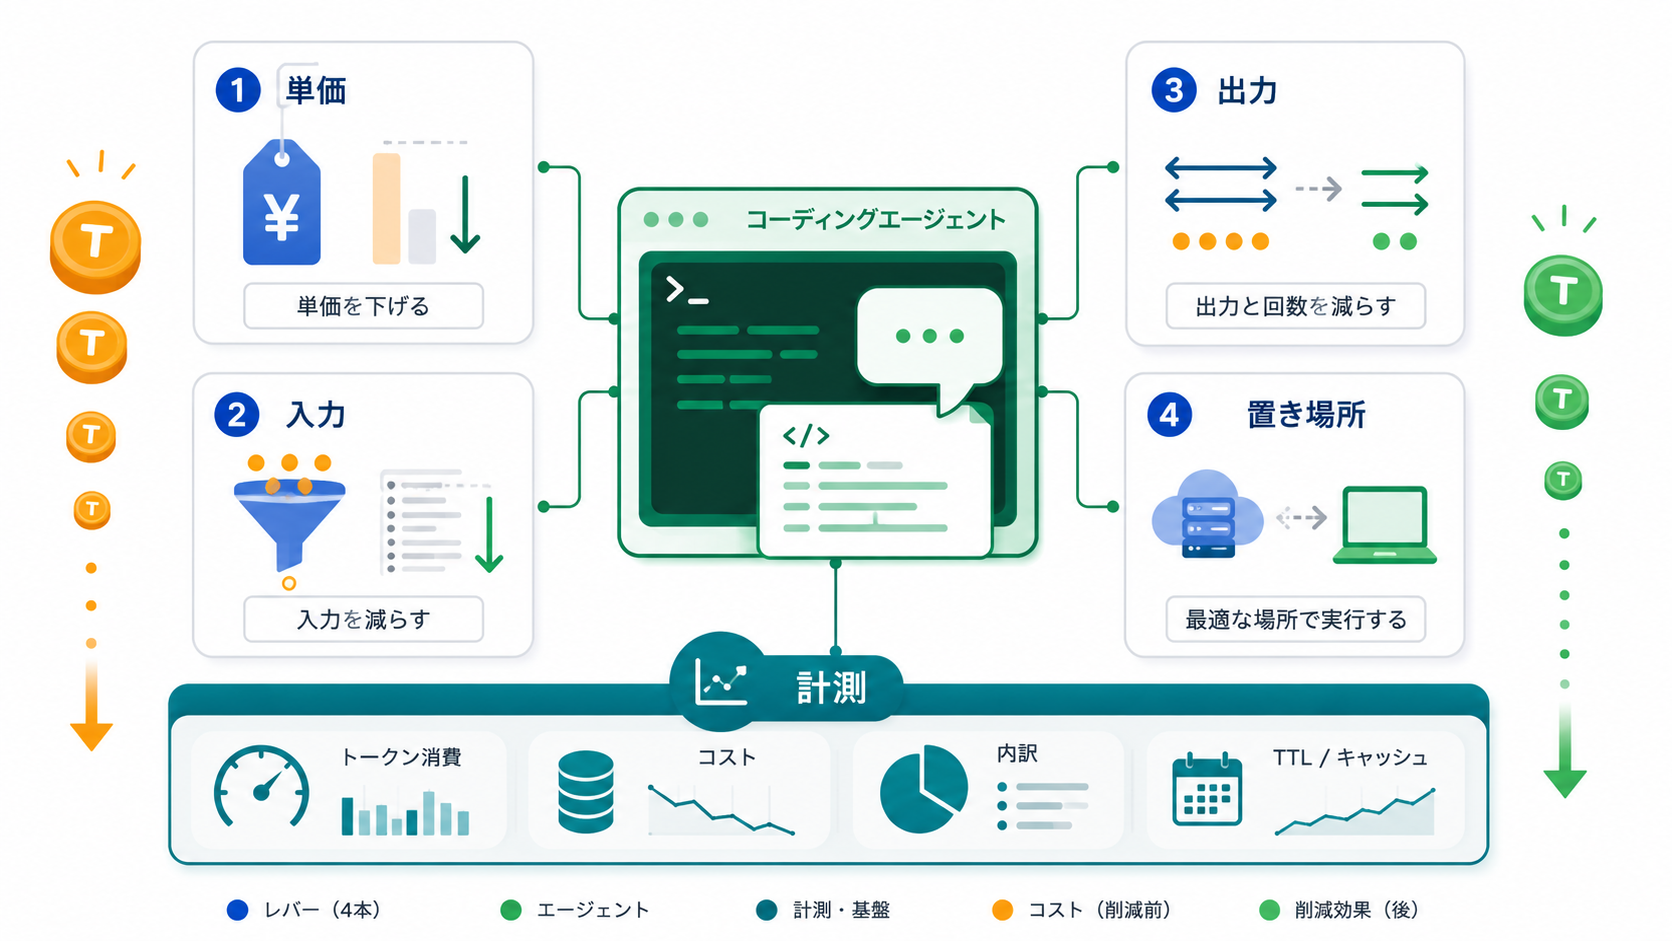
テクニックを個別に暗記するより、まずコストの構造を式で押さえるのが近道です。従量課金のコストは、次のように分解できます。
1ターンのコスト = 入力トークン量 × 入力単価 + 出力トークン量 × 出力単価
セッションのコスト = 1ターンのコストをターン数分合計したもの
この式の各項に対応させると、節約のレバーは次の4本に整理できます。加えて、どのレバーを引くべきかを判断するための前提として「まず測る」があります。
| レバー | 問い | 主なテクニック |
|---|---|---|
| 前提:まず測る | どこでトークンを消費しているか把握しているか | /usage・/context、ccusage、OpenTelemetry、予算アラート |
| レバー1:単価を下げる | 同じトークンをより安く処理できないか | プロンプトキャッシュ、バッチAPI、モデルの使い分け |
| レバー2:送る量を減らす | 毎ターン再送する入力を減らせないか | セッション・スコープ管理、固定コンテキストのスリム化 |
| レバー3:出力と回数を減らす | 生成量と手戻りを減らせないか | 簡潔な出力指示、明確な依頼、プランモード |
| レバー4:置き場所を変える | そもそもクラウドに送らない選択肢はないか | ローカルLLMの併用 |
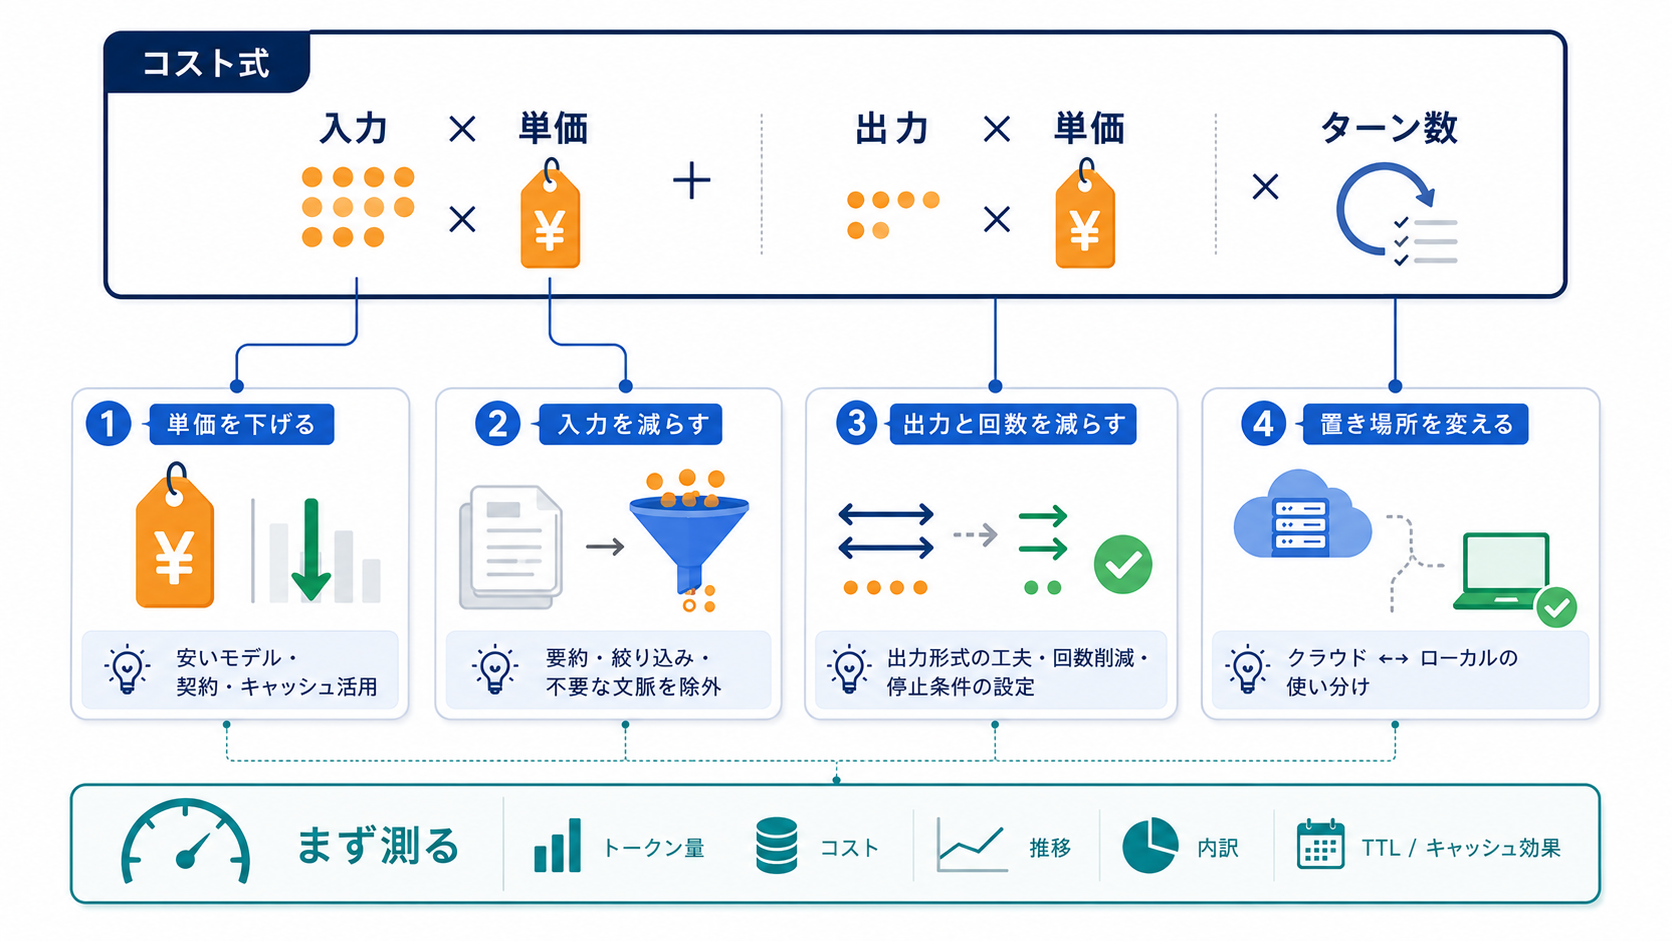
前編で確認したとおり、この構造は従量課金でも定額プランでも変わりません。従量課金では各レバーが請求額の削減に、定額プランでは利用枠の温存に直結します。以降、前提と4本のレバーを順に見ていきます。
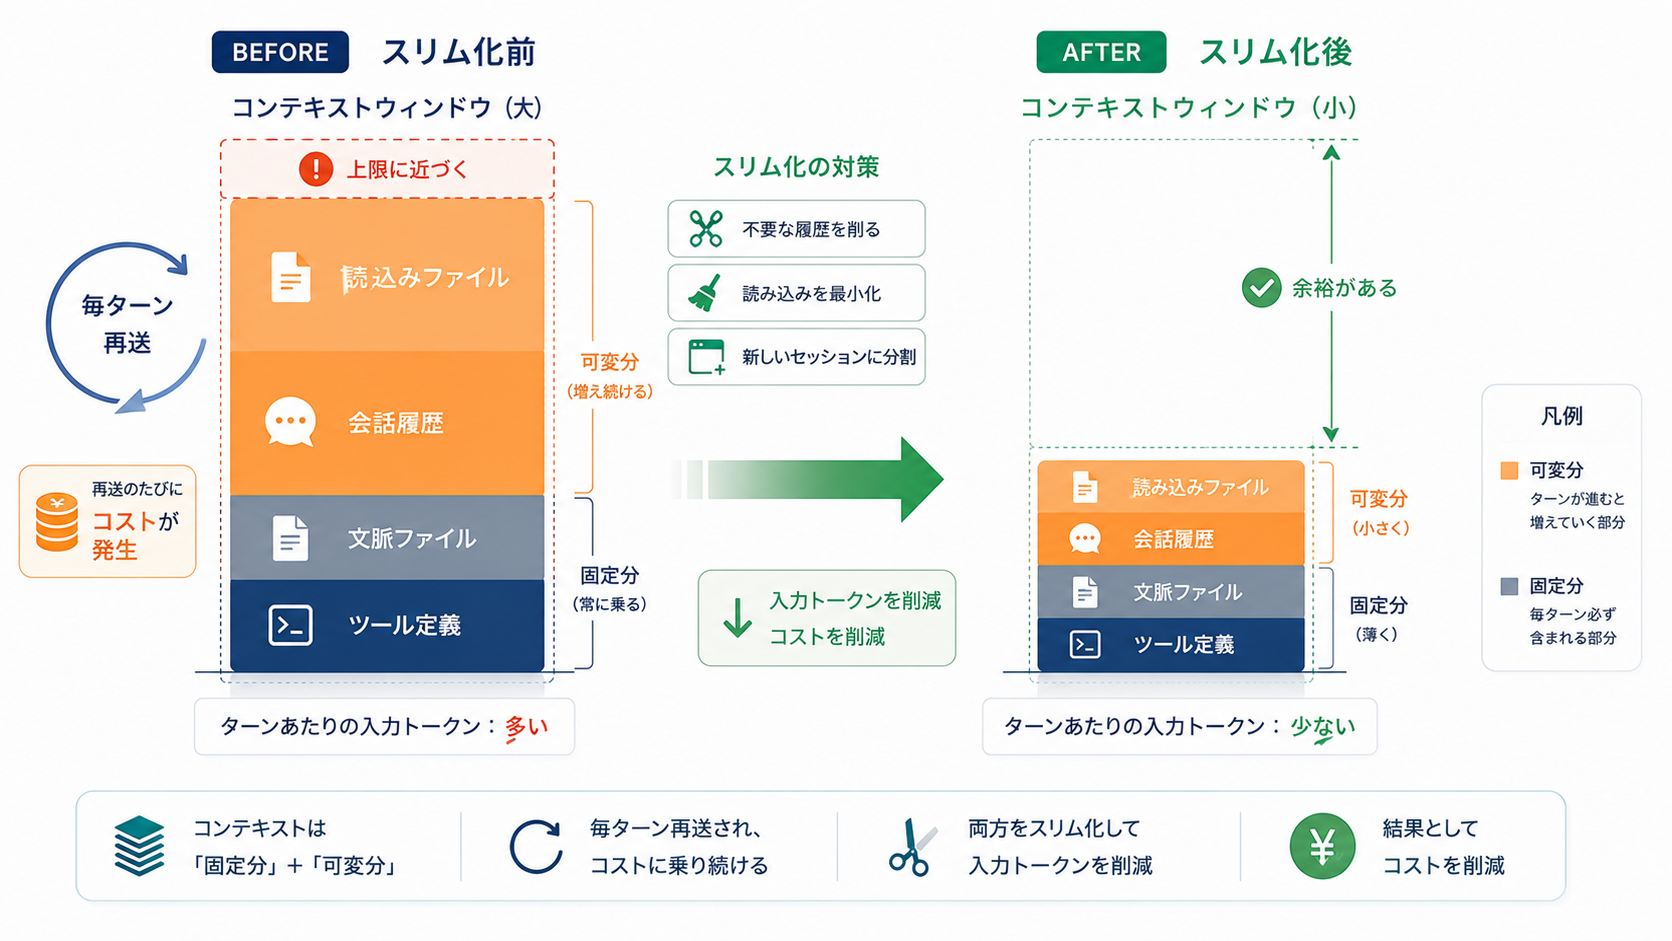
節約の第一歩は計測です。入力と出力のどちらが支配的か、毎ターン乗り続ける固定のコンテキストがどれだけあるかによって、引くべきレバーが変わるためです。主要なエージェントには計測手段が組み込まれており、外部ツールやクラウド側の仕組みで補完できます。
| 手段 | 対象 | わかること |
|---|---|---|
| Claude Codeの /usage(/cost は同コマンドのエイリアス) | セッション/アカウント | セッションのトークン使用量と推定コスト。定額プラン利用時は利用枠の消費状況 |
| Claude Codeの /context | コンテキストウィンドウ | システムプロンプト・ツール定義・メモリ・会話履歴などの内訳と、最適化の提案 |
| Codexの /status・/usage | セッション/アカウント | 使用中のモデル、残りコンテキスト容量、レート制限の残量、アカウント単位の使用履歴 |
| ccusage(サードパーティ製OSS) | ローカルの利用ログ | 日別・セッション別・モデル別の使用量とコストの推定値 |
| OpenTelemetryメトリクス | チーム/組織 | メンバー横断のトークン使用量・コストの集計と監視基盤への統合 |
| クラウド側のコスト管理 | 請求 | AWS BudgetsやMicrosoft Cost Managementによる予算アラート、タグによるコスト按分 |
とりわけ /context は、前編で「固定費」と呼んだ部分の診断に直結します。システムプロンプト、CLAUDE.md、MCPのツール定義、会話履歴がそれぞれ何トークンを占めているかが可視化され、削減余地の見当がつきます。
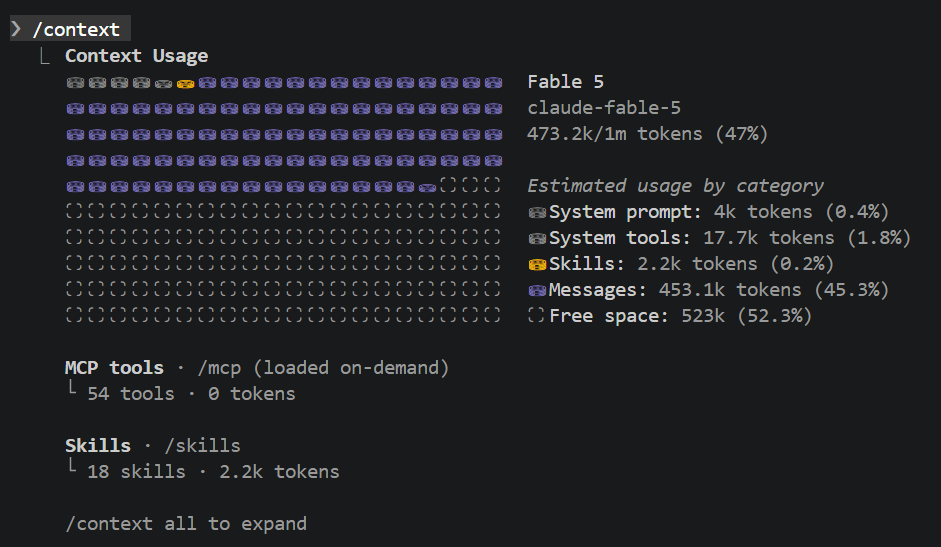
セッション単位の消費は /usage で確認できます。従量課金(API・Bedrockなど)で接続している場合はセッションの推定コストが表示され、定額プランではプランの利用枠に対する消費状況が中心に表示されます。
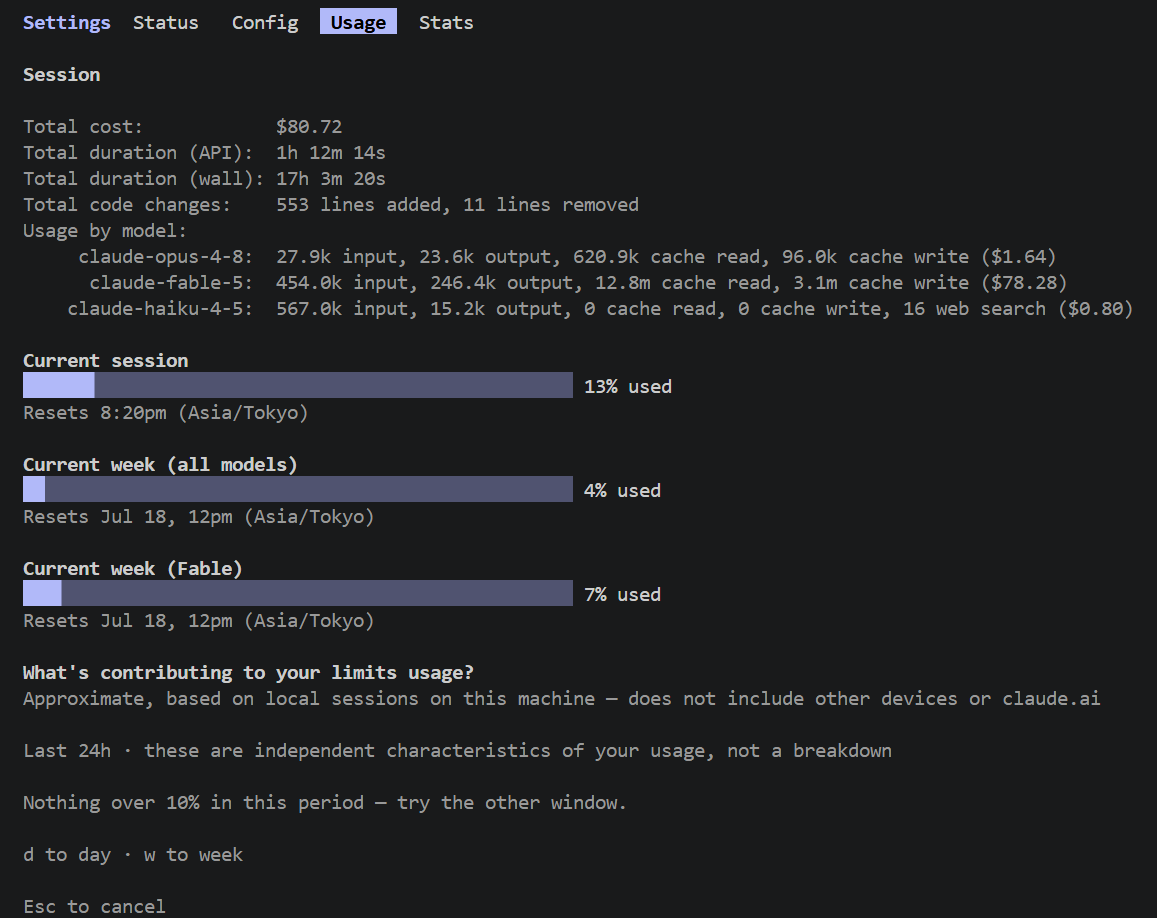
チーム運用では、Claude CodeのOpenTelemetry対応を使うと、トークン使用量やコストをメトリクスとして組織の監視基盤にエクスポートでき、前編で課題として挙げた「誰が何にいくら使ったか」の可視化に近づけます。ccusageのようなサードパーティ製ツールは、ローカルの利用ログから手軽に集計できる反面、表示されるコストは公開価格に基づく推定値である点に注意が必要です。
クラウド基盤側では、AWS BudgetsやMicrosoft Cost Managementで予算のしきい値アラートを設定でき、Bedrockではコスト配分タグやProjectsを使ったプロジェクト別の按分も可能です。従量課金には利用上限がないという前編の落とし穴に対する、最低限の防衛線になります。Bedrockのコスト可視化については、過去記事でも触れています。
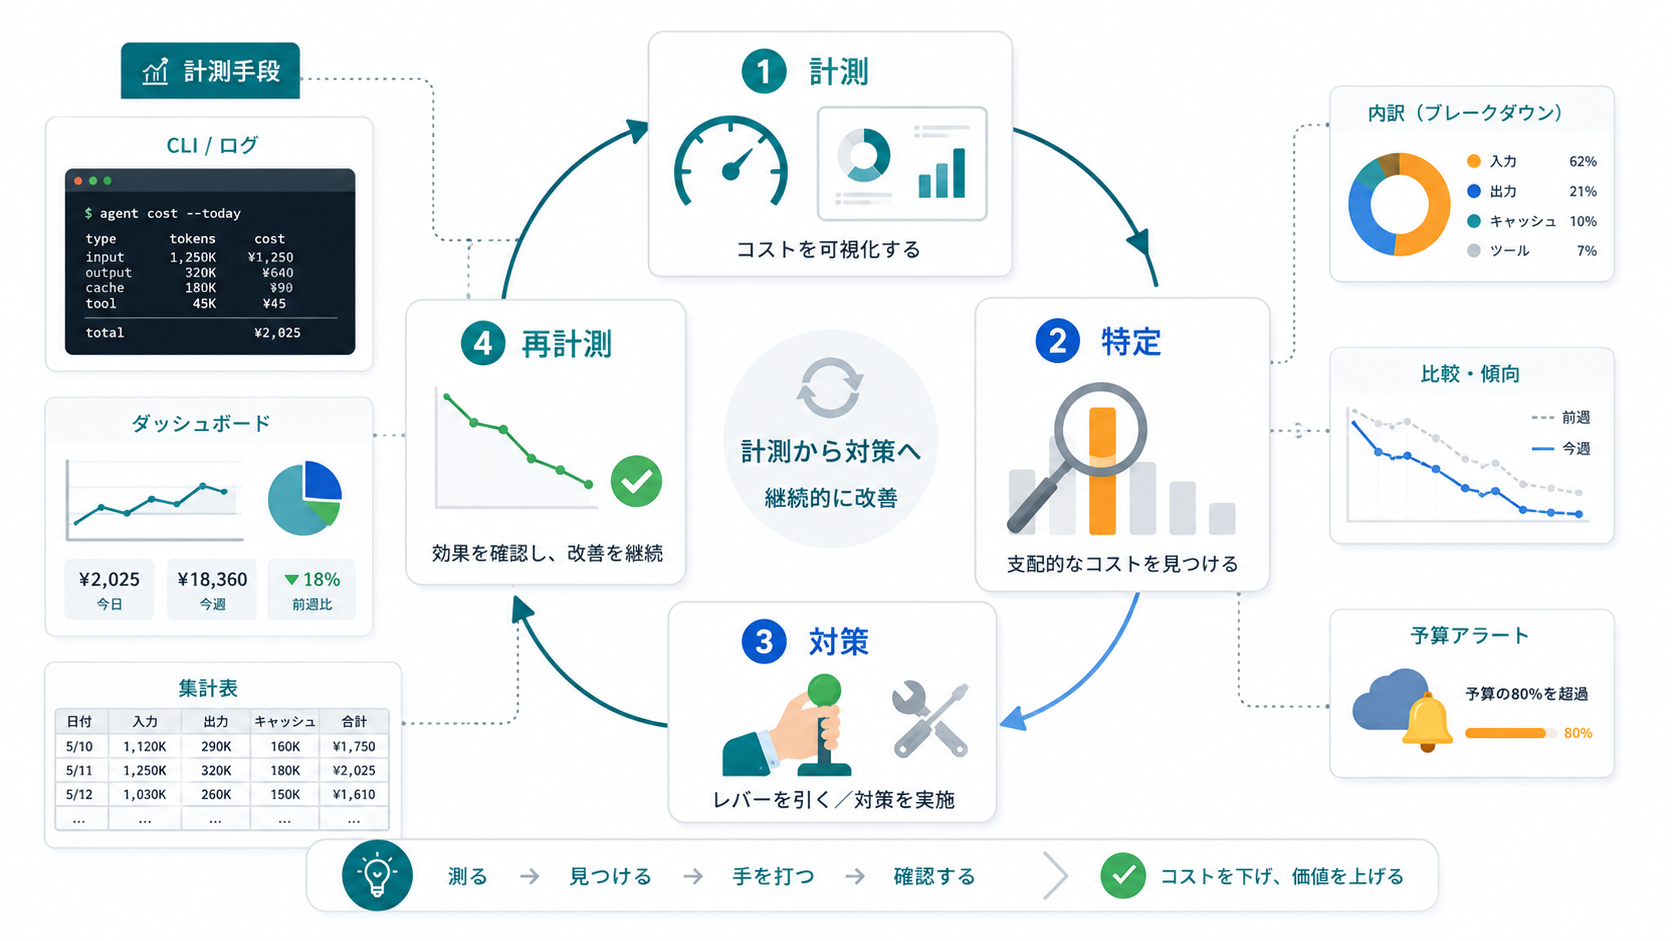
最初のレバーは、消費するトークン量を変えずに、トークンあたりの単価を下げる方法です。
前編で見たとおり、エージェントは毎ターンほぼ同じ文脈を再送します。プロンプトキャッシュは、この繰り返し部分をサーバー側に保持し、再利用時の単価を大幅に下げる仕組みです。Anthropic APIではキャッシュ読み込みが基本入力単価の0.1倍(約9割引)で、書き込みは1.25倍(5分TTL)または2倍(1時間TTL)です。5分TTLの場合、1回読み込まれれば書き込みの割増分の元が取れます。
Claude Code automatically uses prompt caching to optimize performance and reduce costs.
このようにClaude Codeではプロンプトキャッシュが自動で適用され、OpenAI APIでも1,024トークン以上のプロンプトに自動でキャッシュが働き、キャッシュ済み入力は大幅に割引されます(GPT-5.2ではキャッシュ済み入力が通常入力の0.1倍)。利用者が意識すべきは「キャッシュを生かす使い方」です。Anthropicのキャッシュは使用のたびに無償で有効期限が更新されるため、作業を続けている限り生き続けますが、長時間の離席後は再書き込みが発生します。また、キャッシュはプロンプトの前方一致で判定されるため、前方の内容を変える操作はキャッシュを無効化します(後述の「裏目に出るケース」で扱います)。仕組みの詳細は過去記事をご覧ください。
即時の応答が不要な処理には、バッチAPIという選択肢があります。AnthropicとOpenAIのいずれも、バッチ経由の利用は標準価格の50%です。多くのバッチは1時間以内に完了し、処理ウィンドウの上限は24時間です(Anthropicでは期限内に処理されなかったリクエストは期限切れとなり課金されません)。
対話しながらコードを書くエージェントの使い方には適用できませんが、CI/CDでの自動コードレビュー、夜間の一括リファクタリング候補の洗い出し、大量データの分類・整形といった非対話の用途では、置き換えるだけでコストが半分になります。
モデルの階層によって単価は大きく異なります。参考として、Anthropic APIの単価(100万トークンあたり、2026年7月時点)は次のとおりです。
| モデル | 入力 | 出力 |
|---|---|---|
| Claude Opus 4.8 | 5ドル | 25ドル |
| Claude Sonnet 5 | 3ドル(2026年8月末までは導入価格2ドル) | 15ドル(同10ドル) |
| Claude Haiku 4.5 | 1ドル | 5ドル |
最上位と最下位で入力・出力とも5倍の開きがあります。OpenAI側も同様で、たとえばGPT-5.2(入力1.75ドル/出力14ドル)に対し、上位のgpt-5.2-proは入力21ドル/出力168ドルと12倍の差があります。すべての作業に最上位モデルを使う必要はなく、コミットメッセージの生成や単純な修正は下位モデルに、設計判断や難しいデバッグだけ上位モデルに任せる、という使い分けが単価を直接下げます。
Claude Codeでは /model でモデルを切り替えられるほか、サブエージェントの定義に下位モデルを指定して定型作業を安く委譲できます。前編のBedrock接続例に登場した環境変数 ANTHROPIC_DEFAULT_HAIKU_MODEL は、まさにこうした軽量処理・バックグラウンド処理に使う小型モデルを指定するためのものです。計画立案は上位モデル・実装は中位モデルで行う opusplan という設定も用意されています。Codexでも設定ファイルの model や /model コマンドでモデルを切り替えられます。
なお、モデル世代によってトークナイザー(トークンの数え方)が異なる場合があり、同じテキストでもトークン数が変わるため、単価の比率がそのままコストの比率になるとは限らない点には注意が必要です。モデル選定の考え方は、過去記事でも整理しています。
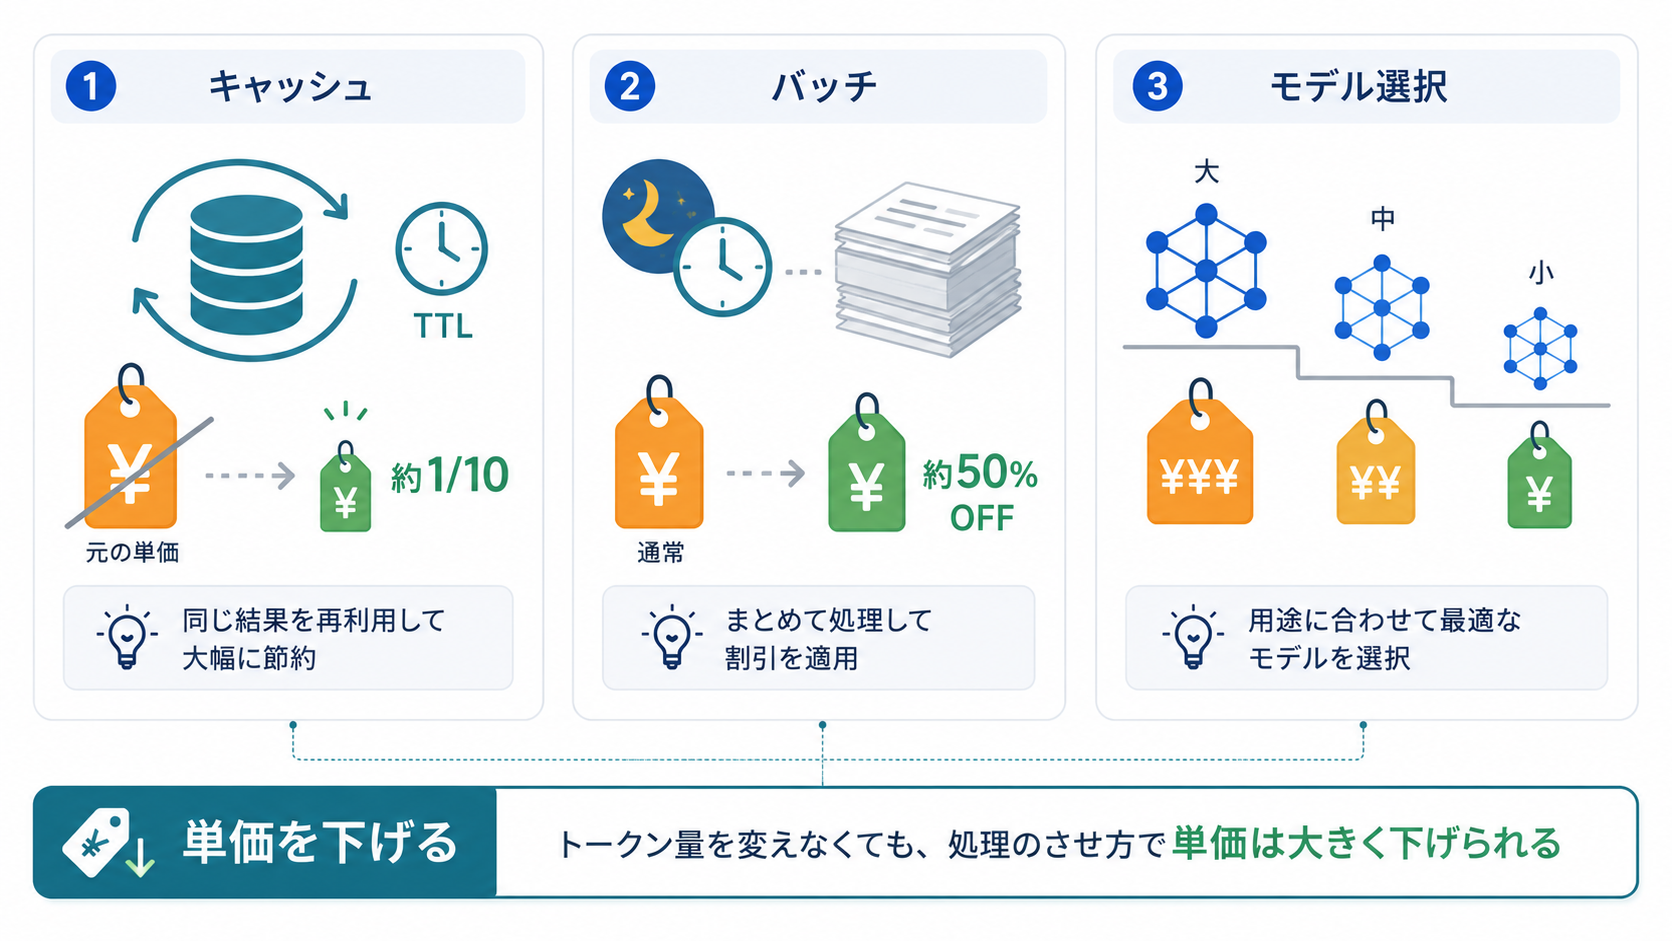
2本目のレバーは、毎ターン再送される入力そのものを減らす方法です。再送される内容は、会話が進むほど増える「可変分」と、毎ターン乗り続ける「固定分」に分けられます。前編の「雪だるま」が可変分、「固定費」が固定分に対応します。
| コンテキストの種類 | 増え方 | 対策 |
|---|---|---|
| 会話履歴・ツール実行結果 | ターンごとに累積 | タスクごとの新セッション、/clear、/compact |
| 読み込んだファイル | 探索するほど累積 | 対象ファイル・ディレクトリの明示 |
| CLAUDE.md / AGENTS.md | 固定(毎セッション) | 内容を簡潔に保つ |
| MCPサーバーのツール定義 | 固定(構成に依存) | 使わないサーバーを外す、遅延読み込みの活用 |
| Skills | 必要時のみ読み込み | 説明文と本文を短く保つ |
もっとも効果が大きいのは、セッションを長引かせないことです。関係のない作業を同じセッションで続けると、無関係な履歴を毎ターン再送し続けることになります。タスクの区切りで新しいセッションを開始するか、/clear でリセットするのが基本です。履歴の要点を保ちたい場合は /compact(Claude Code・Codexの双方にあります)で会話を要約して圧縮できます。あわせて、調査対象のファイルやディレクトリを指示で明示し、エージェントに広く探索させないことも、読み込みトークンの削減に効きます。
こうしたセッション管理は、過去記事ではコンテキスト肥大による品質低下への対策として紹介しました。同じ操作が、コスト面では再送トークンの削減としてそのまま機能します。
CLAUDE.mdやAGENTS.mdといった文脈ファイルは、セッション開始時に読み込まれ、以降のすべてのターンで再送され続けます。特定の作業でしか使わない詳細な手順を書き込むと、無関係な作業中もそのトークンを払い続けることになります。公式ドキュメントでも簡潔に保つことが推奨されています。
MCPサーバーのツール定義も固定分の代表です。ただし2026年7月時点のClaude Codeでは、ツール検索(Tool Search)がデフォルトで有効になり、セッション開始時にはツール名などの最小限の情報だけを読み込み、定義本体は必要になったときに読み込む方式に変わっています。それでも、全ツールを前方読み込みする設定や、この仕組みに対応しない構成では従来どおり固定費として乗るため、使っていないMCPサーバーを構成から外すことが確実な削減策です。
Skillsは、この「必要になるまで読み込まない」という考え方(段階的開示)を仕組みとして備えており、常時コンテキストに載せる方式よりも入力トークンを節約できます。固定分がどれだけ減ったかは、前述の /context で確認できます。
3本目のレバーは、モデルが生成する量と、やり取りの回数を減らす方法です。前掲の単価表のとおり、出力トークンの単価は入力の5倍前後です。「変更点の説明は簡潔に」「差分だけ示す」といった出力への指示は、体裁の好みの問題ではなく、単価の高いトークンの削減として直接コストに効きます。拡張思考(推論)のトークンも出力として課金されるため、タスクの難度に応じて推論の深さを調整できる設定(Codexの model_reasoning_effort など)も削減余地になります。
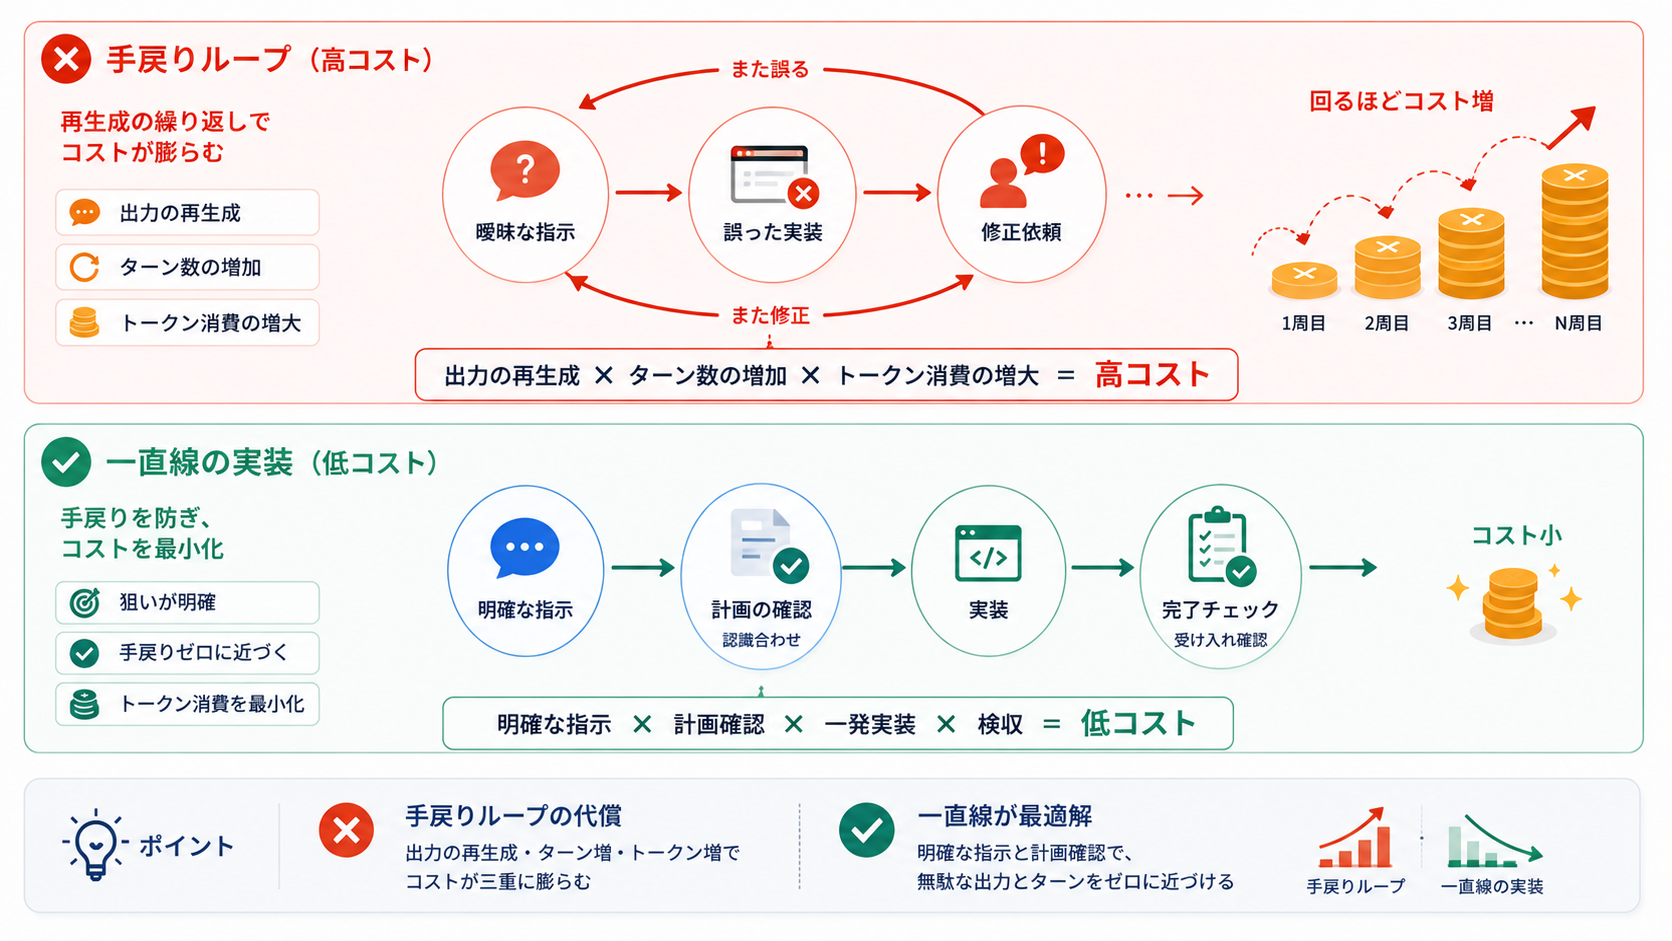
ターン数の削減で大きいのは、手戻りをなくすことです。曖昧な指示で誤った実装をさせて修正を繰り返すと、単価の高い出力を何度も生成させながら、膨らんだ履歴を毎ターン再送するという形でコストが三重にかさみます。
| 手戻りを生みやすい指示 | 手戻りを減らす指示 |
|---|---|
| ログイン機能を直して | src/auth/login.ts のセッション有効期限切れ時に再ログインを促すよう修正して。テストは tests/auth を更新 |
| いい感じにリファクタリングして | UserService の重複したバリデーション処理を validators.ts に抽出して。公開APIは変えない |
また、Claude Codeのプランモードのように、実装前に方針を確認するフェーズを挟む機能は、公式ドキュメントでもコスト管理策として推奨されています。方向違いの実装をやり直す高コストなループを、着手前の合意形成で防ぐという考え方です。
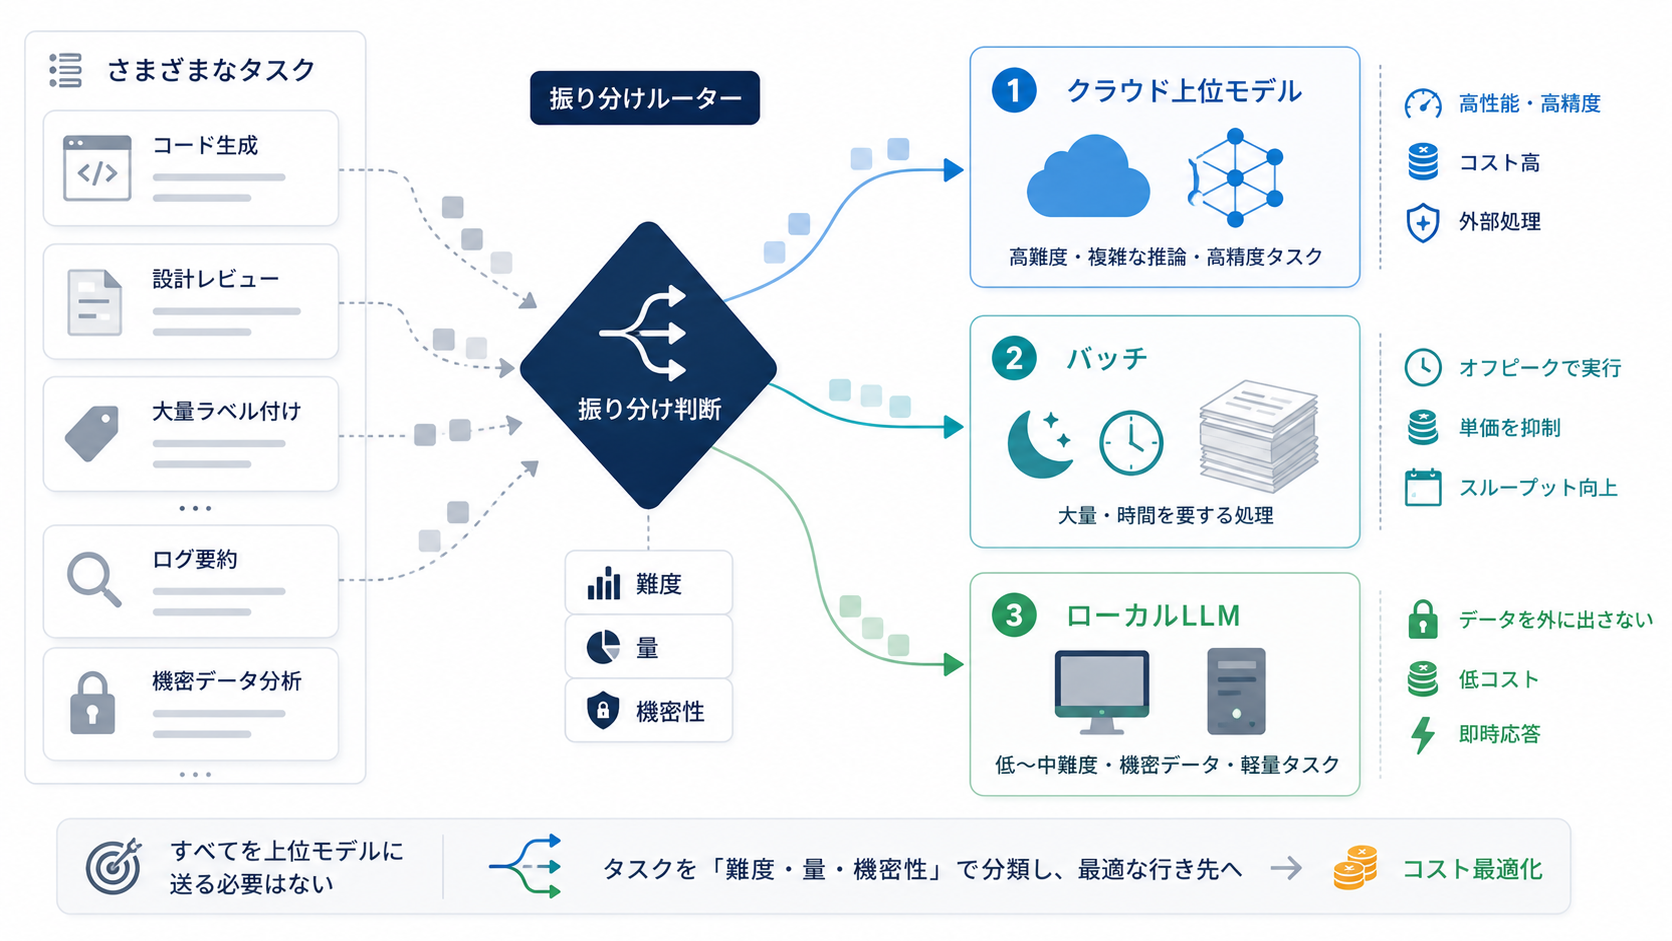
4本目のレバーは、処理の置き場所そのものを変える方法です。コミットメッセージの生成、簡単な分類や要約、定型的な変換といった、高い推論能力を必要としないタスクをローカルLLMに移せば、その分のクラウド従量課金はゼロになります。
| タスクの特性 | 向き先 |
|---|---|
| 難度が高い・非定型(設計、複雑なデバッグ) | クラウドの上位モデル |
| 定型・大量・即時性不要 | バッチAPI、またはローカルLLM |
| 機密性が高くクラウドに送れない | ローカルLLM |
ただしローカルLLMは、クラウドの変動費が消える代わりに機材・電力・運用という固定費が発生するため、単純にどちらが安いとは言えません。品質もクラウドの上位モデルと同等ではないため、タスクの難度で振り分けるのが現実的です。導入方法や機材の考え方は、過去記事で整理しています。
最後に、良かれと思った操作がかえってコストを増やす、代表的な落とし穴を押さえておきます。
| 陥りやすい操作 | 何が起きるか | 対処 |
|---|---|---|
| サブエージェントの多用 | 各エージェントが独立したコンテキストで探索するため、合計トークンはむしろ増えることがある | 定型作業のサブエージェントに下位モデルを割り当てる |
| セッション途中のモデル切替 | キャッシュはモデルごとに別のため、全履歴をキャッシュなしで再送する | モデルの切り替えはセッションの区切りで行う |
| セッション途中のCLAUDE.md編集・MCPサーバーの付け外し | プロンプトの前方が変わり、以降のキャッシュが無効化される | 構成変更はセッション開始前に済ませる |
| こまめな /compact | 要約の生成自体が1回分のリクエストで、会話部分のキャッシュも無効化される | 意味のある区切りで実行し、不要なら新セッションを選ぶ |
| 予算アラート頼みのコスト管理 | アラートは事後通知であり、利用を自動停止するハードリミットではない(AWS Budgetsの更新は1日最大3回で数時間の遅延がある) | アラートに加えて、消費を抑える運用と定期的な計測を組み合わせる |
| 過度なコンテキスト削減 | 必要な文脈まで削ると品質が下がり、手戻りでかえって高くつく | まず測り、支配的な項から着手する |
サブエージェントは、メインの会話履歴を汚さず品質を保つ手段としては有効ですが、コスト削減策として単体で機能するわけではない点に注意が必要です。またプロンプトキャッシュは「静的な内容を前に、動的な内容を後ろに」置くことで効く仕組みであるため、前方に位置する構成要素(モデル、ツール定義、文脈ファイル)をセッション途中で動かさないことが、キャッシュを生かす運用の基本になります。
本記事では、コーディングエージェントのトークン節約テクニックを、コスト式の分解に基づく4つのレバーとして整理しました。要点を振り返ります。
個々のテクニック、特にプロンプトキャッシュを生かすセッション運用や、サブエージェントへのモデル割り当て、OpenTelemetryによるチームのコスト可視化については、今後の記事で個別に取り上げていく予定です。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。