生成AI関連
生成AIのテキスト生成のしくみとパラメータ
生成AIといえば「テキストを入れて、テキストが返ってくるもの」というイメージが強いかもしれません。しかし、最近の主要モデルはテキスト以外の入力にも対応するようになっています。画像、音声、動画、PDF——こうした複数の情報形式を扱える能力を「マルチモーダル」と呼びます。
本記事では、マルチモーダルとは何かを整理したうえで、最も身近なユースケースである画像解析を実際に試しながら、その可能性と注意点を確認していきます。
過去の記事ではテキスト生成の仕組みやパラメータについて解説しました。今回はその延長として、「テキスト以外」の世界を覗いてみましょう。
「モーダル(modality)」とは、情報の形式・種類を指す言葉です。
| モーダル | 具体例 |
|---|---|
| テキスト | 文章、コード、構造化データ |
| 画像 | 写真、スクリーンショット、図表 |
| 音声 | 録音データ、音声入力 |
| 動画 | 映像ファイル、画面録画 |
| ファイル | PDF、Excel |
従来のLLMはテキストのみ(シングルモーダル)でしたが、現在の主要モデルは複数のモーダルを組み合わせて処理できます。これがマルチモーダルAIです。
マルチモーダルには、入力側と出力側の2つの軸があります。
| 方向 | 例 | 対応状況 |
|---|---|---|
| マルチモーダル入力 | 画像+テキストを渡して質問する | 多くのモデルが対応済み |
| マルチモーダル出力 | テキストの指示から画像を生成する | 一部のモデルが対応 |
本記事では、実務ですぐに活用しやすいマルチモーダル入力(特に画像+テキスト)に焦点を当てます。
現在、OpenAI(GPT) 、Google(Gemini) 、Anthropic(Claude)といった主要ベンダーのモデルはいずれも画像入力に対応しており、「画像を読み取って分析する」用途であればどれを選んでも始められます。
画像をLLMに渡すと、具体的にどんなことができるのでしょうか。代表的なユースケースを整理します。ただし、後述する通りユースケースによって精度の差が大きいのが現状です。「できること」と「実用に耐えること」は別なので、各ユースケースの注意点もあわせて確認してください。
紙の書類やPDFのスキャン画像から、テキスト情報を抽出できます。
従来のOCR(光学文字認識)と異なり、LLMは文脈を理解したうえで読み取るため、多少の汚れや崩れた文字にも強い傾向があります。
ただし、PDFをそのままLLMに渡す場合は注意が必要です。PDFの処理方法はモデルによって異なり、埋め込まれたテキスト情報のみを抽出するモデル、ページを画像として視覚的に解析するモデル、テキストとページ画像の両方を抽出してモデルに送信するものもあります。テキスト抽出のみのモデルでは、テキストデータを持たないスキャン画像のPDFを正しく読み取れない場合があります。確実に処理したい場合は、事前にページを画像に変換してから画像入力として渡す方法が安定します。
PDF入力の扱いは、各ベンダーの公式ドキュメントもあわせて確認してください。
また、手書き文字の読み取りは精度にばらつきがあります。丁寧に書かれた文字であればかなり読み取れる一方、崩し字や走り書きになると精度が大きく落ちます。文字の上手い・下手が精度に直結するため、「誰の手書きでも読める」とは言えません。手書き文字の読み取りを業務に組み込む場合は、事前に対象となる手書きサンプルで精度検証を行うことをおすすめします。
スクリーンショットやモックアップを渡して、フィードバックを得られます。
データの可視化結果を画像で渡し、読み解きを依頼できます。
ただし、図表の種類によって精度の差が大きい点は押さえておく必要があります。シンプルな棒グラフや折れ線グラフであればおおむね正しく読み取れますが、設計図・回路図・複雑な構成図になると精度が大きく下がります。弊社でも検証しましたが、設計図の読み取りは現時点では実用に耐えないケースが多いという結果でした。「グラフの概要を掴む」程度の用途には使えますが、正確な数値の読み取りや専門的な図面の解析を任せるのは時期尚早です。
製造業や建設業など、現場の写真を使った確認作業にも活用が期待されています。
こちらも期待値の調整が必要な領域です。「明らかに大きな破損がある」程度の判定はできることがありますが、微細な劣化や専門知識が必要な判断は難しく、人間の目視確認を置き換えるレベルには至っていません。補助ツールとしての位置づけが現実的です。
ここからは、実際にAPIを使って画像解析を試してみましょう。以下のサンプル請求書を使って、画像からデータを抽出する流れを確認します。
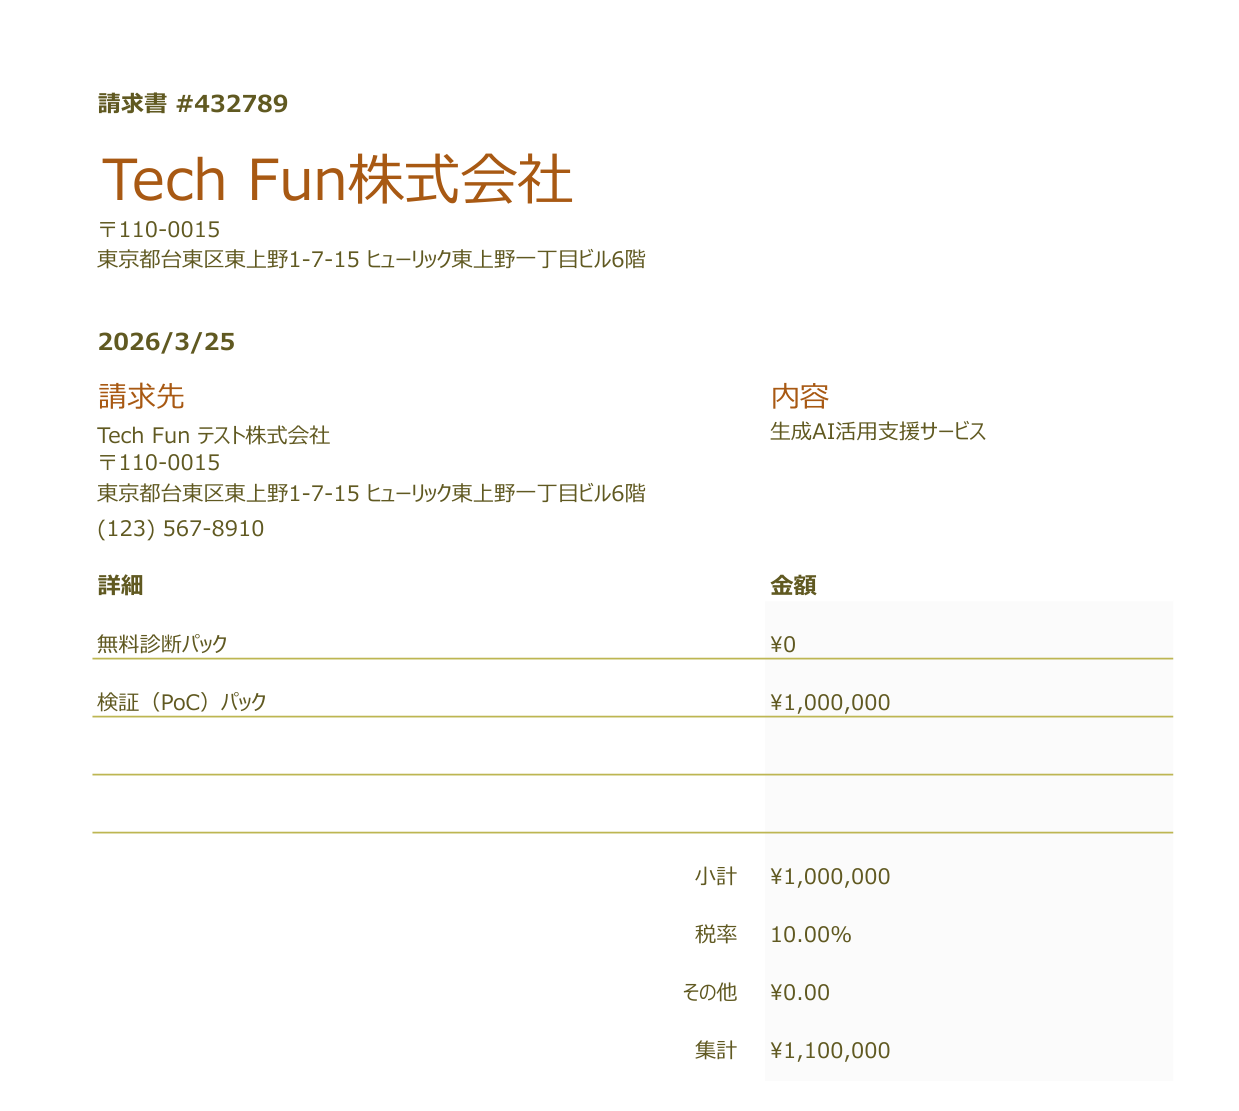
弊社で検証した限り画像解析の精度が高かったGeminiを使い、画像を渡して分析結果を得る流れを紹介します。
※ OpenAI(GPT)やAnthropic(Claude)でも同様に画像を渡して解析できますが、画像の渡し方やStructured Outputの指定方法はモデルごとに異なります。各モデルのAPIを利用する際は、公式ドキュメントで画像入力の仕様を確認してください。
画像ファイルを読み込み、Geminiに分析を依頼する最小限のコードです。
from google import genai
from PIL import Image

client = genai.Client()

# 画像ファイルを読み込み
image = Image.open("invoice_sample.png")

response = client.models.generate_content(
    model="gemini-2.5-flash",
    contents=[
        "この請求書の内容を読み取り、以下の項目を返してください:請求書番号、請求日、請求先、内容、明細(品名・金額)、小計、税率、合計金額",
        image,
    ],
)

print(response.text)
ポイントは、contents にテキストと画像をリストで並べて渡す点です。PIL.Image オブジェクトをそのまま渡せるため、バイト列の読み込みやMIMEタイプの指定は不要です。
実行すると、以下のようなテキストが返ってきます。
請求書の内容は以下の通りです。

*   **請求書番号:** 432789
*   **請求日:** 2026/3/25
*   **請求先:** Tech Fun テスト株式会社
*   **内容:** 生成AI活用支援サービス
*   **明細:**
    *   無料診断パック: ¥0
    *   検証 (PoC) パック: ¥1,000,000
*   **小計:** ¥1,000,000
*   **税率:** 10.00%
*   **合計金額:** ¥1,100,000
画像から請求書の各項目を正しく読み取れていることがわかります。ただし、出力はマークダウン形式の自由テキストであり、フォーマットは毎回変わる可能性があります。プログラムで後続処理に渡す場合は、次に紹介するStructured Outputの利用を検討してください。
公式リファレンス:
上記のコードでも「JSONで返してください」とプロンプトで指示すれば、それらしいJSONが返ってきます。しかし、プロンプトによる指示はあくまで"お願い"に過ぎません。実際には以下のような問題が起こりえます。
こうした問題は、画像解析のように入力が毎回異なるケースでは特に起きやすくなります。そこで活用したいのがStructured Output(構造化出力)です。Pydanticでスキーマを定義し、モデルの出力形式をAPIレベルで強制することで、安定したJSON出力を得られます。
以下は、請求書の読み取り結果をPydanticモデルで定義した例です。
from google import genai
from PIL import Image
from pydantic import BaseModel, Field

class InvoiceItem(BaseModel):
    item_name: str = Field(description="品名")
    amount: int = Field(description="金額(円)")

class Invoice(BaseModel):
    invoice_number: str = Field(description="請求書番号")
    invoice_date: str = Field(description="請求日(YYYY-MM-DD形式)")
    client_name: str = Field(description="請求先の会社名")
    description: str = Field(description="内容")
    items: list[InvoiceItem] = Field(description="明細")
    subtotal: int = Field(description="小計(円)")
    tax_rate: float = Field(description="税率")
    total_amount: int = Field(description="合計金額(税込、円)")

client = genai.Client()

image = Image.open("invoice_sample.png")

response = client.models.generate_content(
    model="gemini-2.5-flash",
    contents=[
        "この請求書の内容を読み取ってください。",
        image,
    ],
    config={
        "response_mime_type": "application/json",
        "response_schema": Invoice,
    },
)

# パース済みのPydanticモデルを取得
invoice = response.parsed
print(invoice)
config に response_mime_type と response_schema を指定することで、モデルは定義したスキーマに沿ったJSONを返します。response_schema にはPydanticクラスをそのまま渡せます。また、response.parsed を使えば、手動でJSONをパースする必要もなく、Pydanticモデルのインスタンスを直接取得できます。
公式リファレンス:
上記のコードを請求書の画像に対して実行すると、以下のようなJSONが返ってきます。
{
  "invoice_number": "432789",
  "invoice_date": "2026-03-25",
  "client_name": "Tech Fun テスト株式会社",
  "description": "生成AI活用支援サービス",
  "items": [
    { "item_name": "無料診断パック", "amount": 0 },
    { "item_name": "検証(PoC)パック", "amount": 1000000 }
  ],
  "subtotal": 1000000,
  "tax_rate": 0.1,
  "total_amount": 1100000
}
スキーマで定義したフィールド名・型に沿った出力が得られるため、プロンプトのみで指示する場合と比べてパースエラーのリスクを大幅に減らせます。ただし、モデルの応答である以上、まれにスキーマに合わない出力が返る可能性はゼロではないため、後続処理ではエラーハンドリングを入れておくことをおすすめします。
今回のデモでは、読み取りやすいレイアウトのサンプル請求書を用意して実行しました。そのため、すべての項目が正確に読み取れていますが、実際の業務で扱う書類では同じ精度が出るとは限りません。手書きの文字、複雑なレイアウト、低解像度のスキャン画像など、条件が変わると精度は大きく変動します。
「自分の業務でも使えそうだ」と感じた方は、まず実際に処理したい書類で精度検証を行うことをおすすめします。期待する精度が出るか、どのモデルが最適か、プロンプトの工夫でどこまで改善できるかは、対象データで試してみなければわかりません。
弊社Tech Funでは、無料診断パックにて、生成AIが業務に活用できるかの診断を無料で行っています。「この書類を自動で読み取れるか試してみたい」といった段階からご相談いただけますので、お気軽にお問い合わせください。
画像解析の精度は、画像の品質とプロンプトの書き方に大きく左右されます。
| ポイント | 説明 |
|---|---|
| 解像度 | 文字が読める程度の解像度を確保する |
| トリミング | 不要な余白や関係ない領域は事前にカットする |
| コントラスト | 文字と背景のコントラストが低いと読み取り精度が落ちる |
マルチモーダルAIは強力ですが、万能ではありません。導入前に押さえておくべき注意点があります。
画像に含まれない情報を「読み取った」かのように出力することがあります。特に、低解像度の画像や判読困難な文字に対してこの傾向が強くなります。
金額や日付など、業務上クリティカルな情報は必ず人間が確認する運用を組み込んでください。
画像をAPIに送信するということは、その画像データがクラウド上で処理されるということです。
機密情報と生成AIの関係については、以下の記事も参考にしてください。
モデルが学習データの中で見たことのない固有名詞——社内用語、独自の製品名、ニッチな業界の略語など——は、読み取り精度が落ちやすい傾向があります。画像から文字としては正しく認識できていても、それを別の既知の単語に「補正」してしまうケースがあるためです。固有名詞の正確性が求められる場合は、出力結果の照合を必ず行ってください。
また、用語があらかじめ決まってる場合は専門用語集を渡すのも有効です。
本記事の「画像解析で何ができるのか」でも触れましたが、現時点のマルチモーダルAIには明確な苦手分野があります。改めて整理すると以下の通りです。
| 苦手な入力 | 具体例 | 現状の精度 |
|---|---|---|
| 設計図・回路図・複雑な構成図 | CAD図面、ネットワーク構成図 | 実用に耐えないケースが多い |
| 手書き文字 | 崩し字、走り書き、メモ | 文字の上手い・下手に大きく依存 |
| 微細な異常の検出 | 設備の小さな劣化、微小な傷 | 人間の目視を代替するレベルにない |
| 極端に小さい文字や密なレイアウト | 細かい表、注釈だらけの資料 | 読み飛ばしや誤認識が発生しやすい |
「できること」と「実用に耐えること」は別です。導入前にかならず対象データで精度検証を行い、期待値を合わせたうえで運用に組み込むことをおすすめします。
マルチモーダルは「テキストの次」として注目されがちですが、実際には業務の中に画像・書類・図表はすでに大量に存在しています。生成AIの適用範囲を広げる第一歩として、まずは手元の画像を1枚APIに渡してみるところから始めてみてはいかがでしょうか。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた支援を3つのパックでご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。