生成AI関連
RAGの検索設計:テキスト検索・ベクトル検索・ハイブリッド検索・エージェント検索の違い
RAGを運用していると、検索結果を見ながら「この文書が上に来てくれれば答えられるのに」と感じる場面があります。検索そのものが失敗しているわけではありません。候補を30件まで広げれば必要な文書は含まれています。ところがLLMへ渡すのは上位5件だけという設計のため、その5件に残らなければ回答の根拠として使われません。
検索件数を増やせばこの取りこぼしは減りますが、今度は関係のない文書が一緒に入ってきます。LLMへ渡す文脈量も増え、費用と応答時間が上がります。かといって件数を絞れば、元の取りこぼしが戻ってきます。
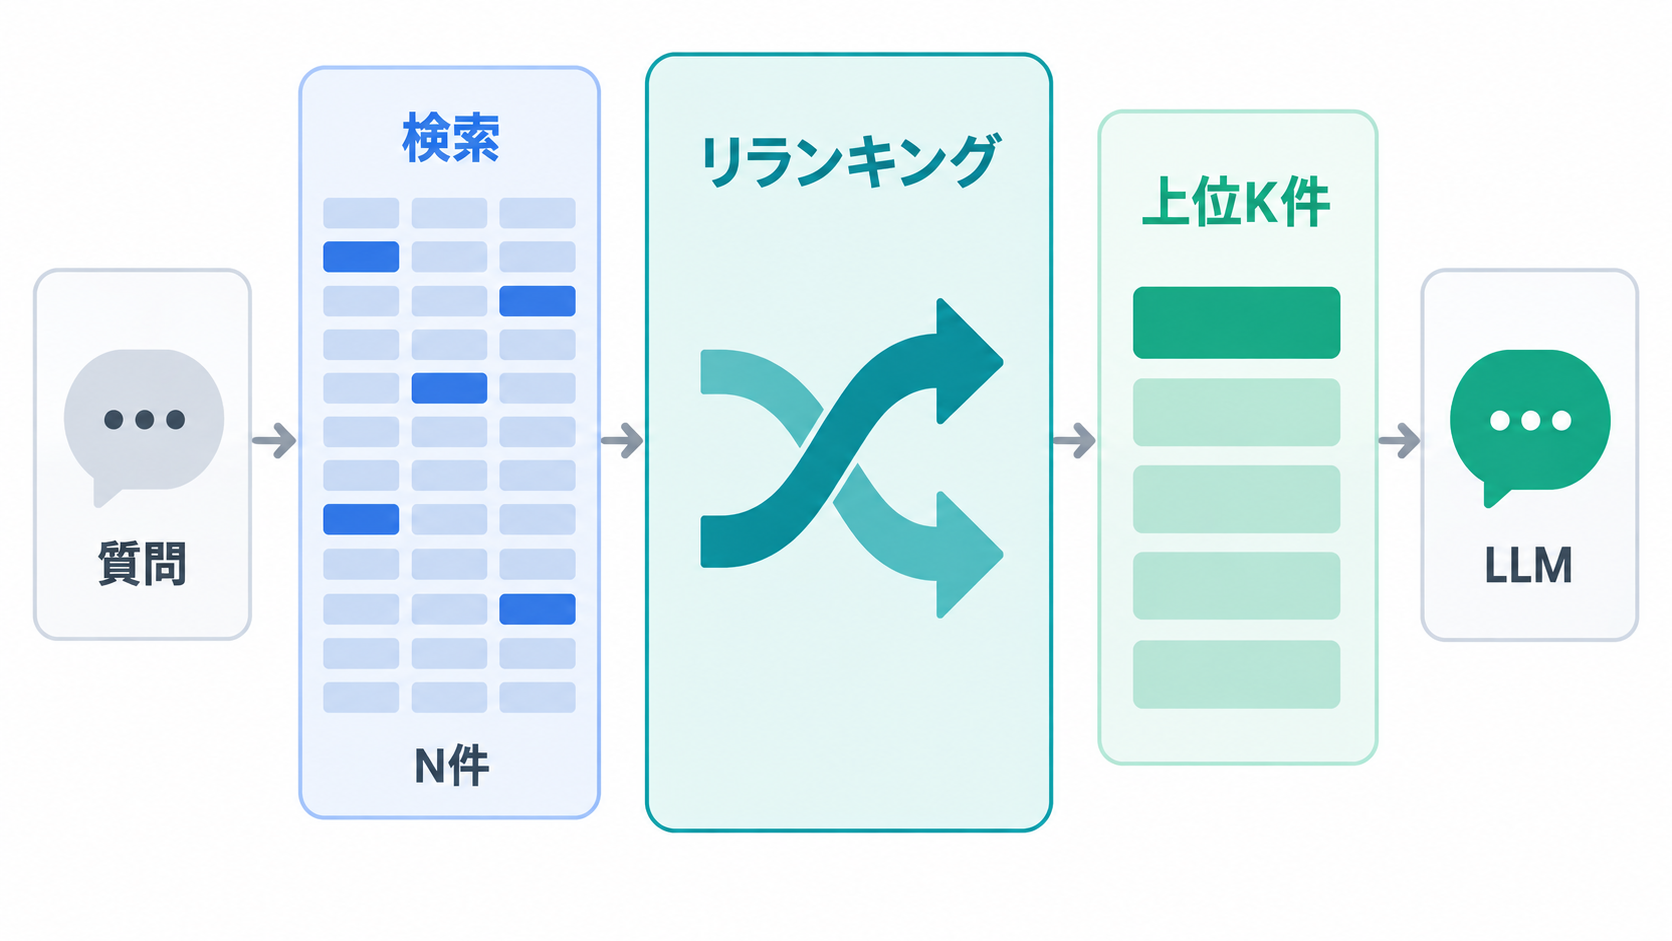
この「候補には入るが上位に出ない」状態に対する手段のひとつが、集めた候補を並べ直すリランキングです。検索件数は増やさないまま、候補の中での順位だけを付け替えます。Amazon Bedrockには専用のRerank APIがあり、既存の検索結果をそのまま渡して順位を付け替えられます。
ただし、リランキングは1回の検索につきAPI呼び出しが1回増えます。応答時間も費用も追加でかかるため、どのくらい効くのかを測らないまま導入は決められません。
この記事では、リランキングの仕組みを整理したうえで、同じ文書・同じ質問・同じ候補件数で、リランキングの有無だけを変えた実測結果を示します。
なお、検索手法の選び方や評価指標そのものについては、下記の記事で解説しています。本記事はそれらを前提に、リランキングの実測比較に絞ります。
検証の対象は検索結果の順位だけです。リランキング後の候補を使ってLLMが生成した回答の品質は、今回は評価していません。
ベクトル検索は、文書を事前にベクトル化してインデックスに入れておき、質問もベクトル化して近いものを探す仕組みです。文書側の計算は登録時に済んでいるため、数万件が相手でも一瞬で上位数十件を取り出せます。その代わり、質問と文書は最後まで別々に処理されます。それぞれを単独でベクトルに変換し、そのベクトル同士の距離を比べているだけで、「この質問に対してこの文書は答えになっているか」を突き合わせて読んではいません。話題は合っているのに答えになっていない文書が上位へ来るのは、このためです。
精度を上げるなら、質問と文書を1つの入力としてまとめて読ませ、関連度を判定させるほうが確実です。ただしこの方式は、質問が来てから文書1件ずつに計算を走らせる必要があり、数万件を相手にするとまったく間に合いません。
そこで処理を2段階に分けます。まず高速な検索で候補を数十件へ絞り込み、次にその候補だけを対象として、質問と文書のペアを丁寧に評価し直し、順位を付け替えます。この後半の工程をリランキングと呼びます。対象が数十件に限られているため、1件ずつ読む方式でも現実的な時間で終わります。
候補が数十件で済むなら、並べ直さずに全部LLMへ渡してしまえばよさそうです。順位が多少ずれていても、必要な文書さえ入力に入っていれば答えは作れます。
渡す件数を絞る理由の一つが、料金です。検索結果はそのままLLMの入力トークンになるため、件数が従量課金に直結します。
仮に、1チャンクを1,000トークン、入力の単価を1,000トークンあたり0.001ドルとして計算してみます。チャンクの大きさはKnowledge Baseなどで設定でき、単価はモデルによって大きく変わるため、ここでは計算しやすい値を置いています。
| LLMへ渡す件数 | 入力トークン | 1質問あたり | 月1万クエリ |
|---|---|---|---|
| 5件 | 5,000 | 0.005ドル | 50ドル |
| 20件 | 20,000 | 0.02ドル | 200ドル |
件数を4倍にすれば、入力の料金もそのまま4倍になります。1回あたりでは小さな額でも、問い合わせが積み上がる用途では差が効いてきます。
リランキングもモデルを呼ぶ処理です。それなら料金は変わらないはずですが、課金の単位が違います。リランカーは回答を生成せず、質問と文書の関連度を返すだけで、料金は処理したトークン量ではなく呼び出し回数で決まります。20件を渡しても、1回の呼び出しとして数えられます。
Bedrockのリランカーの料金は1,000クエリあたり1ドルから2ドル、つまり1質問あたり0.001ドルから0.002ドルです(内訳は後述します)。上の表にある20件分の0.02ドルと比べると、1桁小さい額です。20件をそのまま渡す代わりに、リランキングを挟んで5件へ絞れば、1質問あたり0.006ドルから0.007ドルに収まります。
渡す件数を絞るという前提がある以上、その少数枠に何を入れるかという、順位の問題が残ります。
並べ直しの手段は、専用モデルだけではありません。汎用のLLMに順位付けをさせる方法や、更新日などの業務ルールを順位に反映させる方法もあります。
| 方法 | 何を根拠に並べ直すか | 代表的な手法・モデル | 主な用途 |
|---|---|---|---|
| 専用モデル(今回の検証対象) | 質問と文書のペアを入力し、関連度スコアを算出する | Amazon Bedrock Rerank API(Amazon Rerank 1.0、Cohere Rerank 3.5) | 特定の業務条件がなく、関連度そのものを底上げしたい場合 |
| 汎用LLM | 候補文書をまとめて渡し、指示した基準で順位を付けさせる | Claude、Amazon NovaなどのLLMに、順位付けを指示するプロンプトを与える | 「最新の手順を優先」など、並べ替えの基準を言葉で書きたい場合 |
| ルール・重み付け | 更新日の新しさ、公式文書かどうか、在庫の有無などをスコアに反映する | 検索エンジンのスコア調整機能(OpenSearchのfunction_scoreなど)や、自前のスコア計算 | 業務要件が明確で、関連度以外の条件が順位を左右する場合 |
| 複数の検索順位の統合(RRFなど) | 別々の検索結果の順位そのものを足し合わせる | RRF(Reciprocal Rank Fusion)。Azure AI Searchのハイブリッド検索などが採用している | BM25によるキーワード検索とベクトル検索を併用する構成 |
最後の行だけは性質が異なります。順位統合は、複数の検索結果を1本のリストにまとめる処理であって、質問と文書の関連度を測り直しているわけではありません。狭い意味でのリランキングとは分けて考えたほうが整理しやすくなります。
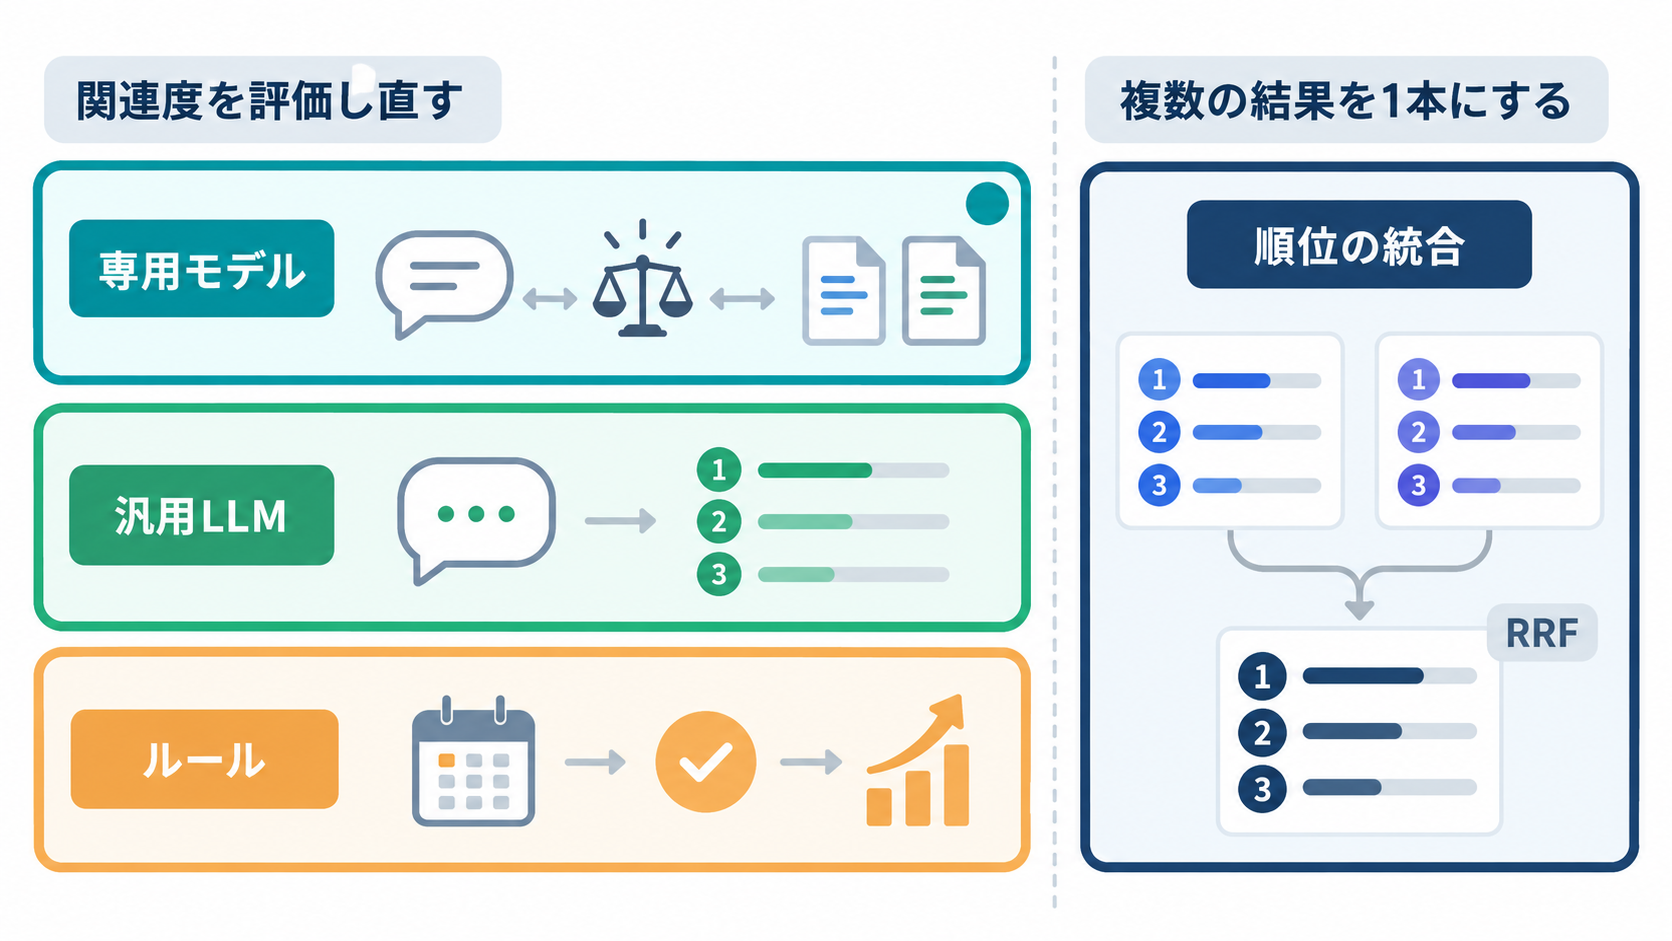
キーワード検索とベクトル検索を併用するハイブリッド構成では、統合の問題が避けられません。2つの検索はスコアの尺度がまったく違い、そのまま混ぜて並べられないためです。Azure AI Searchのドキュメントでも、フルテキスト検索のBM25スコアは上限なし、ベクトル検索のスコアはコサイン類似度で0.333から1.00と、別々の範囲で示されています(Hybrid search scoring (RRF))。
RRFはこの問題を、スコアの値を捨てて順位だけで足し合わせることで回避します。ただし「片方で3位、もう片方で7位」という位置の情報しか使わないため、その文書が実際にどれだけ質問に答えているかは見ていません。
リランカーは別の解き方をします。両方の検索結果をまとめて渡せば、由来に関係なく同じ基準で採点し直され、比較できる1本のスコアが付きます。実際、Azure AI Searchでもセマンティックランカーは、RRFで統合した後段に置かれる設計です。
この記事の検証はベクトル検索だけを使った構成なので、ハイブリッド構成でどれだけ差が出るかは測っていません。ただ、統合の基準をそろえられるという性質上、単一の検索にリランキングを足す場合より効きやすい場面だと考えられます。
今回比較するのは、このうち専用モデルによる関連度の再評価だけです。Amazon Bedrockでは、Rerank APIを直接呼ぶ方法と、Knowledge BasesのRetrieve/RetrieveAndGenerateから使う方法があります(公式ドキュメント)。
Amazon Bedrock provides access to reranker models that you can use when querying to improve the relevance of the retrieved results. A reranker model calculates the relevance of chunks to a query and reorders the results based on the scores that it calculates.
つまり、リランカーモデルは質問に対する各チャンクの関連度を計算し、そのスコアにもとづいて検索結果を並べ替える、という説明です。
利用できるモデルは、Amazon Rerank 1.0(amazon.rerank-v1:0)とCohere Rerank 3.5(cohere.rerank-v3-5:0)の2つです。対応リージョンは限られており、Amazon Rerank 1.0がap-northeast-1・ca-central-1・eu-central-1・us-west-2、Cohere Rerank 3.5はこれにus-east-1が加わります(2026年9月17日確認、Supported Regions and models for reranking)。
リランキングの効果だけを取り出すため、検索の部分は自作のベクトル検索にそろえました。Knowledge Baseを使うとチャンク分割や検索スコアの詳細が見えにくくなり、どこが効いたのか切り分けにくくなるためです。Knowledge Baseを使った構築そのものは、下記の記事で扱っています。
検索対象には、自社ブログ Tech Fun Magazineの過去記事81本を使いました。各記事を##見出し単位で分割し、コードブロック・画像・内部リンクのショートコードを除いたうえで、200文字未満のセクションを捨てて636チャンクにしています。1チャンクは平均860文字、トークン数では平均628、最大1,517でした。
質問は30問です。636チャンクのうち30件を別々の記事から正解チャンクとして選び、その内容を読んだうえで、本文の言い回しをそのまま使わない自然な質問文を作りました。たとえば「S3 Vectors の制限仕様を確認する」というチャンクに対しては、「S3 Vectorsで、絞り込み条件に使える付加情報の容量上限はどれくらいですか」という形です。
正解は各質問につき1チャンクだけとしました。実際には同じ記事の別の節も答えの一部になり得ますが、その場合も不正解として数えています。この扱いはリランキングの有無にかかわらず同じです。
候補件数N=20と採用件数K=5は、どの条件でもそろえています。
| 条件 | 上位5件の作り方 |
|---|---|
| リランキングなし | ベクトル検索で取得した20件のうち、そのまま上位5件 |
| Amazon Rerank 1.0 | 同じ20件をリランキングした後の上位5件 |
| Cohere Rerank 3.5 | 同じ20件をリランキングした後の上位5件 |
1つの質問につきベクトル検索は1回だけ実行し、その結果を3条件に渡しています。候補の中身の違いが結果に混ざることはありません。
埋め込みモデルはAmazon Titan Text Embeddings V2(1,024次元、正規化あり)、リージョンはap-northeast-1です。精度の集計と応答時間の測定を兼ねて、30問すべてを3ラウンド繰り返しました。
評価には、正解チャンクが上位5件に入った割合(Hit@5)、順位の逆数を平均したMRR@5、上位5件に入った場合の平均順位を使います。指標の定義は下記の記事で整理しています。
検索とリランキングの中核は次の3つの関数です。Rerank APIはbedrock-agent-runtimeクライアントから呼び出します。
"""ベクトル検索と Amazon Bedrock Rerank API による並べ替え"""

import json
import os

import boto3
import numpy as np
from dotenv import load_dotenv

load_dotenv()

REGION = os.environ.get("AWS_REGION", "ap-northeast-1")
EMBED_MODEL = "amazon.titan-embed-text-v2:0"

runtime = boto3.client("bedrock-runtime", region_name=REGION)
agent_runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)


def embed(text: str) -> np.ndarray:
    """テキストを1,024次元の正規化済みベクトルに変換する"""
    response = runtime.invoke_model(
        modelId=EMBED_MODEL,
        body=json.dumps({"inputText": text, "dimensions": 1024, "normalize": True}),
    )
    embedding = json.loads(response["body"].read())["embedding"]
    return np.array(embedding, dtype=np.float32)


def vector_search(query: str, vectors: np.ndarray, n: int) -> list[int]:
    """質問とのコサイン類似度が高い上位N件の文書インデックスを返す"""
    scores = vectors @ embed(query)
    return np.argsort(-scores)[:n].tolist()


def rerank(query: str, texts: list[str], k: int, model_id: str) -> list[int]:
    """候補テキストをリランキングし、上位K件が候補内の何番目かを返す"""
    response = agent_runtime.rerank(
        queries=[{"type": "TEXT", "textQuery": {"text": query}}],
        sources=[
            {
                "type": "INLINE",
                "inlineDocumentSource": {"type": "TEXT", "textDocument": {"text": t}},
            }
            for t in texts
        ],
        rerankingConfiguration={
            "type": "BEDROCK_RERANKING_MODEL",
            "bedrockRerankingConfiguration": {
                "numberOfResults": k,
                "modelConfiguration": {
                    "modelArn": f"arn:aws:bedrock:{REGION}::foundation-model/{model_id}"
                },
            },
        },
    )
    return [result["index"] for result in response["results"]]
rerankが返すのは文書そのものではなく、渡した候補リストの中での位置(インデックス)です。呼び出し側で元の候補リストと突き合わせて、どの文書が選ばれたかを復元します。
文書側の埋め込みは、検索のたびに作り直さず一度だけ生成してファイルに保存します。
"""文書チャンクの埋め込みを作成し、data/embeddings.npy に保存する"""

import json
import pathlib

import numpy as np

from rerank_search import embed

DATA = pathlib.Path(__file__).parent / "data"

documents = json.loads((DATA / "documents.json").read_text(encoding="utf-8"))
vectors = []
for i, document in enumerate(documents, start=1):
    vectors.append(embed(document["text"]))
    if i % 100 == 0:
        print(f"{i}/{len(documents)}")

np.save(DATA / "embeddings.npy", np.vstack(vectors))
print(f"saved: {len(documents)} vectors")
比較本体は次のスクリプトです。ベクトル検索の所要時間とリランキングの所要時間を別々に測り、正解チャンクが上位5件の何番目に来たかを記録します。
"""リランキングなし/あり(2モデル)で検索精度と応答時間を比較する"""

import json
import pathlib
import time

import numpy as np

from rerank_search import rerank, vector_search

DATA = pathlib.Path(__file__).parent / "data"
N, K, ROUNDS = 20, 5, 3
CONDITIONS = [
    ("none", None),
    ("amazon", "amazon.rerank-v1:0"),
    ("cohere", "cohere.rerank-v3-5:0"),
]

documents = json.loads((DATA / "documents.json").read_text(encoding="utf-8"))
questions = json.loads((DATA / "questions.json").read_text(encoding="utf-8"))
vectors = np.load(DATA / "embeddings.npy")

records = []
for round_no in range(1, ROUNDS + 1):
    for question in questions:
        started = time.perf_counter()
        candidates = vector_search(question["question"], vectors, N)
        search_ms = (time.perf_counter() - started) * 1000

        for condition, model_id in CONDITIONS:
            started = time.perf_counter()
            if model_id is None:
                top_k = candidates[:K]
            else:
                order = rerank(
                    question["question"],
                    [documents[i]["text"] for i in candidates],
                    K,
                    model_id,
                )
                top_k = [candidates[i] for i in order]
            rerank_ms = (time.perf_counter() - started) * 1000

            gold_ids = [documents[i]["id"] for i in top_k]
            rank = gold_ids.index(question["gold_id"]) + 1 if question["gold_id"] in gold_ids else None
            records.append({
                "round": round_no,
                "qid": question["qid"],
                "condition": condition,
                "rank": rank,
                "search_ms": round(search_ms, 1),
                "rerank_ms": round(rerank_ms, 1),
                "top_k_ids": gold_ids,
            })
        print(f"round {round_no} {question['qid']} done")

(DATA / "results.json").write_text(
    json.dumps(records, ensure_ascii=False, indent=2), encoding="utf-8"
)
print(f"saved: {len(records)} records")
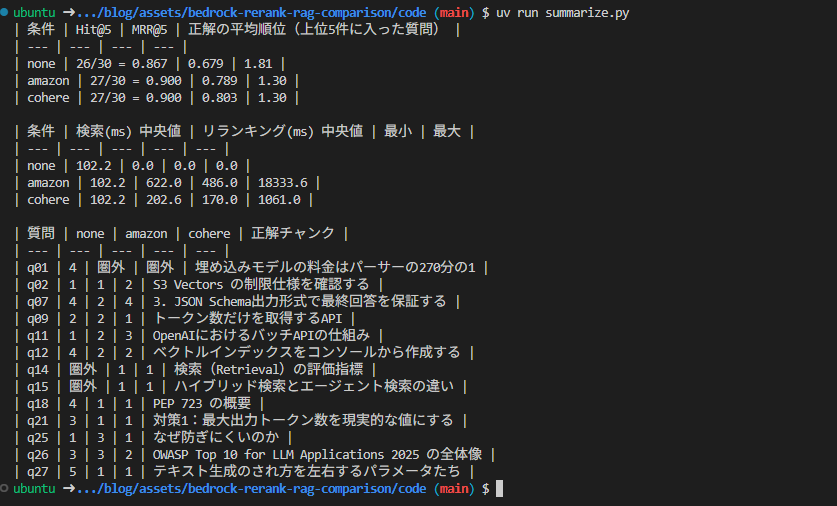
30問の結果は次のとおりです。3ラウンド繰り返しましたが、どの質問も順位は1度も変わりませんでした。表は30問を分母にしています。
| 条件 | Hit@5 | MRR@5 | 上位5件に入った場合の平均順位 | 正解が1位だった質問 |
|---|---|---|---|---|
| リランキングなし | 0.867(26/30) | 0.679 | 1.81 | 18問 |
| Amazon Rerank 1.0 | 0.900(27/30) | 0.789 | 1.30 | 21問 |
| Cohere Rerank 3.5 | 0.900(27/30) | 0.803 | 1.30 | 22問 |
Hit@5は26問から27問になっただけです。「上位5件に入るかどうか」という粗い基準で見ると、この検証での改善幅はわずかでした。
変化がはっきり出たのは順位のほうです。正解が1位に来た質問は18問から21問(Amazon)・22問(Cohere)へ増え、上位5件に入ったときの平均順位は1.81位から1.30位へ上がりました。LLMへ渡す件数を絞る設計や、引用元を1件だけ提示する設計では、この差が効いてきます。
検索本体(クエリの埋め込み生成とコサイン類似度計算)とリランキングを分けて測ると、次のようになりました。30問を3ラウンド繰り返しているため、検索が90回、リランキングが各モデル90回ずつの測定です。
| 処理 | 中央値 | p90 | 最小 | 最大 | 1秒を超えた回数 |
|---|---|---|---|---|---|
| 検索(クエリ埋め込み+類似度計算) | 102.2ms | 131.1ms | 60.1ms | 389.3ms | 0/90 |
| Amazon Rerank 1.0(追加分) | 622.0ms | 898.5ms | 486.0ms | 18,333.6ms | 8/90 |
| Cohere Rerank 3.5(追加分) | 202.6ms | 264.3ms | 170.0ms | 1,061.0ms | 1/90 |
検索そのものは102msで終わるのに対し、リランキングは中央値で203msから622msかかります。検索工程の所要時間は、Cohereで約3.0倍、Amazonで約7.1倍になる計算です。
注意したいのはAmazon Rerank 1.0のばらつきです。中央値はラウンド1から3で677.3ms・618.3ms・612.0msとほぼ一定でしたが、1秒を超えた回数は4回・4回・0回で、最大は18.3秒でした。ラウンドが進むにつれ外れ値は減ったものの、単純なウォームアップでは説明しきれません。原因は特定できていません。Cohere Rerank 3.5でも、1秒をわずかに超えた回が1度ありました。ユーザーの入力から回答までの時間を保証したい用途では、この裾の長さを見込んだ設計が必要です。
先に触れたとおり、リランキングの料金はクエリ数で決まります。
Reranking is priced per query. A query is a single call to the reranker model that can contain up to 100 document chunks.
つまり、課金の単位は呼び出し1回です。1回の呼び出しには文書チャンクを100件まで含められます。
ap-northeast-1での単価は、リランキングが1,000クエリあたり1ドル(Amazon Rerank 1.0)から2ドル(Cohere Rerank 3.5)です(2026年9月17日時点)。最新の値はAmazon Bedrock料金ページで確認してください。
なお、Cohere Rerank 3.5の料金表には、渡した文書の長さによってクエリ数の数え方が変わるという注記があります。
You are charged for number of queries where a query can contain up to 100 document chunks. If the query contains more than 100 document chunks, it is counted as multiple queries. For example, if a request contains 350 documents, it will be treated as 4 queries. Please note that each document can only contain upto 500 tokens (inclusive of the query and document's total tokens), and if the token length is higher than 512 tokens, it is broken down into multiple documents.
つまり、1回に渡せる文書は100件までで、それを超えると複数クエリとして数えられます。350件を渡せば4クエリ分です。さらに1文書あたりのトークン数にも上限があり、512トークンを超えると内部で複数の文書へ分割されます。長いチャンクを渡すほど、100件の枠を早く使い切る計算になります。
検証に使ったチャンクは平均628トークンのため、分割後も20件の候補が40件程度に収まり、1回の呼び出しは1クエリとして扱われる想定です。ただし、長いチャンクを大量に渡す設計では、この分割によってクエリ数が跳ね上がる可能性があります。
集計の裏側で何が起きていたかを見ると、リランキングが得意な場面と苦手な場面が分かれました。
改善が最も大きかった質問と、逆に悪化した質問について、上位5件の中身を並べたのが次の出力です。
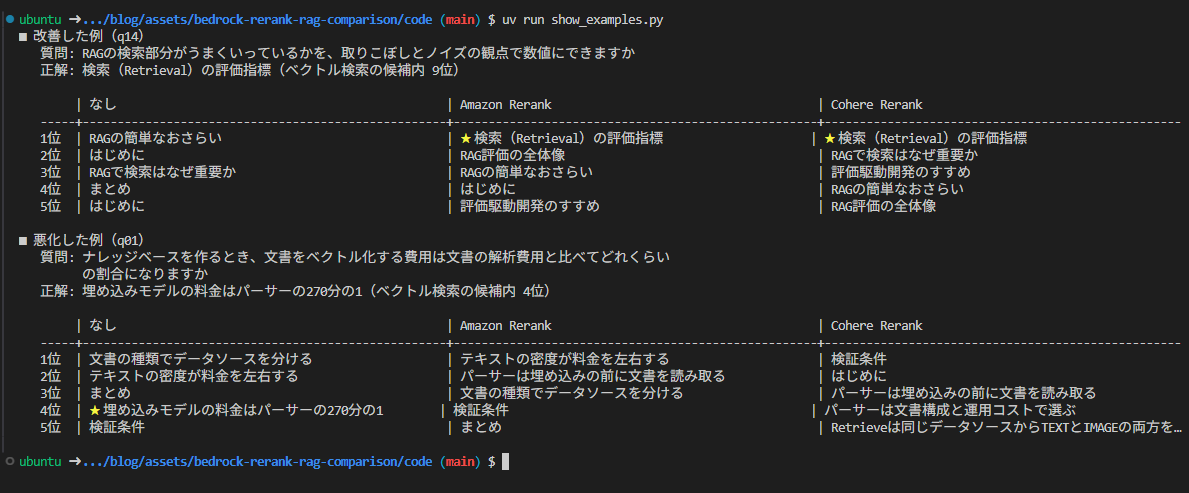
改善が最も大きかったのは、記事全体の話題は合っているのに、その記事の「はじめに」や「まとめ」が上位を占めてしまっていた質問です。ベクトル検索では上位5件のうち3件を同じ記事の導入・総括部分が占め、正解の「検索(Retrieval)の評価指標」は9位に沈んでいました。両リランカーともこれを1位へ引き上げています。
一方、悪化した例では、ベクトル検索で4位だった正解チャンク「埋め込みモデルの料金はパーサーの270分の1」が、両リランカーとも上位5件から外れました。代わりに上位へ来たのは「テキストの密度が料金を左右する」など、同じ記事で料金を扱う別の節です。質問が求めていた「比率」という限定条件よりも、話題の一致が優先されたように見えます。
「まず押さえたい結論」のような総括のチャンクが、リランキング後にかえって上位へ来た質問もありました。導入や総括にあたるチャンクは、質問文全体と広く一致しやすい可能性があります。ただし、この傾向を確かめるには、そうしたチャンクを意図的に含めた別の検証が必要です。
30問のうち、候補20件に正解チャンクが含まれていたのは28問でした。残る2問は、正解が636件中118位と115位で、そもそも並べ直しの対象に入っていません。リランキングは候補の中での順位を変える処理なので、この2問はどのモデルを使っても改善しません。
逆に言えば、リランキングが取り戻せるのは「候補には入っているが上位K件に残っていない」ぶんだけです。今回はそれが2問あり、両リランカーとも2問とも1位まで引き上げました。ただし別の1問を新たに落としたため、Hit@5としては差し引き1問の改善にとどまっています。
検索の再現率が足りていない場合は、リランキングより先に、候補件数Nを増やす、チャンク分割を見直す、キーワード検索を併用するといった検索側の設計を検討することになります。
追加の負担は、検証した条件では次のように整理できます。
費用よりも、応答時間と外れ値のほうが判断材料になりやすい結果でした。社内の問い合わせ検索のように数百ms程度の増加が許容できる用途なら、費用は導入の障害になりにくいと考えられます。一方、対話のたびに検索が走る構成や、応答時間の上限が決まっている構成では、裾の長さを実測してから判断する必要があります。
1つは、元の検索がどれだけ取りこぼしているかです。リランキングが取り戻せるのは、ベクトル検索が上位K件から落としたぶんだけで、すでに正解が上位に入っている質問には伸びしろがありません。今回のコーパスでは、ベクトル検索だけで30問中26問が上位5件に入っており、そもそも改善の余地が限られていました。検索の精度が低い環境ほど、リランキングの効果は大きく出るはずです。
もう1つは、検索を複数走らせているかどうかです。キーワード検索とベクトル検索を併用している構成では、スコアの尺度が違う2つの結果をどこかで1本にまとめる必要があります。RRFで順位だけを足し合わせるか、リランカーで候補をまとめて採点し直すかという選択になり、後者を選べば統合と並べ替えを同時に片づけられます。単一の検索に後から足す場合より、リランキングが担う役割は大きくなります。
なお、この記事の改善幅をそのまま自社の環境へ当てはめることはできません。文書の種類、埋め込みモデル、NとKの設定が変われば、結果も変わります。手元のデータと質問で同じ形の比較を1度回せば、判断できるだけの材料は得られます。今回の規模なら実行時間は5分程度でした。
「リランキングを追加すると検索精度はどの程度改善し、追加の応答時間・コストに見合うのか」という問いに、今回の検証結果の範囲で答えます。
上位5件に正解が入るかどうかという基準では、30問中26問から27問への改善にとどまりました。一方、正解が1位に来る割合は60.0%から70.0%(Amazon Rerank 1.0)・73.3%(Cohere Rerank 3.5)へ、上位5件に入った場合の平均順位は1.81位から1.30位へ改善しています。「候補には入るが上位に出ない」という課題には効きますが、「そもそも候補に入らない」問題は解決しません。
追加の負担は、応答時間が中央値で203ms(Cohere)または622ms(Amazon)、費用が1,000クエリあたり2ドルまたは1ドルです。費用は小さく、判断の軸になるのは応答時間のほうでした。とくにAmazon Rerank 1.0では90回中8回が1秒を超え、最大18.3秒の外れ値が出ています。
2モデルの比較では、精度はほぼ同等(MRR@5で0.789と0.803)、応答時間はCohere Rerank 3.5が約3分の1、料金はCohere Rerank 3.5がAmazon Rerank 1.0の2倍でした。この条件では、どちらか一方が明確に優れているとは言えません。
導入を検討する際は、先に候補段階の再現率を測ることをおすすめします。候補N件に正解が入っていない質問が多いなら、リランキングより検索側の設計を見直すほうが効果的です。候補には入っているのに上位に出ない質問が目立つなら、今回のような小規模な比較を1度回してから判断できます。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。