生成AI関連
MCPサーバーを活用する【前編:自作編】
OpenAI Agents APIは、AIエージェントの実行と状態管理をOpenAIに任せられるAPIです。導入を検討する際は、何を任せられ、何を自社で設計するのかを分けて考える必要があります。
実行基盤を任せても、業務上の権限、品質評価、コスト管理は自社に残ります。本記事では、この分担をセッション、復旧、実行環境、権限、監視・評価の5つから整理します。Responses APIとの違い、Pythonのコード例、Amazon Bedrock AgentCoreとの比較も扱います。
対象は、APIやツールを使うAIエージェントの導入を検討している開発者です。仕様は2026年9月16日に公式資料で確認しました。掲載する実行結果は既存のスクリーンショットに基づき、本番の安定性や障害復旧を検証したものではありません。
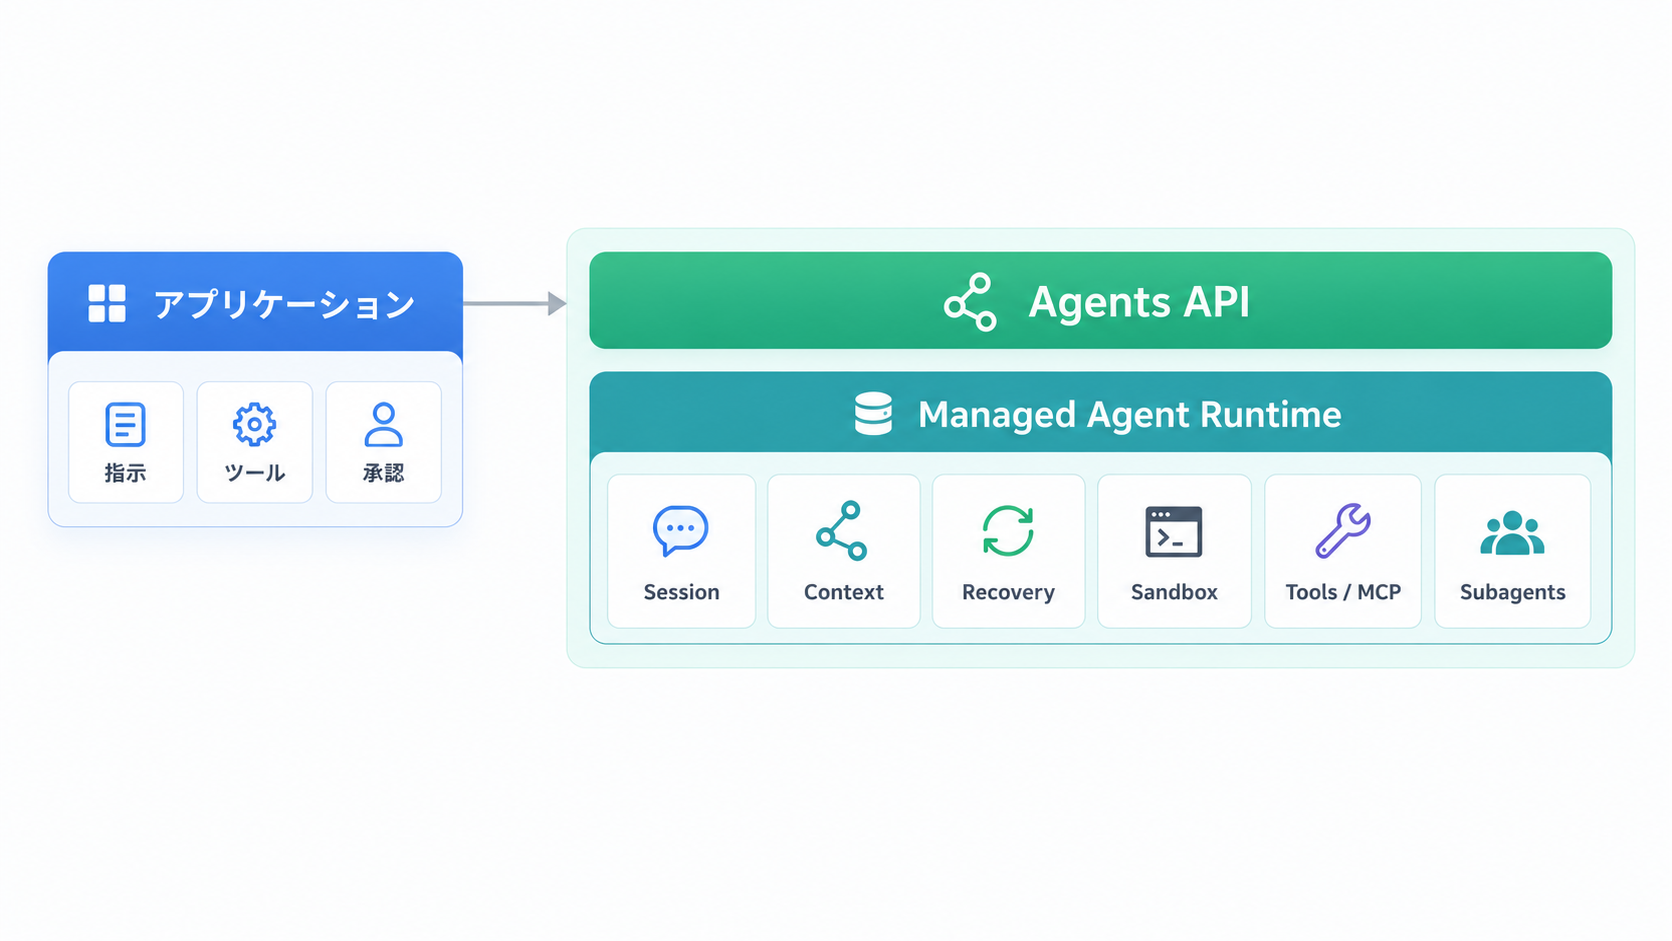
OpenAIは2026年9月10日、Agents APIをPublic Betaとして公開しました。モデル呼び出しとツール実行を繰り返す仕組みであるCodexのharnessを、API経由で利用できます。セッションの管理、会話や作業の履歴(コンテキスト)の圧縮、作業の継続を支える機能をOpenAIが提供します。OpenAI Changelog
エージェントを動かす土台はAgent Runtimeと呼ばれます。本記事では、Agents APIの特徴を「この実行基盤の管理をOpenAIに任せられること」と捉えます。
基本となる概念は次の4つです。Agents APIの概要
| 要素 | 役割 |
|---|---|
| Agent | モデル、指示、利用できるツールの定義 |
| Environment | コード実行やファイル操作を行う環境 |
| Session | 会話と作業を継続する単位 |
| Events / Items | 進行状況を伝えるイベントと、保存された入出力 |
アプリケーションはタスクを送り、イベントから進行状況や結果を受け取ります。外部ツールを接続するMCPや、作業手順を与えるSkillsも利用できます。それぞれの基礎は、次の記事で説明しています。
3つの選択肢は、エージェントの処理をどこで制御するかで整理できます。次の表は、OpenAIの選択ガイドを基にした比較です。Agentsの選択ガイド
| 選択肢 | 制御・管理の中心 | 選ぶ際の観点 |
|---|---|---|
| Responses API | モデル応答を直接扱う自社コード | 応答やツールを既存処理へ細かく組み込みたい |
| Agents SDK | 自社でホストするアプリケーション | エージェントループや処理の引き継ぎを制御したい |
| Agents API | OpenAIが管理するCodex harness | 実行基盤の管理を任せ、タスクとツールの統合に取り組みたい |
Responses APIにも、前の応答を引き継ぐ仕組みがあります。Conversations APIと組み合わせると、会話を継続して保存できます。「状態を持てるか」だけでは、両者の違いを説明できません。会話状態の管理
Agents APIでは、会話の保存に加えて、Codex harnessによる実行もサービス側に任せます。ただし、自社で実装する関数ツールは、呼び出しを受け取り、実行結果を返す処理が必要です。Agents APIの構成
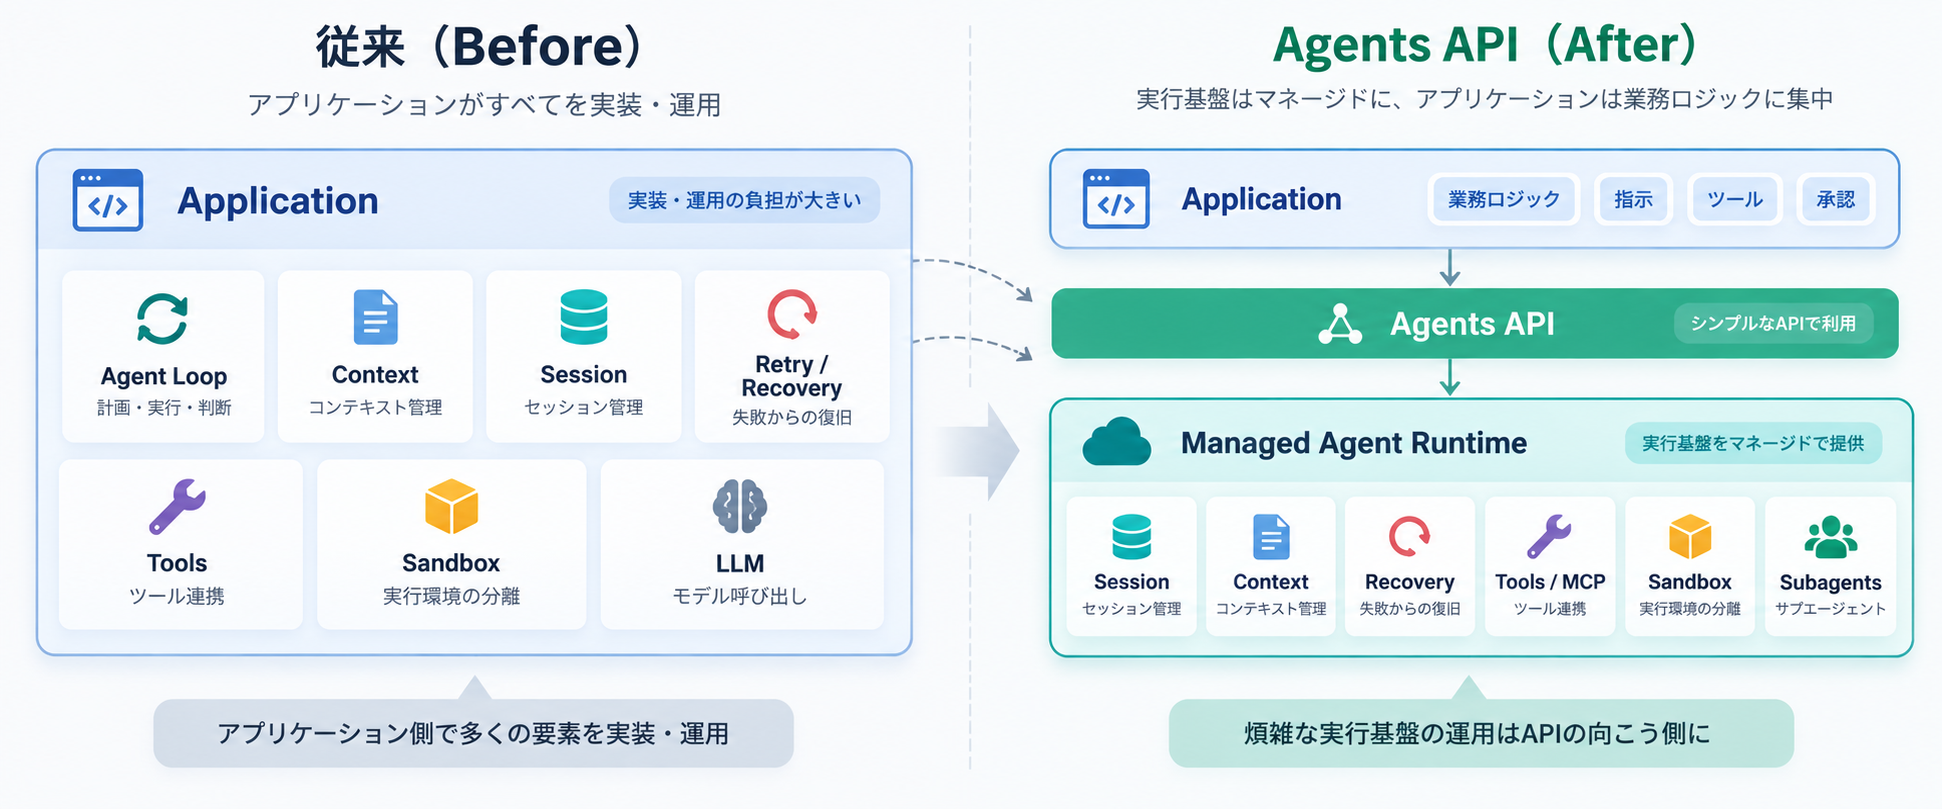
図の左側は自前で実行基盤を組む場合の例です。既存のAPIやSDKが提供する管理機能まで、すべて自作するという意味ではありません。右側もOpenAIホスト型sandboxを使う場合を中心に描いています。
Codexを自作クライアントへ組み込む方法としては、App Serverもあります。クライアントとの接続方法を知りたい場合は、次の記事が参考になります。
ここでは、隔離されたコード実行環境(sandbox)で、ファイル一覧を表示するスクリプトを作成させます。その後、別のコマンドから同じセッションの履歴を取得します。確認するのは、タスクの完了イベントと履歴取得の関係です。
掲載コードはPython 3.10以上、openai 3.14.0を前提としています。添付のcodeディレクトリで uv sync –locked を実行し、.env.example をコピーした .env にAPIキーを設定します。実行手順と画像の保存先は、添付READMEにまとめています。
uv run run_session.py を実行します。モデルの指定がなければ、コードは gpt-6-astra を使います。OpenAIホスト型の実行環境を指定し、進行イベントの要点だけを表示する例です。
"""Agents APIでセッションを1つ作成し、進行イベントの要点だけを表示します。"""
import os

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()

TASK = (
    "カレントディレクトリのファイル一覧をツリー表示する tree.py を作成し、"
    "実行して実際の出力を報告してください。"
)

with client.beta.agents.sessions.create(
    agent={
        "model": os.getenv("OPENAI_MODEL", "gpt-6-astra"),
        "instructions": "コードを書いたら必ず実行し、実際の出力を報告してください。",
    },
    environment={"type": "openai_hosted"},
    input=TASK,
    stream=True,
) as events:
    for event in events:
        if event.type == "agent.session.created":
            print(f"session_id: {event.session.id}")
        elif event.type == "agent.session.environment.ready":
            print("sandbox: ready")
        elif event.type == "agent.session.turn.item.done":
            item = event.item
            if item.type == "command_execution":
                print(f"$ {item.command} (exit={item.exit_code})")
            elif item.type == "message" and item.phase == "final_answer":
                print("".join(part.text for part in item.content))
        elif event.type in ("agent.session.turn.completed", "agent.session.turn.failed"):
            print(f"turn: {event.turn.status}")
このコードは、モデルとツールを交互に呼ぶループを実装していません。タスクを送った後は、セッションID、環境の準備、コマンド、最終回答、ターンの結果を受け取ります。
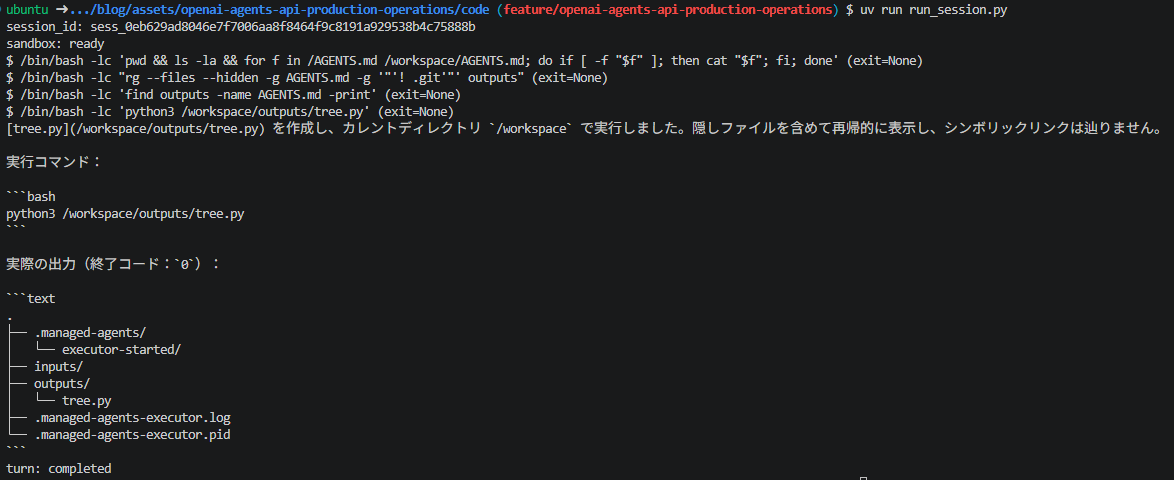
画像ではターンの完了を確認できます。一方、コマンド行の終了コードは None です。最終回答には終了コード0という記述がありますが、これはエージェントが生成した報告です。コマンド結果の独立した確認とは区別します。
次に、表示されたIDを使って uv run inspect_session.py <session_id> を実行します。コードはセッションの状態と、先頭100件までの履歴を取得します。
"""切断後でも session_id から状態と作業履歴を取り出せることを確認します。"""
import sys

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI()

session_id = sys.argv[1]

session = client.beta.agents.sessions.retrieve(session_id)
print(f"status: {session.status}")

items = client.beta.agents.sessions.items.list(session_id, order="asc", limit=100)
for item in items.data:
    if item.type == "command_execution":
        print(f"[command] {item.command} (exit={item.exit_code})")
    elif item.type == "message":
        text = "".join(getattr(part, "text", "") for part in item.content)
        print(f"[{item.role}] {text[:80]}")
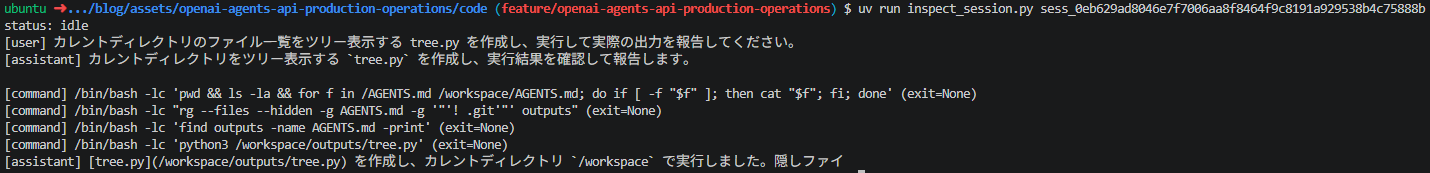
2枚の画像では、同じIDを指定した履歴取得が確認できます。ただし、通信を意図的に切断した試験や、失敗した処理の再開試験ではありません。実行日時、実際に選択されたモデル、繰り返し実行した際の成功率も、画像だけでは確認できません。
この例は正常系の流れを読むための最小構成です。履歴の全件取得、キャンセル時の処理、ストリーム切断時の再接続は含めていません。
概念実証(PoC)で1件のタスクが完了しても、運用要件を満たしたとは限りません。たとえば、外部APIへの書き込み直後に接続が切れた場合、再試行すると同じ変更を二重に行う恐れがあります。担当者が実行中の画面を見ていなくても成否を判断できるよう、状態と結果を記録します。
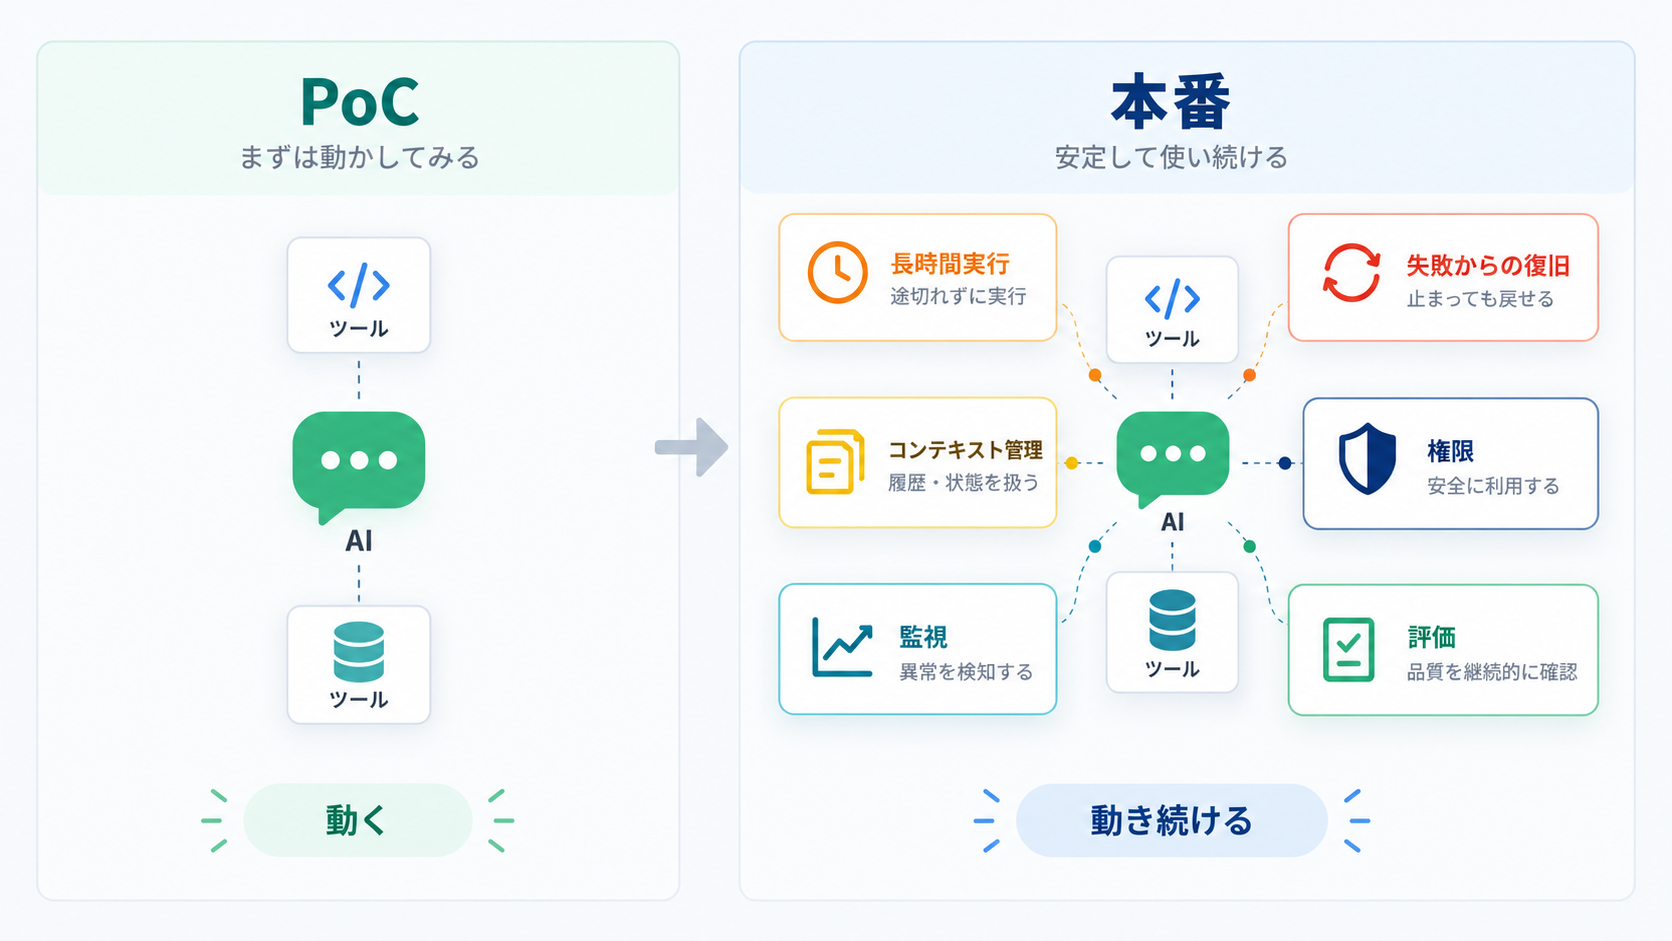
以下には、公式仕様に加え、業務システムへ組み込む際の設計上の考察を含みます。
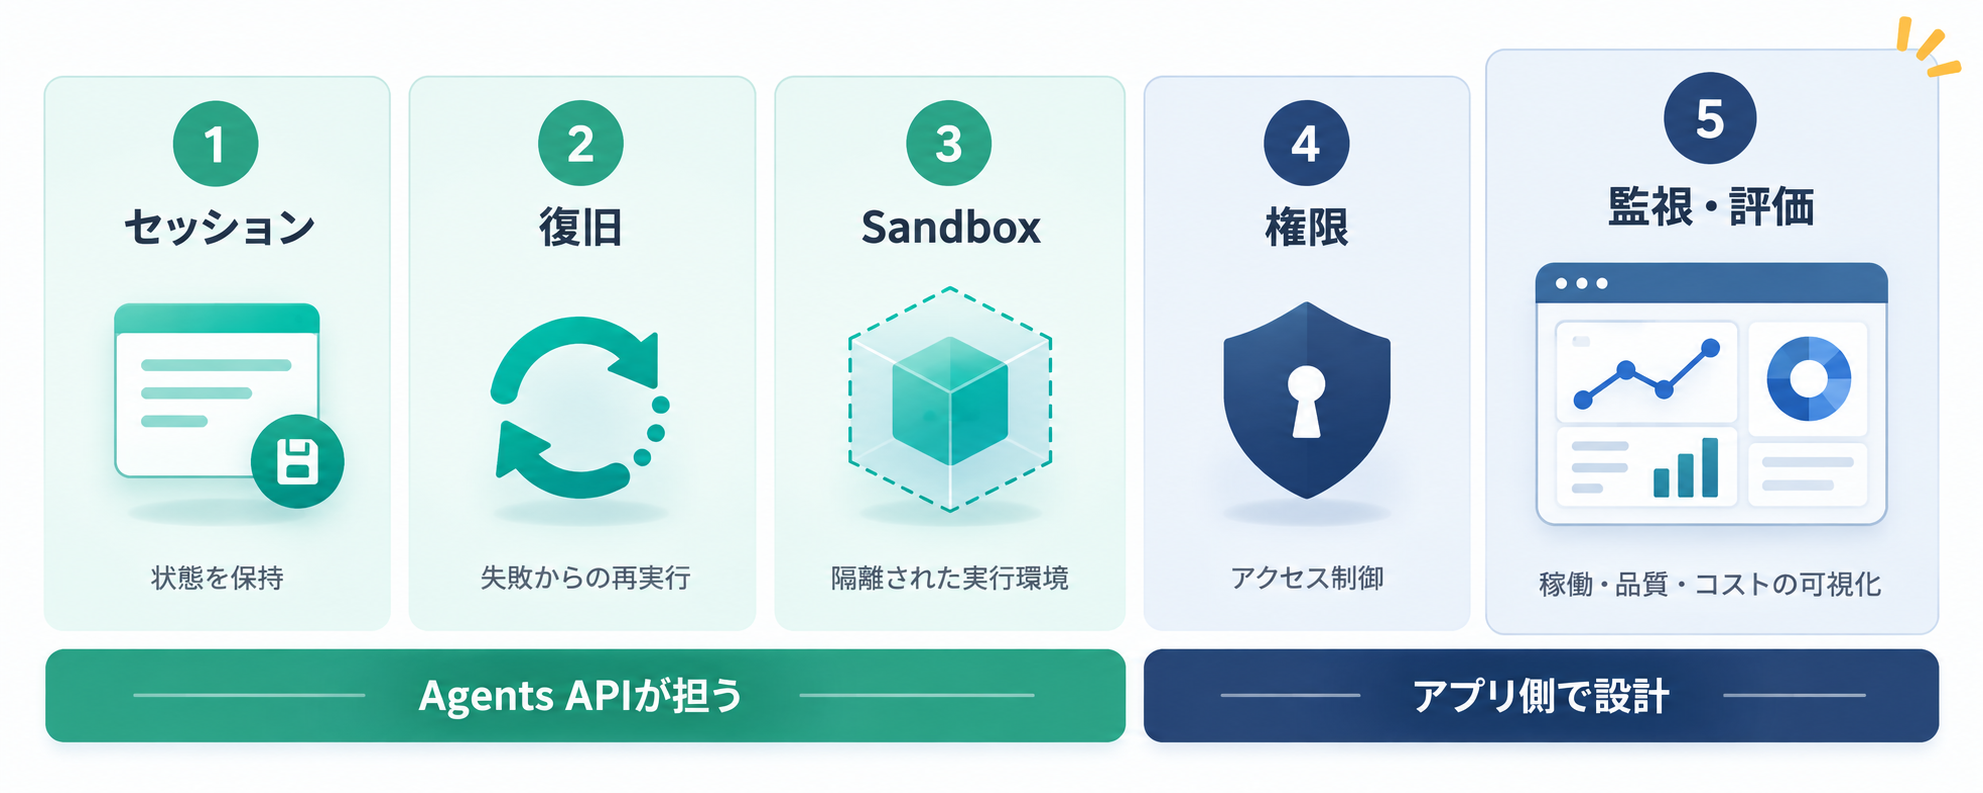
図は主な分担を示しています。セッションIDの管理、業務処理の再試行、self-hosted環境の保守など、左側の3項目にも自社の設計が残ります。
Sessionは、エージェントの設定、会話、保存された作業を保持します。その中で1回の作業サイクルを表すのがTurnです。同じセッションへの追加入力で、作業を続けられます。セッションの実行と継続
自社側では、利用者や業務の依頼とセッションIDを対応づけて保存します。運用時の調査に備え、問い合わせ番号から履歴を探せるか確認します。また、他の利用者のセッションを取得できないよう、アクセス制御も確認します。
セッションが idle でも、成功したとは限りません。公式資料は、ターンの完了・失敗・キャンセルと、実際の出力を確認するよう案内しています。完了したターンでも、すべてのツールが成功したとは限らないためです。結果の確認方法
業務処理の再試行では、何度実行しても変更が重複しない「冪等性」を設計します。たとえば、チケット作成前に業務の依頼IDを照合する方法が考えられます。再試行の上限、打ち切る時間、人へ引き継ぐ条件も決めておきます。
履歴の取得と、停止したプログラムの再開は別の機能です。self-hosted環境では、接続の復帰で終了済みコマンドが自動再実行されるわけではありません。交換した実行環境にファイルを戻すには、ストレージやスナップショットの設計が必要です。sandboxのライフサイクル
sandboxは、コード実行やファイル操作のための環境です。次の3つから選びます。実行環境の選択
| 設定 | 実行場所 | 自社で確認すること |
|---|---|---|
| none | 専用の実行環境を使わない | 関数ツールや外部サービスだけで処理できるか |
| openai_hosted | OpenAIが管理するsandbox | 必要なファイル、パッケージ、ネットワークアクセス |
| self_hosted | 自社または外部提供者の環境 | 起動、接続、停止、ファイル保持、環境の隔離 |
self_hostedでは、実行用プログラムであるexecutorを接続します。エージェントループはOpenAIが管理しますが、環境のライフサイクルは自社の担当です。社内ネットワークにつなぐ場合も、到達先と認証情報を業務に必要な範囲へ制限します。
データの参照と、更新・送信・削除では、必要な権限や承認が異なります。利用者として操作してよい対象かを、ツールや業務API側で確認する設計が必要です。
たとえば、問い合わせ内容の参照は自動で行い、顧客への送信前には担当者が宛先と本文を確認する流れです。承認後に内容が変わった場合の再承認や、承認待ちの期限も決めます。指示文に「許可を得る」と書くだけで、アクセス制御を代替しないことが要点です。
人が判断に入る設計をHuman-in-the-Loopと呼びます。ガードレールの考え方は、次の記事で整理しています。
HTTP通信が成功し、ターンが完了しても、依頼した仕事の結果が正しいとは限りません。監視では「何が起きたか」を追い、評価では「目的を満たしたか」を確認します。
Agents APIには、イベント、保存された履歴、トークン使用量を確認する手段があります。Platformの画面では、セッションのターン、ツール呼び出し、サブエージェントも調べられます。一方、Public BetaのAPIには、トレース取得と外部へのトレース出力機能は含まれていません。監視と使用量
そのため、自社で保存するイベントと、Platformの画面で調べる情報を決めておきます。外部の監視基盤へ転送できる情報の範囲も、事前に確認が必要です。
| 観点 | 確認する内容 |
|---|---|
| 完了 | 依頼された作業と成果物がそろったか |
| 正確性 | 回答や変更内容が正しいか |
| ツール選択 | 必要な操作を適切な対象に行ったか |
| 安全性 | 許可していない操作や情報の持ち出しがないか |
| コスト・時間 | 業務上の予算と所要時間に収まったか |
最終回答が正しくても、不要なツール呼び出しが多ければ、コストや所要時間の課題は残ります。回答と実行経路の両方を評価し、モデル、指示、ツールを変更するたびに同じ問題で確認します。
RAGの回答評価については、次の記事も参考になります。エージェントでは、回答の評価に加えて操作の妥当性を調べます。
モデル利用にはモデルごとのAPI料金、OpenAIのツールには各ツールの料金が適用されます。OpenAIホスト型sandboxにはコンテナ利用料もかかります。Agents APIの料金体系
運用では、1回の回答のトークン数に加え、複数ターンや再試行を含めた業務1件あたりの費用を測ります。サブエージェントを利用する場合は、その使用量も確認対象です。本記事のコード例では、費用や処理時間は計測していません。
予算を超えそうな場合に、誰へ通知し、どの条件で処理を停止するかも決めておきます。出力の反復とコスト管理については、次の記事で説明しています。
2026年9月16日時点で、Agents APIのデータレジデンシーは米国のみです。データを保持しないZero Data Retention(ZDR)にも対応していません。self-hosted環境を選んでも、Agents APIがZDRの対象になるわけではありません。データ保持に関する制約
実行環境をどこに置くかと、APIに送るデータをどこで扱うかは分けて確認します。導入候補の業務について、送信する情報と保存要件を先に整理すると、機能検証へ進めるかを判断できます。
Amazon Bedrock AgentCoreも、エージェントの構築・実行・運用を支えるサービス群です。AWSのリリースノートでは、2026年4月の項目にAgentCore HarnessのPublic Previewが記載されています。一般提供(GA)は同年6月の項目にあります。AgentCoreリリースノート
比較する際は、Agents APIという実行基盤と、AgentCoreのサービス群全体を同じ単位で評価しないようにします。次の表では、選定時に調査すべき領域を整理しています。
| 観点 | OpenAI Agents API | Amazon Bedrock AgentCore |
|---|---|---|
| 実行基盤 | Codex harnessをAPIとして提供 | RuntimeやマネージドなHarnessを提供 |
| 権限の設計 | 接続先ツールと自社アプリの制御を確認 | IdentityやPolicyを含めて確認 |
| 監視・評価 | イベント、使用量、Platform上の確認機能 | ObservabilityやEvaluationsを含めて確認 |
| 導入時の確認 | 対象モデル、環境、データ保持の制約 | 利用する機能ごとのモデル・リージョン対応 |
OpenAIの根拠は前述の構成・監視ガイド、AWSの根拠はリリースノートです。ここでは両サービスを同じ業務で動かした比較試験は行っていません。
選定時には、既存の認証・監視基盤へどう組み込むかを確認します。サービスの有無だけでなく、自社が設定し、保守する範囲を見積もることが必要です。
本記事では、エージェントの実行、監視、評価、権限、コスト、改善を継続して管理する取り組みをAgentOpsと呼びます。特定製品の名前ではなく、運用の考え方として使っています。
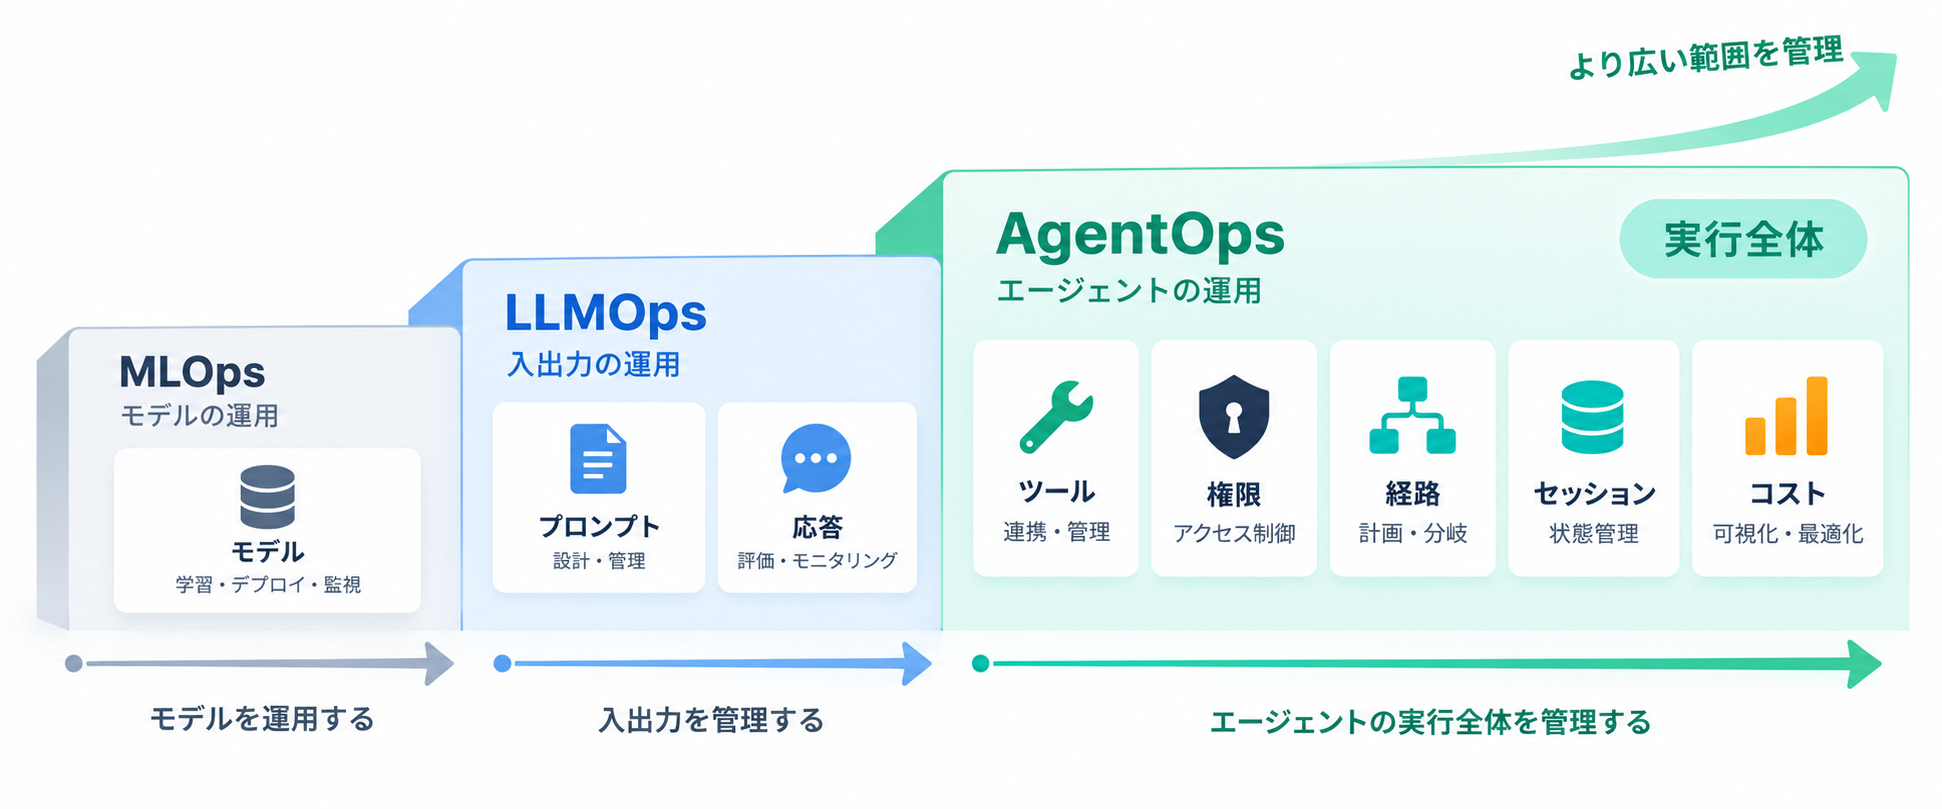
図は本記事で着目する範囲を簡略化したものです。MLOpsやLLMOpsでも権限・コストは扱うため、各領域が厳密に分かれているという意味ではありません。
| 管理対象 | 記録・確認すること |
|---|---|
| モデル・指示・Skills | 変更前後の内容と評価結果 |
| ツール・MCP・権限 | 利用可能な操作、アクセス範囲、承認条件 |
| 評価用の問題 | 業務の成功条件と、失敗しやすい事例 |
| 実行履歴・コスト | セッションと業務の依頼の対応、使用量、異常 |
たとえばツールを追加した際は、使えることの確認に加え、既存業務で不要な呼び出しが増えていないかを調べます。問題があれば以前の構成へ戻せるよう、指示とツール設定も版管理します。
Skillsや接続設定をまとめるプラグインも、変更の管理対象になります。プラグインの構成と利用例は、次の記事で扱っています。
最後に、自社で確認すべき項目をまとめます。各項目について、担当者、確認方法、結果を残すと、未確認のまま運用へ進むことを防げます。
まずは読み取り中心の業務で、通常の完了、ツールの失敗、通信の切断をそれぞれ試す方法が考えられます。本記事の実行画像で確認できるのは完了表示と履歴取得までなので、残る条件は導入先の環境で検証してください。
OpenAI Agents APIは、Codex harnessによるエージェントの実行と状態管理をサービスとして提供します。導入の判断では、セッション、復旧、実行環境、権限、監視・評価の5つに分けて、任せる範囲を確認することが有効です。
既存の実行画像では、ターンの完了と、同じセッションの履歴取得を確認できました。一方、障害からの再開、業務結果の正確性、費用は別途検証が必要です。候補業務を1つ選び、チェックリストに沿って自社が担う設計と合格条件を決めるところから始めてください。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。