生成AI関連
RAGとは?外部情報を参照して回答する生成AIの仕組み
S3に蓄積した社内規程や業務マニュアルを、生成AIの回答に使いたい。その際に必要な文書の取り込みや検索基盤を、まとめてAWSに任せられるのがAmazon Bedrock Managed Knowledge Baseです。
従来のKnowledge BaseでもRAGの構築を効率化できましたが、ベクトルストアや埋め込みモデルなどの選択が必要でした。Managedではこれらに標準構成が用意され、既存のデータソースを接続するところから始められます。
本記事では、Managed Knowledge Baseと従来構成(Customer-managed)の違いや料金を整理し、S3上の文書を使った構築手順を紹介します。
なお、RAGの基本的な仕組みや、生成AIの回答に社内文書を活用する方法は、次の記事で解説しています。
従来のKnowledge BaseとS3 Vectorsを組み合わせた構築手順は、次の記事で紹介しています。
RAGは、質問に関係する文書を検索し、その内容を大規模言語モデル(LLM)へ渡して回答を生成する仕組みです。検索の前には、文書の読み取り、検索単位への分割、意味を数値で表す埋め込みの生成、保存が必要になります。
Managed Knowledge Baseは、この取り込みから検索までの基盤をAWSが管理するサービスです。2026年6月17日に一般提供が始まり、発表時点で東京リージョンも対象に含まれています。
標準構成では、文書解析や埋め込みに加え、ベクトルストアの管理や検索結果の並べ直しもAWSが担当します。利用者は、接続するデータソースと取り込む文書の範囲、アクセス権限、回答生成に使うモデルを設定します。
例えばS3を指定すると、その中の文書を読み取り、検索可能な状態へ変換します。元のS3ファイルを質問のたびに直接読む構成とは異なり、最初に取り込み処理が必要です。文書を更新した場合も、同期して検索内容へ反映します。
S3以外にも、SharePoint、OneDrive、Google Drive、Confluence、Box、ServiceNowなどをデータソースとして接続できます。Webページを取り込むWeb Crawlerや、独自の連携に使うCustomコネクターも用意されています。対応する接続先は、公式の作成ガイドの「Supported data source connectors」に一覧で記載されています。
ベクトルストアは、文書から生成した埋め込みベクトルを保存し、検索に使う仕組みです。本記事では、ベクトルストアを利用者が選ぶ構成を、公式ドキュメントの呼称に合わせてCustomer-managedと呼びます。
| 項目 | Managed | Customer-managed |
|---|---|---|
| ベクトルストアの選択 | Bedrockに任せる | S3 Vectors、OpenSearch Serverless、Auroraなどから選択 |
| ベクトルストアの構築・拡張 | Bedrockが管理 | 選択したベクトルストアに応じて設定・管理 |
| 埋め込みモデル | サービス管理のモデルが標準 | 利用者が選択 |
| 検索方式 | 通常検索はハイブリッド検索 | ベクトルストアに応じた検索方式を選択 |
| 主な用途 | 基盤の設定を減らしてデータを活用する | ベクトルストアや検索構成を細かく指定する |
上表は構成比較、対応ベクトルストア、Managedの検索仕様に基づきます。ハイブリッド検索は、意味の近さを使う検索と、キーワードを使う検索を組み合わせる方式です。
テキスト検索・ベクトル検索・ハイブリッド検索などの違いと使い分けは、次の記事で解説しています。
公式資料では、Managedが埋め込みベクトルだけでなく、テキスト・メタデータ・元ファイルも管理する保存基盤を「データストア」と表現しています。上表では、そのうちベクトルストアの選択・管理に関する違いを比較しています。
ManagedのベクトルストアがS3 VectorsかOpenSearchかは、今回確認した公式資料では特定できませんでした。利用者が指定するS3は元文書の置き場所です。S3をデータソースに選ぶことと、S3 Vectorsをベクトルストアに選ぶことは別です。
文書から内容を抽出するパーサーと、内容をベクトルへ変換する埋め込みモデルが標準で用意されています。また、検索した候補を質問との関連度で並べ直すリランキングにも、サービス管理のモデルを使えます。
標準のパーサーは、テキスト文書やPDFに加え、表や図を含む文書、画像、音声、動画にも対応しています。図は説明文として、音声・動画は文字起こしとして取り込まれます。図や画像、音声、動画を対象にする場合は、作成時の「高度な設定」で対象を有効にします。
標準構成を選べば、まず自分の文書を検索し、その結果を見ながら調整を進められます。ただし、文書形式や表現によって取り出せる内容は変わるため、標準設定だけで十分な精度が得られるかは別途確認します。
カスタムの埋め込みモデルも選べますが、その場合はManagedのリランカーを利用できません。また、作成後に埋め込みモデルの種別を切り替えるには、ナレッジベースの作り直しが必要です。
データソースとの連携では、文書の取り込みに加え、文書単位のアクセス権限を検索結果へ反映するACL対応の機能も利用できます。対応範囲はコネクターによって異なります。
ただし、利用者の本人確認までBedrockが行うわけではありません。アプリケーション側で認証した利用者の情報を渡す必要があります。S3では、検索用のACL情報を設定ファイルで用意します。S3バケットのアクセス設定だけでは、チャット利用者ごとの検索範囲は自動的に決まりません。
通常検索に加え、質問を小さな問いへ分解し、検索を繰り返すAgentic Retrievalも利用できます。複数の資料を参照しないと答えられない質問に対し、必要な情報を段階的に集める機能です。
基本料金は、保存する元データの容量と検索回数で決まります。2026年9月28日に確認した公式料金表の単価は次のとおりです。金額は米ドルです。
以下は、文書の取り込み・保存・検索にかかる料金です。通常検索とAgentic Retrievalのいずれの料金にも、検索結果から利用者向けの回答文を生成するモデルの料金は含まれません。
| 項目 | 料金 |
|---|---|
| インデックス保存 | 元データ1GBあたり月額5ドル |
| 通常検索(Retrieve API) | 1,000回あたり1ドル |
| Agentic Retrieval(標準の計画用モデル) | 1,000回あたり4ドル+内部で実行する通常検索の料金 |
| 標準パーサーによる文書解析 | 追加料金なし |
| 標準モデルによる埋め込み生成 | 追加料金なし |
| 標準リランカー | 追加料金なし |
保存料金の基準は、料金表に記載された「元データ容量」です。自分で作成したベクトルのサイズを使って、この表の保存料を計算するわけではありません。
Agentic Retrievalの「計画用モデル」は、質問に答えるために何を検索するかを判断するモデルです。その料金と、検索結果をもとに利用者向けの回答文を生成するモデルの料金は別です。
標準の文書解析・埋め込み生成・リランキングには、追加料金がかかりません。RAGとして回答文まで生成する場合は、保存・検索の料金に回答生成モデルの利用料を加えて見積もります。
埋め込み・リランキングやAgentic Retrievalの計画に独自のモデルを選ぶ場合は、選択したモデルの料金体系を確認します。AgentCore Gateway経由の呼び出しや、CloudWatchによる監視を使う場合も追加費用を確認します。
元文書を置くS3など、組み合わせるサービスの利用料も見積もりに含めます。従来構成と比較する際は、ベクトルストア単体の価格に加えて、文書解析・埋め込み・検索の費用と、設定や運用にかかる作業を比較します。
元データ1GBを1か月保存し、通常検索を月1万回実行する場合、保存・検索の小計は月額15ドルです。回答生成やS3などの料金を含まない、公開単価からの試算です。
| 内訳 | 計算 | 月額 |
|---|---|---|
| 保存 | 1GB × 5ドル | 5ドル |
| 通常検索 | 10,000回 ÷ 1,000 × 1ドル | 10ドル |
| 保存・検索の小計 | 回答生成・S3などの料金を除く | 15ドル |
同じ保存容量で、標準の計画用モデルによるAgentic Retrievalを月1万回使い、1回の呼び出しあたりの内部検索が平均2回なら、保存・検索の小計は月額65ドルです。内訳は保存5ドル、検索計画40ドル、内部検索20ドルで、こちらも回答生成やS3などの料金は含みません。
同じ質問数でも、内部検索の回数に応じて費用が増減します。
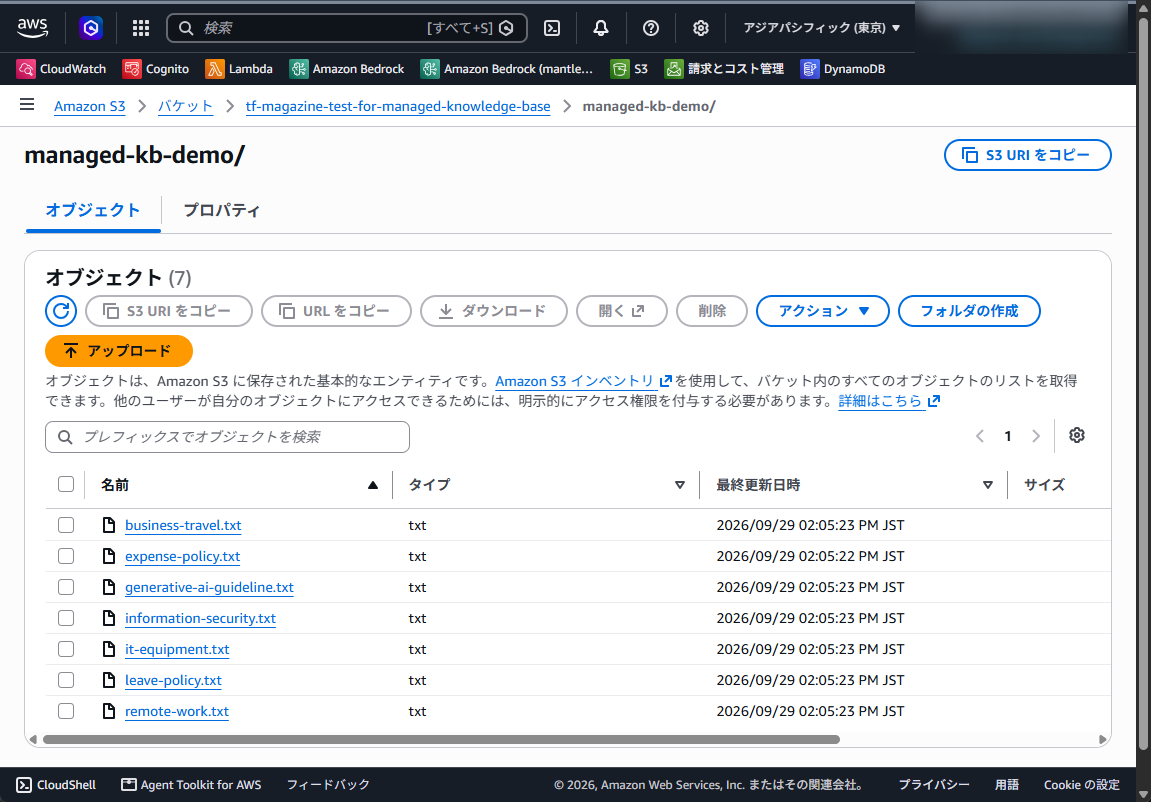
S3の汎用バケットに、社内規程が保管されている場面を想定します。デモでは、人事・経理・情報システム・セキュリティに関する架空の規程7件を作成して使います。
| 文書 | 記載内容 |
|---|---|
| remote-work.txt | 在宅勤務の対象者、利用日数、申請手続き、勤務場所 |
| expense-policy.txt | 立替経費の申請期限、承認、交際費と備品購入の上限 |
| business-travel.txt | 出張の申請、交通手段、宿泊費と日当、旅費の精算 |
| leave-policy.txt | 年次有給休暇の付与と取得、特別休暇 |
| it-equipment.txt | 貸与するIT機器、ソフトウェアの導入、紛失時の対応 |
| information-security.txt | 情報の区分、パスワード、持ち出し、インシデント報告 |
| generative-ai-guideline.txt | 利用できる生成AIサービス、入力してよい情報 |
S3上の配置例は s3://<利用するバケット名>/managed-kb-demo/ です。既存文書を使う場合は、文書に書かれた条件と回答を照合できる質問を用意してください。
以降は文書の配置が済んでいる状態から進めます。今回は東京リージョンを想定し、バケットとナレッジベースを同じAWSアカウント・同じリージョンに置きます。
ナレッジベースを作成する利用者には、ナレッジベースの作成権限に加え、サービスロールを渡すための iam:PassRole などの権限が必要です。サービスロールには対象のS3データを読み取る権限を付けます。カスタマー管理のKMSキーで暗号化している場合は、キー側の権限も確認します。
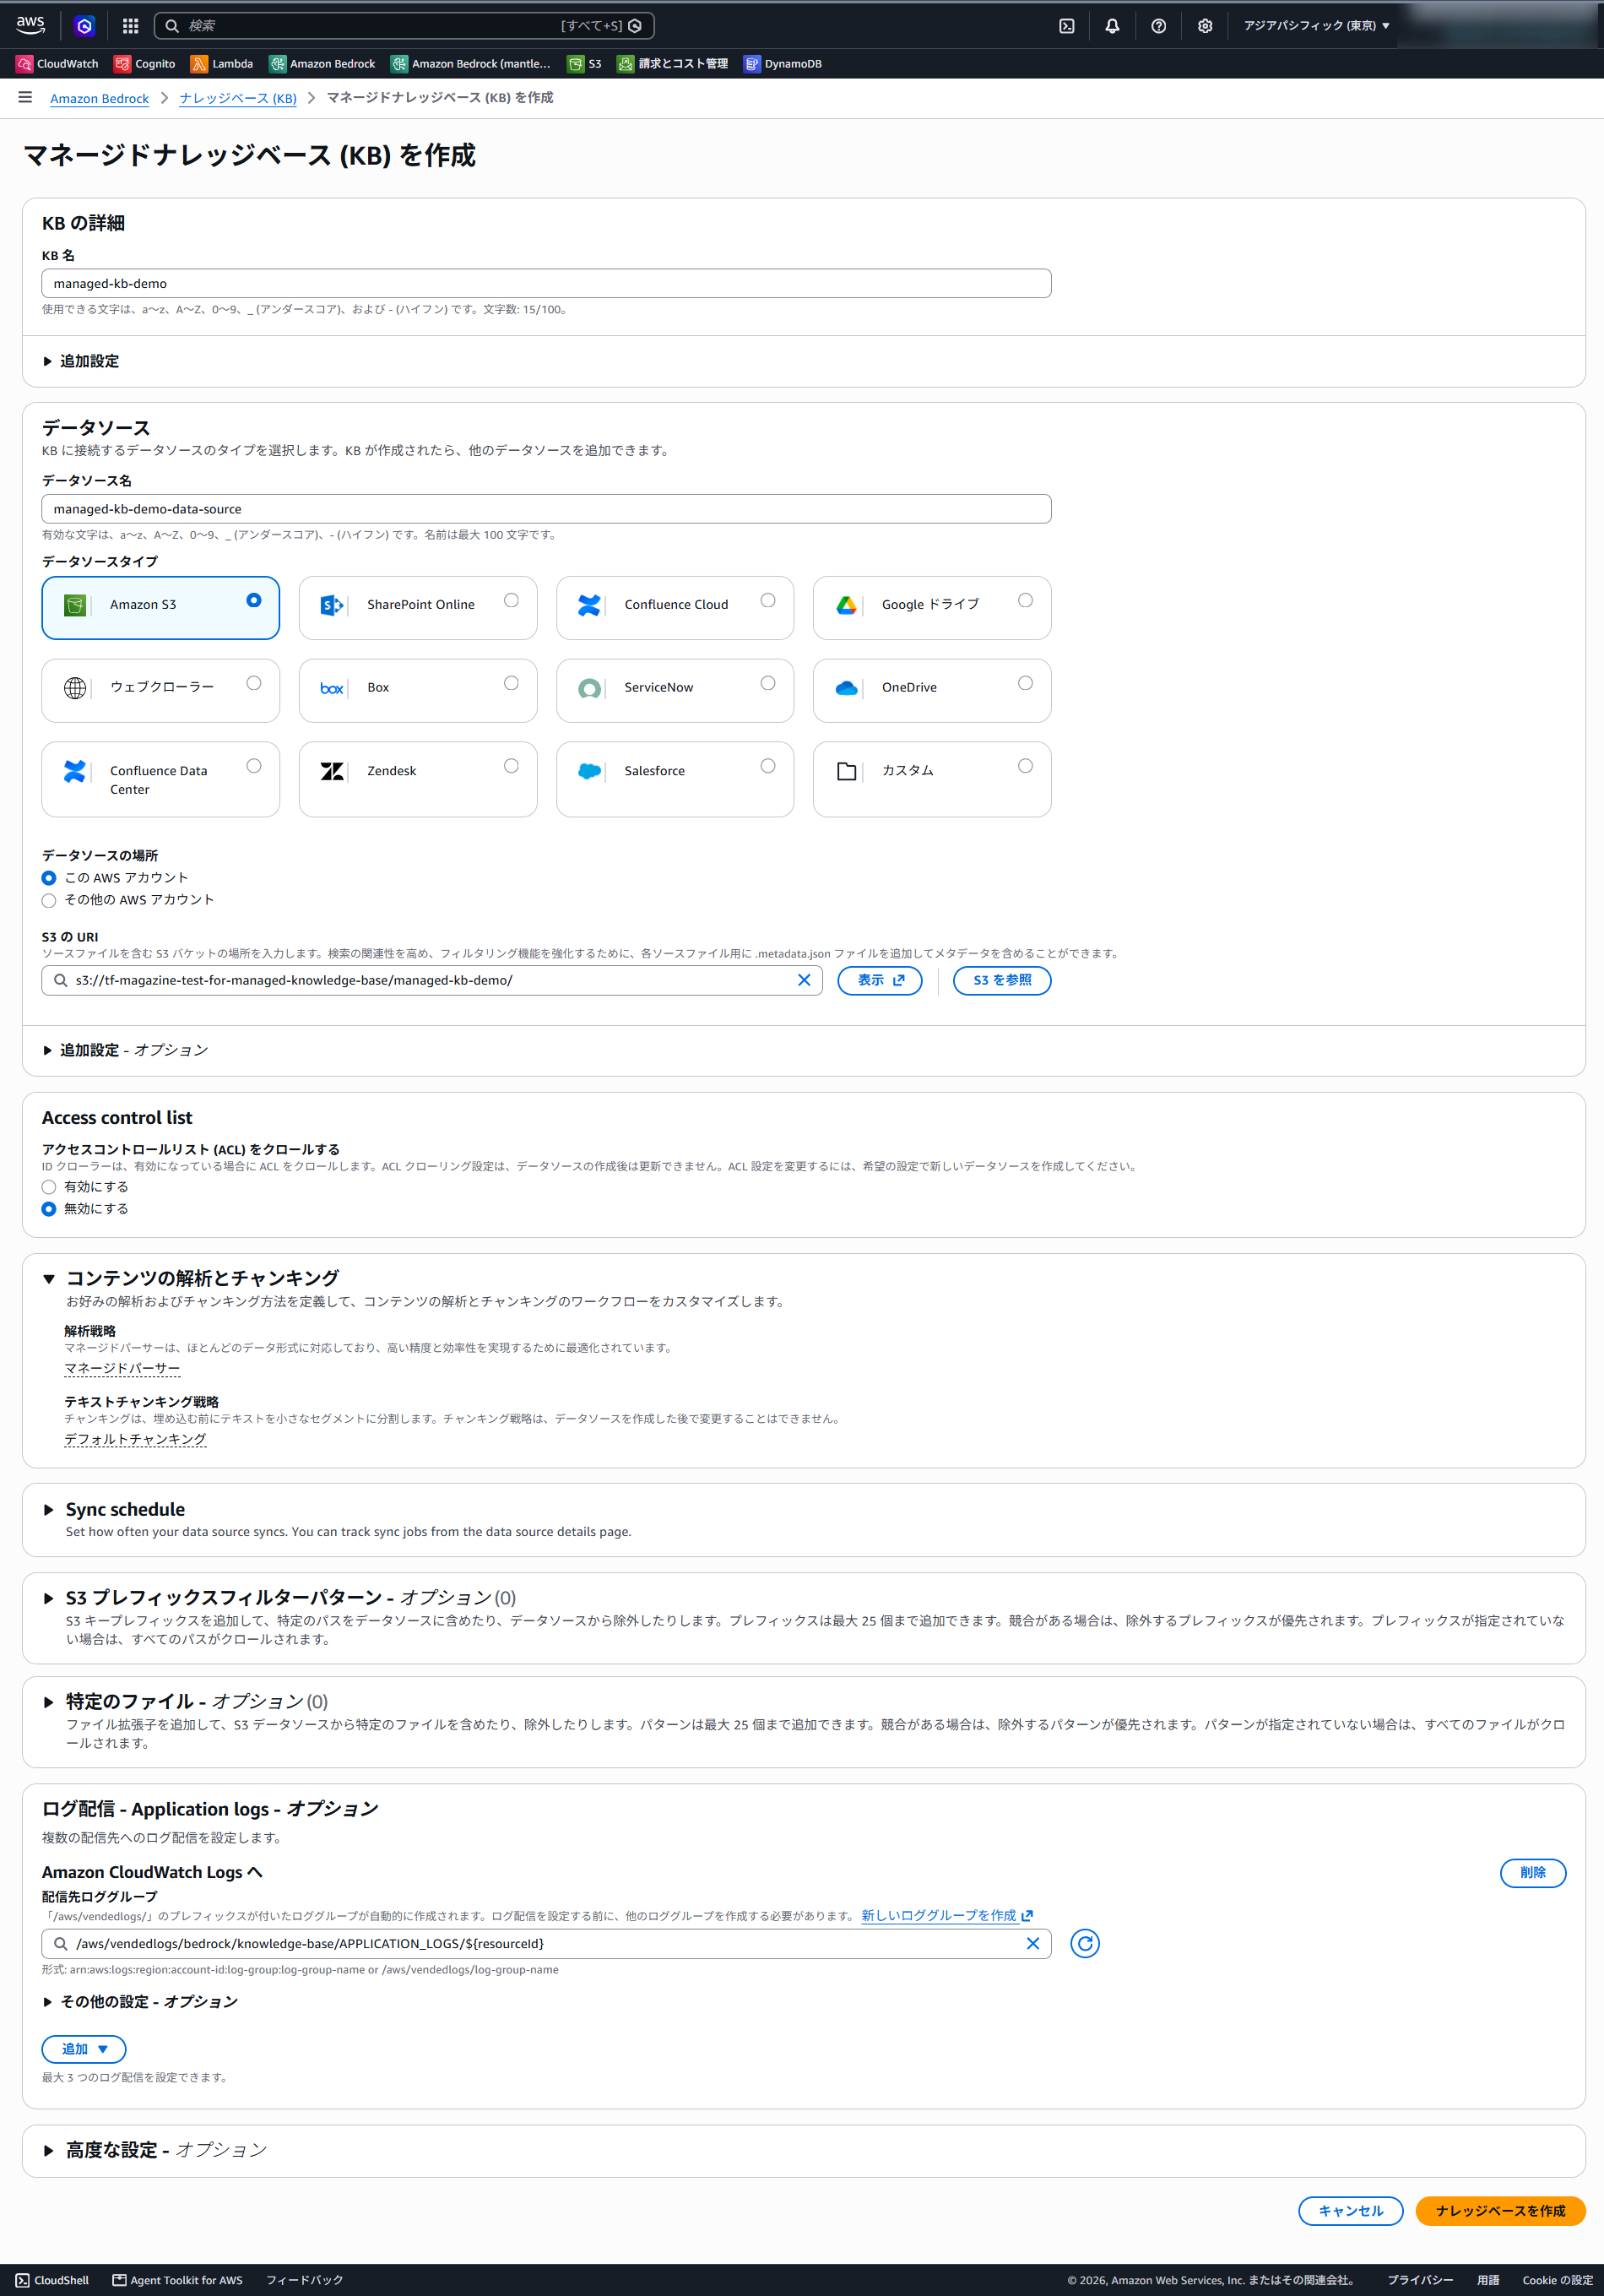
AWSコンソールの「Amazon Bedrock」→「ナレッジベース」から「マネージドKBを作成」を選択します。以下は公式手順に基づく設定案です。画面の表示名は実機確認時に照合します。
| 設定 | 今回の選択 | 理由 |
|---|---|---|
| ナレッジベース名 | managed-kb-demo | 検証用と識別するため |
| データソース名 | managed-kb-demo-data-source | 検証用と識別するため |
| データソースタイプ | Amazon S3 | 既存の文書を利用するため |
| Access control list | 無効にする | 利用者ごとに検索範囲を分けないため |
| 解析戦略 | Managed parser | 標準の解析処理で確認するため |
| チャンク分割 | Default chunking | 文書を検索単位へ分割するため |
| その他 | すべてデフォルト |
S3接続では「このAWSアカウント」を選び、対象バケットのS3 URIを指定します。その際、プレフィックス managed-kb-demo/ まで指定すると、取り込むデータをその範囲に絞れます。共用バケットを指定する場合は、意図しない文書まで取り込まないように対象範囲を確認してください。
設定を確認したら「ナレッジベースを作成」を選び、作成完了を待ちます。
作成したナレッジベースでS3データソースを選び、「Sync」から取り込みを開始します。同期履歴では、完了状態だけでなく、対象文書の処理状況と警告も確認します。APIで状態を取得する場合は、取り込みジョブの状態と文書処理の統計を確認します。
文書を追加・更新した後も同期が必要です。Managedでは同期スケジュールを設定する方法もありますが、このデモでは手動で取り込みます。
作成したナレッジベースを開き、「テスト」からテスト画面を表示します。左側の設定欄の「API」で、検索と回答生成の方式を選びます。
| 方式 | 内容 |
|---|---|
| 回答生成を使用したエージェント型検索 | 質問を分解して検索を繰り返し、集めた結果から回答文を生成する |
| エージェント取得のみ | 同じ方法で検索し、回答文は生成せずに関連する文書の一部を返す |
| 標準検索のみ | 1回の検索で、関連する文書の一部を返す |
| 回答生成を使用した標準検索 | Managedでは選択できない |
最後の「回答生成を使用した標準検索」は、従来のナレッジベースで使うRetrieveAndGenerate APIに相当する方式です。ManagedではRetrieveAndGenerate APIを利用できません。公式APIリファレンスにもこの制限が明記されています。
回答文まで生成する場合は、Agentic RetrievalのAgenticRetrieveStream APIを使います。テスト画面の「回答生成を使用したエージェント型検索」は、このAPIにあたります。
今回は「回答生成を使用したエージェント型検索」を選びます。検索の計画と回答生成に使うモデルは、既定の「マネージドモデル」のままにします。画面には「Claude Sonnet 4.6 またはそれ以上と同等」と表示されます。エージェントの最大反復回数も既定の5です。この方式ではAgentic Retrievalの料金がかかります。
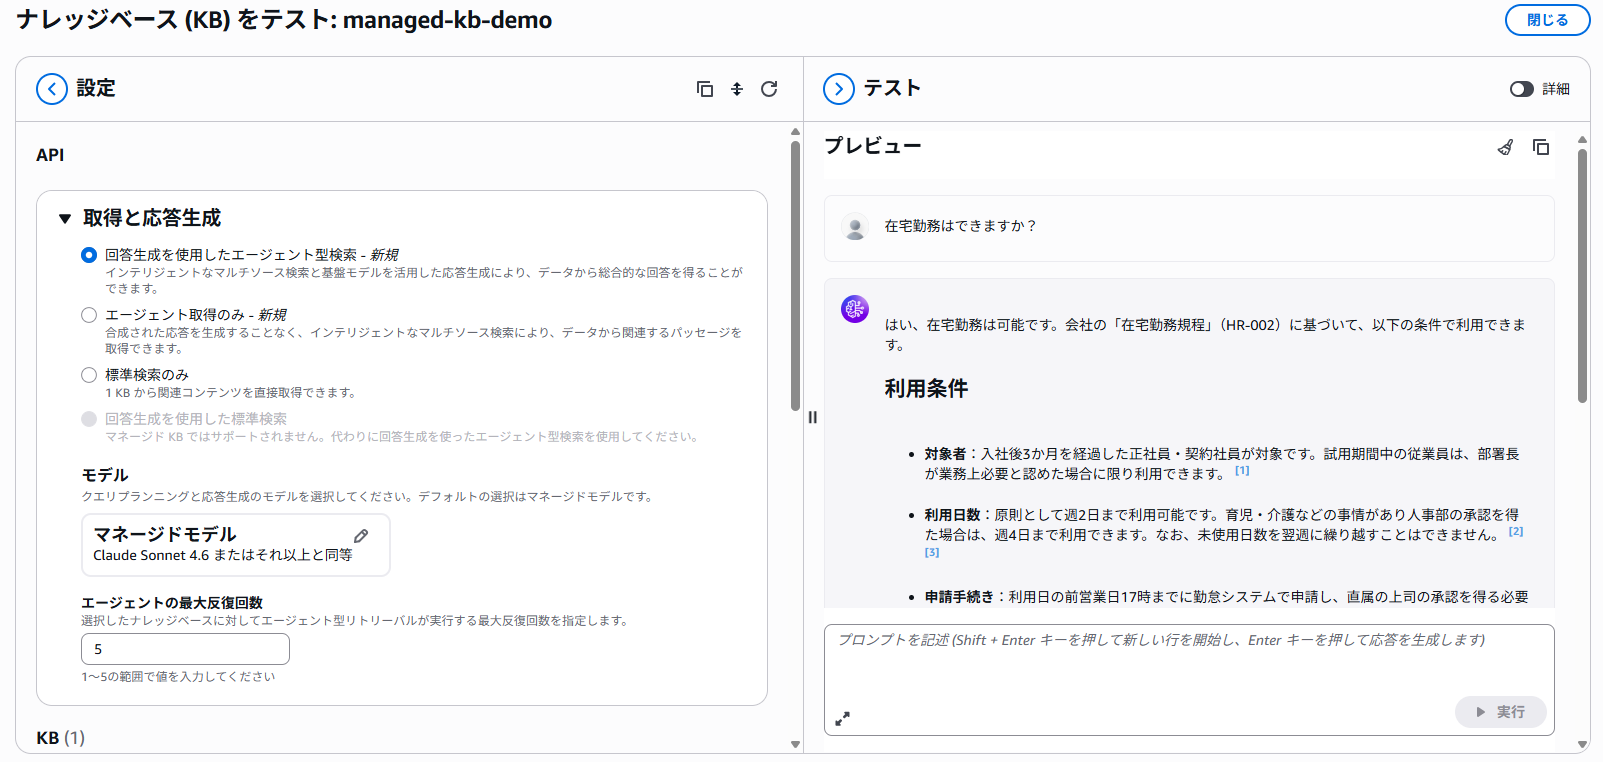
「在宅勤務はできますか?」と質問すると、在宅勤務規程(HR-002)をもとに、利用条件を整理した回答が返されました。対象者、利用日数(原則週2日まで、育児・介護などの事情があれば週4日まで、未使用日数の繰り越しは不可)、申請手続き(利用日の前営業日17時までに申請)が含まれています。回答の各項目には、根拠とした検索結果の番号が付きます。番号を選ぶと元の文書の該当箇所を確認できるので、回答が規程の本文と一致しているかを照合してください。
検証を終えたら、作成したナレッジベースを選び、削除手順と確認画面の注意事項を確認します。既存のS3文書を使った場合、元の業務文書は削除対象に含めません。サンプルだけを置いた場合は、その検証用オブジェクトを必要に応じて削除します。
検証専用に作成したIAMロールやログ保存先も、他の用途で使っていないことを確認して整理します。公式の削除ガイドにはCustomer-managedのベクトルストアに関する説明もあるため、Managedのベクトルストアを別サービスで探して削除する手順へ読み替えないようにしてください。
S3などに文書があり、検索基盤の構築よりも、その文書を回答にどう活用するかに時間をかけたい場合はManagedが候補になります。今回のような標準構成から始め、検索結果を確認していく進め方に合います。
一方、既存のベクトルストアを継続して使いたい場合や、ベクトルストアの構成を細かく制御したい場合はCustomer-managedを検討します。これは機能の優劣ではなく、必要な制御範囲に基づく選択です。
今回の7文書で回答できても、大量のマニュアル、表を含むPDF、似た内容の旧版と新版が混在する環境での品質までは判断できません。
特に、表や図の多い文書には注意が必要です。マネージドパーサーは内容に応じて解析方法を自動で選びますが、内部でどのモデルが使われているかは公開されておらず、解析方法を別のものに切り替えることもできません。図や画像を対象にするには、作成時の「高度な設定」で「ドキュメント内のビジュアルコンテンツ」を有効にする必要があります。図表が期待どおりに読み取られるかは、実際の文書を取り込んで確かめます。
実際の導入では、業務で使う質問と正解の根拠を用意し、必要な文書を検索できるか、回答がその内容と一致するかを別々に確認します。資料の不足、検索の失敗、LLMの読み違いでは、それぞれ対処方法が異なります。評価の考え方は次の記事で整理しています。
既存アプリケーションでは、ナレッジベースIDだけを変更すればよいとは限りません。まず、呼び出しているAPIと検索設定を確認します。
| 確認箇所 | Managedへの切り替えで確認する内容 |
|---|---|
| 回答生成API | RetrieveAndGenerateはAgenticRetrieveStreamなどへ置き換える |
| 検索設定 | 明示的に指定する場合はmanagedSearchConfigurationを使う |
| メタデータ絞り込み | startsWith、stringContainsを使っていないか確認する |
| 予約済みのメタデータ | x-amz-bedrock-で始まる項目名を参照していないか確認する |
| 取り込み | 元データを接続し直し、検索結果を確認する |
メタデータによる絞り込みでは、使える条件が一部異なります。従来のナレッジベースでは、前方一致の startsWith と部分一致の stringContains を、ベクトルストアによっては使えました。startsWith はAmazon OpenSearch Serverlessだけが対応し、stringContains も主にOpenSearch Serverlessで使う条件です。Managedでは、この2つはベクトルストアに関係なく使えません。
たとえば「文書IDが HR- で始まる規程だけを検索する」といった前方一致の絞り込みは、そのままでは移行できません。代わりに equals、greaterThan、lessThan、in、notIn を使います。上の例なら、メタデータに department: "人事部" のような項目を持たせ、equals や in で絞り込むように設計を見直します。従来構成でS3 Vectorsを使っていた場合は、もともとこの2つの条件を使えないため、この点の影響はありません。
サービスが予約しているメタデータの項目名も異なります。従来のナレッジベースでは x-amz-bedrock-kb-source-uri のように x-amz-bedrock で始まる名前でしたが、Managedでは _source_uri や _data_source_id のように _ で始まる名前です。これらの項目で絞り込んだり、アプリケーションで参照元のURIを読み取ったりしている場合は、項目名を書き換えます。
そのほかの検索設定の制約は、Managedの検索仕様に記載されています。同じ文書・質問でも結果が変わる可能性があるため、新しいナレッジベースを検証してからアプリケーションの参照先を切り替えます。
Amazon Bedrock Managed Knowledge Baseは、S3などの既存文書を取り込み、ベクトルストアの選定・管理を含む検索基盤をAWSへ任せられるサービスです。標準の文書解析・埋め込み・リランキングを含め、保存容量と検索回数を軸に費用を見積もれます。
導入前には、次の点を確認してください。
まずはS3などにある文書の中から対象を絞って取り込み、検索結果と回答の根拠を確認するところから始められます。
Tech Funでは、お客様のフェーズに合わせ、生成AI活用に向けた様々な支援をご提供しています。
生成AIに限らず、Web・業務システム開発やインフラ設計など、技術領域を問わずご相談を承っています。「何から始めれば良いか分からない」という段階でも構いませんので、ぜひお気軽にお問い合わせください。